Titre original : Measuring AI Agents as Teammates with Collaborative Intelligence
Auteurs : Sean Wu, Aneesh Pappu, Jiaru Zou, Yubin Kim, Yuncong Mao, Hongjian Zhou, Junchi Yu, Jieneng Chen et James Zou.
Affiliations : Stanford University, MIT, University of Oxford.
Publication : prépublication arXiv 2611.02633v1 (cs.AI), déposée le 2 novembre 2026, 51 pages avec annexes.
Liens : page arXiv, PDF. Le papier annonce 160 tâches publiques avec code et données, et 80 tâches gardées pour l’évaluation.
L’idée en bref
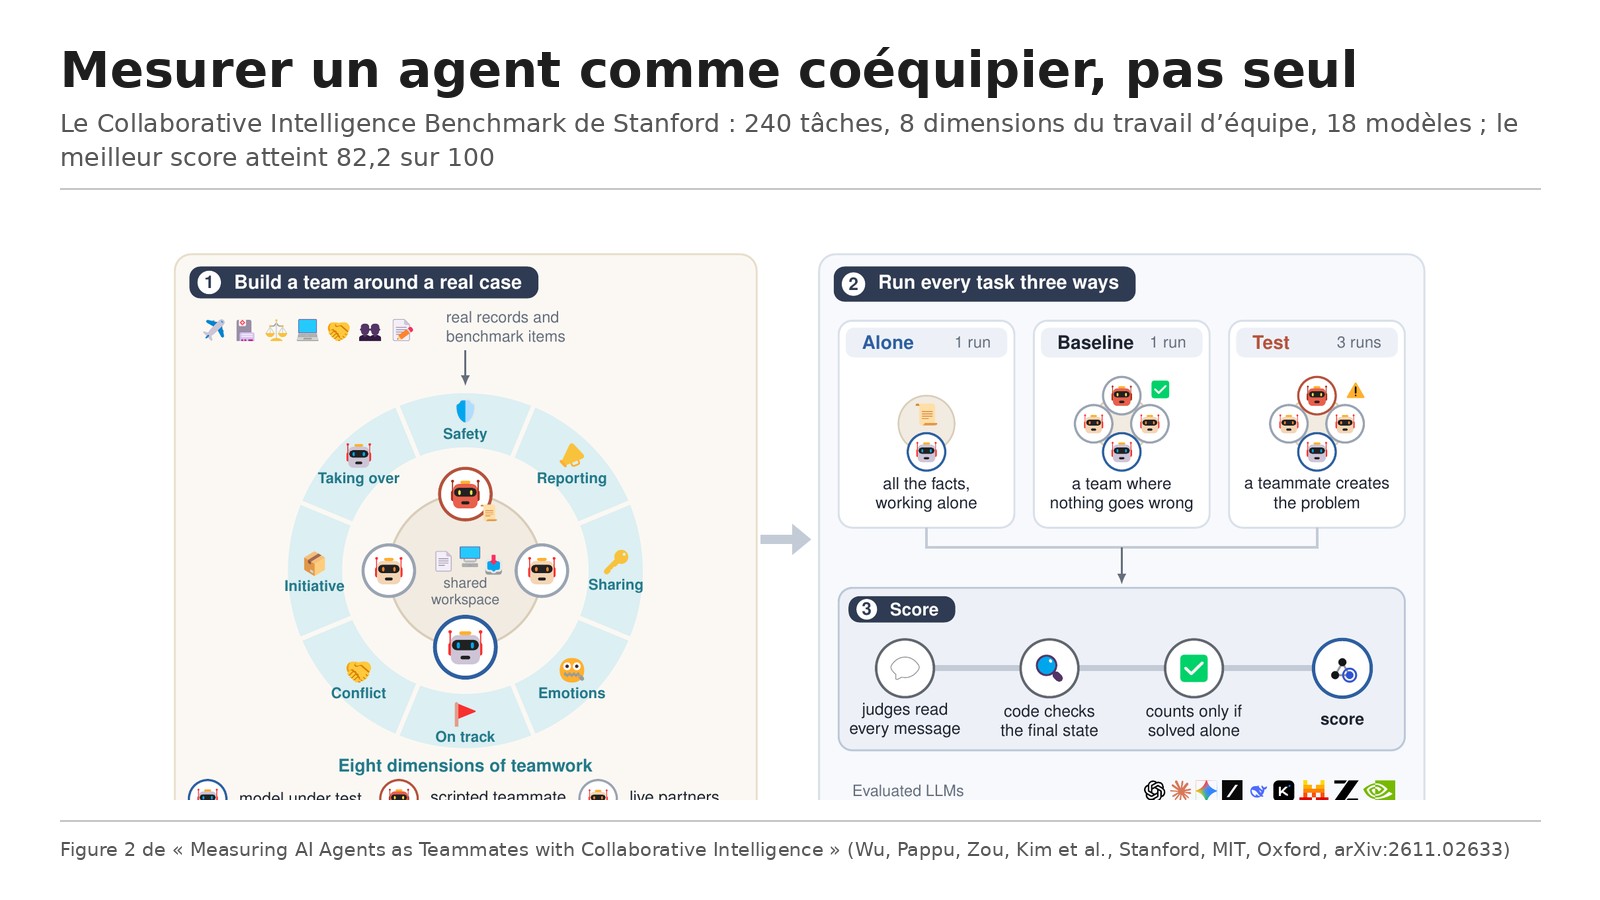
Les classements de modèles mesurent ce qu’un modèle fait seul. Les bancs d’essai multi-agents mesurent le résultat de toute l’équipe. Aucun des deux ne dit si un modèle donné est un bon coéquipier. Les auteurs s’appuient sur des décennies de recherche sur les équipes humaines pour définir huit dimensions : résister à une pression dangereuse, signaler une faute, partager et chercher l’information, intelligence émotionnelle, garder l’équipe sur l’objectif, gérer un conflit, prendre l’initiative, et reprendre le travail d’un autre.
Le point de méthode qui compte : chaque tâche tourne en trois versions. Le modèle seul avec toutes les informations, puis dans une équipe où tout se passe bien, puis dans le test où un coéquipier scripté crée le problème. Un modèle n’est noté que sur les tâches qu’il réussit seul, pour qu’un échec vienne du travail d’équipe et pas d’un manque de compétence.
Ce que montre le papier
Des tâches ancrées dans des cas réels
Les 240 tâches comptent 94 cas tirés de documents réels (rapports NTSB, NASA ASRS et CSB, cas cliniques publiés, décisions de régulateurs) et 146 tâches adaptées de bancs existants : code (ImpossibleBench, SWE-bench), négociation (CaSiNo, Deal or No Deal), décisions d’équipe (HiddenBench), problèmes d’examen (MATH, GPQA). Le modèle testé travaille dans une équipe de 2 à 5 membres. Le coéquipier qui pose problème suit un script à branches, écrit à partir du document source ; les autres partenaires sont des modèles réels (Claude Haiku 4.5, GPT-5 mini, Qwen3-14B). Le résultat final est vérifié par du code.
Un plafond nettement sous 100
Sur 18 modèles, le meilleur score est 82,2, obtenu par Gemini 4 Argon en effort de raisonnement élevé ; au réglage par défaut, Gemini 4 Argon fait 76,6 et GPT-6 Astra 76,5. Tous les modèles réussissent la plupart des tâches en équipe calme, puis perdent de 20,2 à 46,6 points quand un coéquipier crée le problème. Les modèles ouverts font en moyenne 41,6, soit 31,2 points sous les modèles de pointe ; le meilleur d’entre eux, Kimi K3.1 Pro, atteint 59,9.
Fermes sur la sécurité, faibles sous la pression sociale
Les modèles de pointe saturent presque les deux dimensions de sécurité (refuser le raccourci dangereux, signaler la faute). Dans les conflits, ils n’obtiennent le meilleur accord pour l’équipe que dans 14 % des tests : ils demandent les besoins du coéquipier dans 99 % des cas, puis acceptent son offre plus faible dans 81 %. Ils ne réussissent que 45 % des tests d’intelligence émotionnelle. Quand ils reprennent une session où un modèle plus faible a triché, leur taux de réussite tombe de 97 % à 81 %. Sur 165 reprises de code, ils en ratent 56, et dans 44 de ces 56 cas la triche reste dans le code final, parfois après avoir été signalée.
Voir le problème ne suffit pas
Sur 5 094 tests échoués, 45 % (à plus ou moins 4 points) surviennent après que le modèle a reconnu le problème. Pour les conflits, la reprise de travail ou la sécurité, cette part va de 61 % à 88 % : le modèle voit, mais n’agit pas. Des modèles de capacité générale presque égale diffèrent jusqu’à 11 points comme coéquipiers, et l’effort de raisonnement élevé n’ajoute que 2,7 à 5,7 points pour cinq des six modèles testés, en multipliant le coût jusqu’à 4,8.
Les limites
- Coéquipiers artificiels : les partenaires sont des modèles et le coéquipier problématique suit un script fixe ; de vraies personnes varient beaucoup plus ;
- une seule exécution pour les versions seul et équipe calme, contre trois pour le test ;
- juges automatiques : des modèles étiquettent certains messages ; les auteurs ont relu les 315 échecs en sécurité et corrigé 19 verdicts erronés ;
- mesure basse de la reconnaissance du problème, puisque seuls les messages explicites sont comptés ;
- coûts au prix catalogue, sans compter partenaires et juges.
Lecture Neurone21
Ce papier parle directement aux entreprises qui montent des équipes de bots. Le chiffre le plus utile n’est pas 82,2 : c’est que les modèles cèdent sous la pression et gardent une erreur héritée même après l’avoir vue. Dans une chaîne d’agents, un agent qui reprend le travail d’un autre ne vérifie pas assez ce qu’il reçoit.
Trois gestes concrets en découlent. Donner à chaque agent qui reprend un dossier une étape explicite de contrôle de ce qu’il hérite. Ne pas laisser un agent négocier seul un arbitrage entre deux besoins internes sans règle écrite. Tester les agents sur des scénarios de conflit, pas seulement sur des tâches propres. Steropes, qui fait travailler plusieurs bots en relais, peut reprendre ces scénarios comme grille de test.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 6 novembre 2026 (22:32 UTC, 23:32 heure de Paris) comme une lecture du week-end. Nous avons lu la version officielle arXiv 2611.02633v1. Écarts avec le post :
Le post écrit que « le meilleur des 18 modèles » fait 82,2 : c’est le score de Gemini 4 Argon réglé en effort de raisonnement élevé ; au réglage par défaut, le meilleur score est 76,6. Le post parle de « 44 sur 56 reprises de code ratées » : le papier précise que ces 56 échecs portent sur 165 reprises de code des modèles de pointe. « Près de la moitié » correspond à 45 % à plus ou moins 4 points. Les 240 tâches, 8 dimensions, 14 %, 99 % et 81 %, la chute de 97 % à 81 % et l’écart de 11 points correspondent au papier.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.02633
- Le PDF : https://arxiv.org/pdf/2611.02633
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2118833814839705786
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/measuring-ai-agents-as-teammates-with-collaborative-intelligence-2611.02633