Titre original : AutoRefine: Auto-Calibrating Code Judges from Workflow Outcomes
Auteurs : Shervin Shahidi et James Poon (contribution égale), Hang Xie, Kenneth O. Xu, Robin Håkanson, Vikram Nair, Jens Pillgram-Larsen et Nachiappan Nagappan.
Affiliation : Meta Platforms.
Publication : prépublication arXiv 2611.09291v1 (cs.AI), déposée le 6 novembre 2026.
Liens : page arXiv, PDF.
L’idée en bref
Les agents de code produisent beaucoup de changements que nul test ne peut valider : refactorisations, optimisations, nettoyages. Pour décider lesquels montrer aux relecteurs humains, de plus en plus d’équipes confient le tri à un juge, un grand modèle de langage guidé par une consigne. Mais cette consigne doit être calibrée pour la tâche, puis recalibrée chaque fois que l’agent, le modèle ou le code changent. L’étiquetage manuel coûte cher et vieillit vite, si bien que beaucoup de consignes de juge ne sont jamais vérifiées.
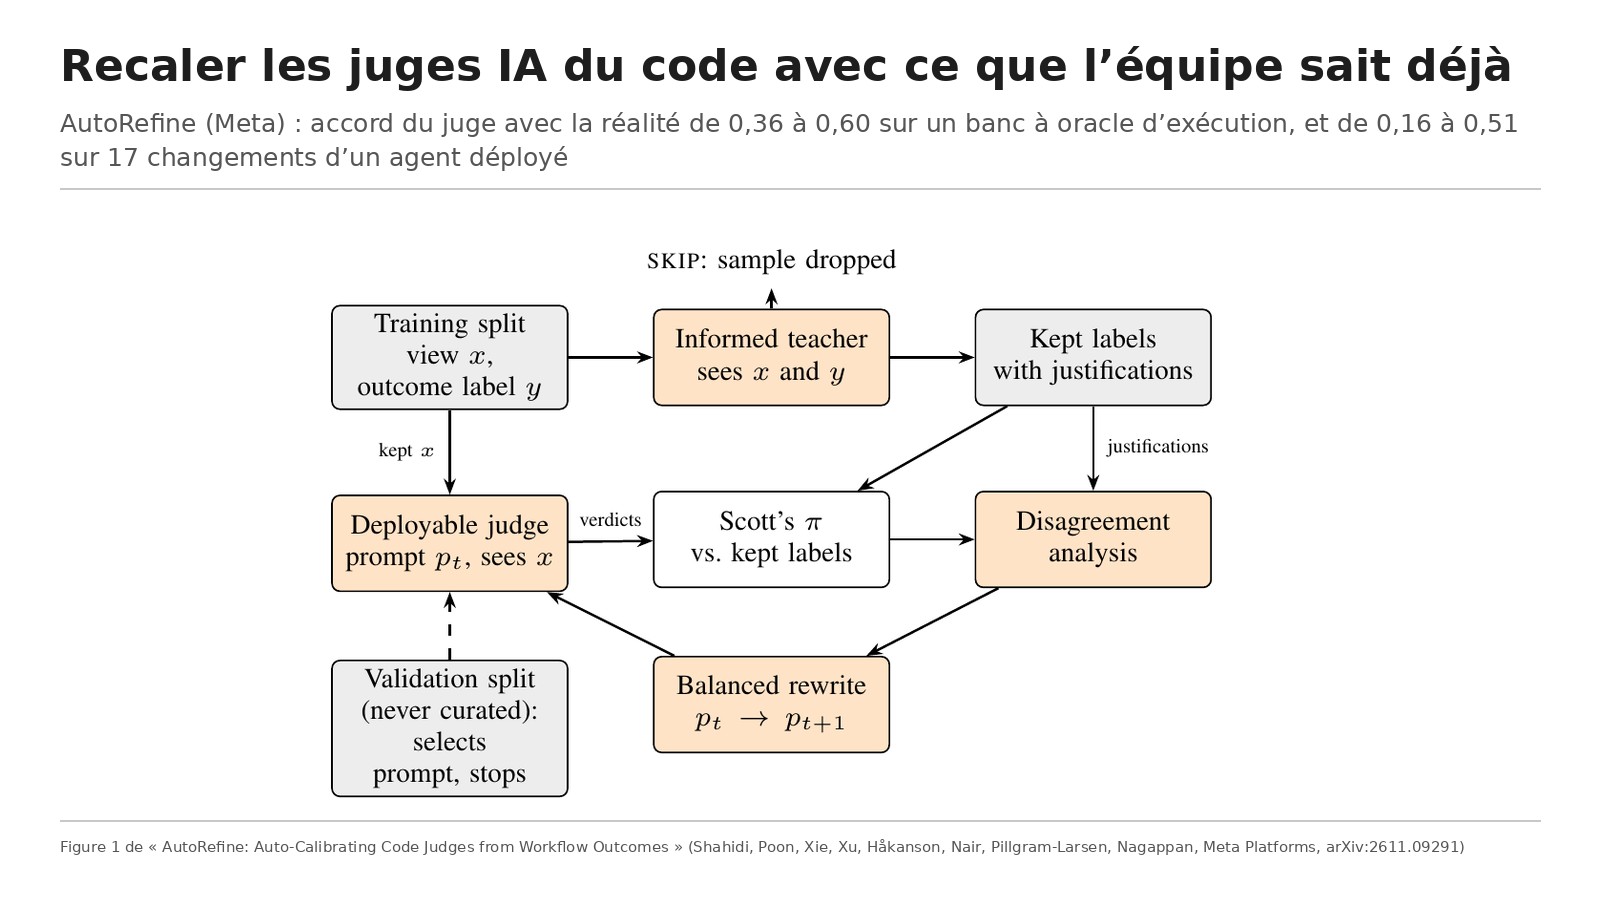
L’équipe de Meta propose d’utiliser les signaux que le flux de développement produit déjà gratuitement : les tests passent ou échouent, les changements sont fusionnés ou abandonnés. Ces étiquettes sont bruitées, car un abandon peut tenir à une question de périmètre ou à un pipeline cassé, pas au code. AutoRefine ajoute donc un « professeur informé » qui voit ce que voit le juge plus le résultat réel. Il justifie chaque étiquette qu’il garde, et s’abstient quand le résultat ne s’explique pas à partir de ce que le juge voit.
Ce que montre le papier
Une boucle qui réécrit la consigne
La consigne du juge joue le rôle des paramètres à optimiser. À chaque tour, le juge note les exemples d’entraînement, on mesure son accord avec les étiquettes par le pi de Scott, qui corrige l’accord dû au hasard (un juge qui répond toujours la classe majoritaire tombe à zéro ou en dessous). Pour chaque désaccord, un modèle (Claude Opus 4.7) propose des modifications de la consigne, avec une contrainte d’équilibre : toute nouvelle raison de rejeter doit s’accompagner d’une raison d’accepter, pour éviter un juge qui finit par tout refuser. Une partie de validation jamais filtrée choisit la consigne finale, en cinq tours au plus dans les essais.
Avec des étiquettes fiables
Sur un banc tiré de changements réels d’un monorepo industriel, avec des tests qui valident ou non chaque correctif, un agent (Claude Opus 4.6) a tenté 579 tâches, dont 417 retenues. Sur 85 tâches de test comptant 13 échecs, le juge à grille (Claude Opus 4.8) passe d’un pi de 0,36 à 0,60 après calibration. Le simple réglage du seuil ne l’explique pas : sans calibration, le meilleur seuil choisi sur le test lui-même ne donne que 0,42. Le juge binaire, lui, détecte presque deux fois plus d’échecs (rappel de 0,38 à 0,73) au prix de la précision (0,80 à 0,53), pour un pi de 0,46 à 0,54.
Quand on retire au juge le correctif de référence, la boucle n’atteint plus que 0,35. Le professeur s’abstient alors sur 12 des 13 échecs de validation et sur aucun des 72 succès, toujours pour la même raison : le correctif paraît juste et l’erreur n’est visible que dans les tests cachés. Deux équipes d’ingénieurs, en relecture à l’aveugle de 56 tâches, ont elles aussi manqué presque tous ces échecs.
Sur un agent déployé
Pour mesurer le tri du bruit, l’équipe a inversé au hasard 25 % des étiquettes. Sur les 185 changements de calibration d’un agent d’optimisation de performance, le professeur a écarté 13 des 24 changements fusionnés présentés à tort comme abandonnés, contre 16 des 73 vrais abandons ; le bruit passe de 24,9 % à 20,4 %. Sur 512 changements réels, il s’abstient sur 60 % de ceux abandonnés après revue, 32 % des brouillons et 5,5 % des fusionnés : souvent, la raison de l’abandon n’est pas dans le code.
Le juge recalibré (v2) a remplacé l’ancien (v1) dans le flux interne. Sur 17 changements récents jamais vus, son pi passe de 0,16 à 0,51 et il accepte 8 des 8 changements fusionnés au lieu de 6. Sur 43 changements récents, le rappel des fusionnés monte de 12 sur 20 à 18 sur 20, l’objectif de 0,90 fixé pour le déploiement. Sur 16 changements plus anciens, en revanche, l’ancien juge reste devant (0,50 contre -0,02).
Les limites
Les auteurs les listent eux-mêmes. Les résultats du flux servent de substitut à la qualité du code, et l’abstention peut écarter de vrais échecs qui ont l’air propres. Juge et professeur viennent de la même famille de modèles, avec un risque de complaisance ; dans les essais, le professeur a repéré des correctifs justes étiquetés en échec, mais pas l’inverse. Tout vient d’une seule entreprise, et l’étude fusion ou abandon d’un seul agent. Les échantillons sont petits : l’intervalle de confiance du gain sur les 17 changements va de 0,00 à 0,74, et chaque boucle n’a tourné qu’une fois par réglage.
Lecture Neurone21
Pour une entreprise qui met un juge IA en barrière qualité, le message est concret : un juge n’est fiable que pour la version de l’agent sur laquelle on l’a calibré. Le résultat sur les changements anciens, où le juge recalibré fait moins bien que l’ancien, le montre. Il faut donc prévoir un recalibrage à chaque évolution de l’agent, et le papier montre qu’on peut l’alimenter avec ce qu’on a déjà : tests, fusions, abandons.
Le taux d’abstention du professeur est sans doute l’idée la plus utile. Quand il monte, ce n’est pas la consigne qu’il faut retoucher, c’est l’information donnée au juge qui manque. Les auteurs conseillent aussi de demander aux relecteurs d’écrire pourquoi ils abandonnent un changement, et de vérifier ce que veut dire une étiquette à chaque étape : un brouillon jeté n’est pas un refus de relecteur.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 10 novembre 2026 à 21:35 heure de Paris, puis a reposté son propre post le 11 novembre à 09:40 heure de Paris. Nous avons lu la version officielle arXiv 2611.09291v1. Écarts avec le post :
Le chiffre du post, un accord qui passe de 0,16 à 0,51, est bien dans le papier, mais il s’agit du pi de Scott, un accord corrigé du hasard, mesuré sur 17 changements seulement, avec un intervalle de confiance de 0,00 à 0,74. Le post ne dit pas que, sur 16 changements plus anciens, l’ancien juge reste meilleur, ni que juge et professeur sont des modèles Claude de la même famille.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.09291
- Le PDF : https://arxiv.org/pdf/2611.09291
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2120253922933956644
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/autorefine-auto-calibrating-code-judges-from-workflow-outcomes-2611.09291