Titre original : BoxBox: Recursive Harness Self-Improvement for Long-Running Performance Optimization
Auteurs : Yuhao Tan, Hanyun Jiang, Fangkai Yang, Yuan Yao, Taolue Chen, Bo Qiao, Yu Kang, Lu Wang, Pu Zhao, Xiaoxing Ma et Qingwei Lin.
Affiliations : Nanjing University, Zhejiang University, Birkbeck (University of London) et Microsoft. Une note du papier précise que le travail a été réalisé chez Microsoft pour une partie des auteurs.
Publication : prépublication arXiv 2611.09218v1 (cs.SE), déposée le 6 novembre 2026.
Liens : page arXiv, PDF, page du projet.
L’idée en bref
Le harnais d’un agent, c’est tout le code autour du modèle : les outils qu’il peut appeler, ce qu’il voit en retour, la gestion de sa mémoire, ses consignes. On sait qu’un meilleur harnais améliore nettement un agent à modèle constant, et plusieurs méthodes l’optimisent déjà, mais hors ligne : on l’ajuste sur des tâches dont on connaît la réponse, puis on le réutilise tel quel.
Les auteurs visent un autre cas, celui des tâches longues et ouvertes, sans réponse de référence, où des difficultés imprévues apparaissent en cours de route. Leur proposition, BOXBOX (du nom de l’appel radio de Formule 1 qui demande un arrêt au stand), laisse l’agent décider lui-même quand s’arrêter pour corriger son harnais, puis reprendre la tâche là où il l’avait laissée.
Ce que montre le papier
PerfRace, un banc tiré de vrais projets
Pour mesurer ce cas, l’équipe construit PerfRace : il s’agit d’accélérer de vrais projets logiciels sur une charge de travail fixe, sans casser leur fonctionnement. Elle part de 103 475 projets GitHub touchés par des agents de code entre mai et août 2026, en garde 7 257 après des vérifications automatiques (licence, accès, taille), puis 239 après une évaluation par GPT-5.6-Luna. Au bout d’une vérification menée à deux par un agent et un humain, il reste 100 tâches, chacune ayant demandé en moyenne 9,1 heures de préparation et 11,35 dollars d’agent. Elles couvrent sept domaines, des outils de développement (30 tâches) à la sécurité (6). Un juge isolé vérifie chaque proposition dans un conteneur séparé, avec des tests cachés, pour limiter la triche.
Un arrêt au stand géré par un noyau
L’agent dispose d’un outil boxbox(). Quand il l’appelle, un noyau séparé suspend la tâche en conservant tout le contexte (historique, terminal, fichiers), lance une session de revue où l’agent relit sa trajectoire et modifie le harnais, valide ces changements, puis recharge le nouveau harnais à chaud. Si la nouvelle version échoue, le noyau garde l’ancienne. Toutes les révisions sont suivies dans Git, ce qui permet aux revues suivantes de juger les précédentes.
Les résultats
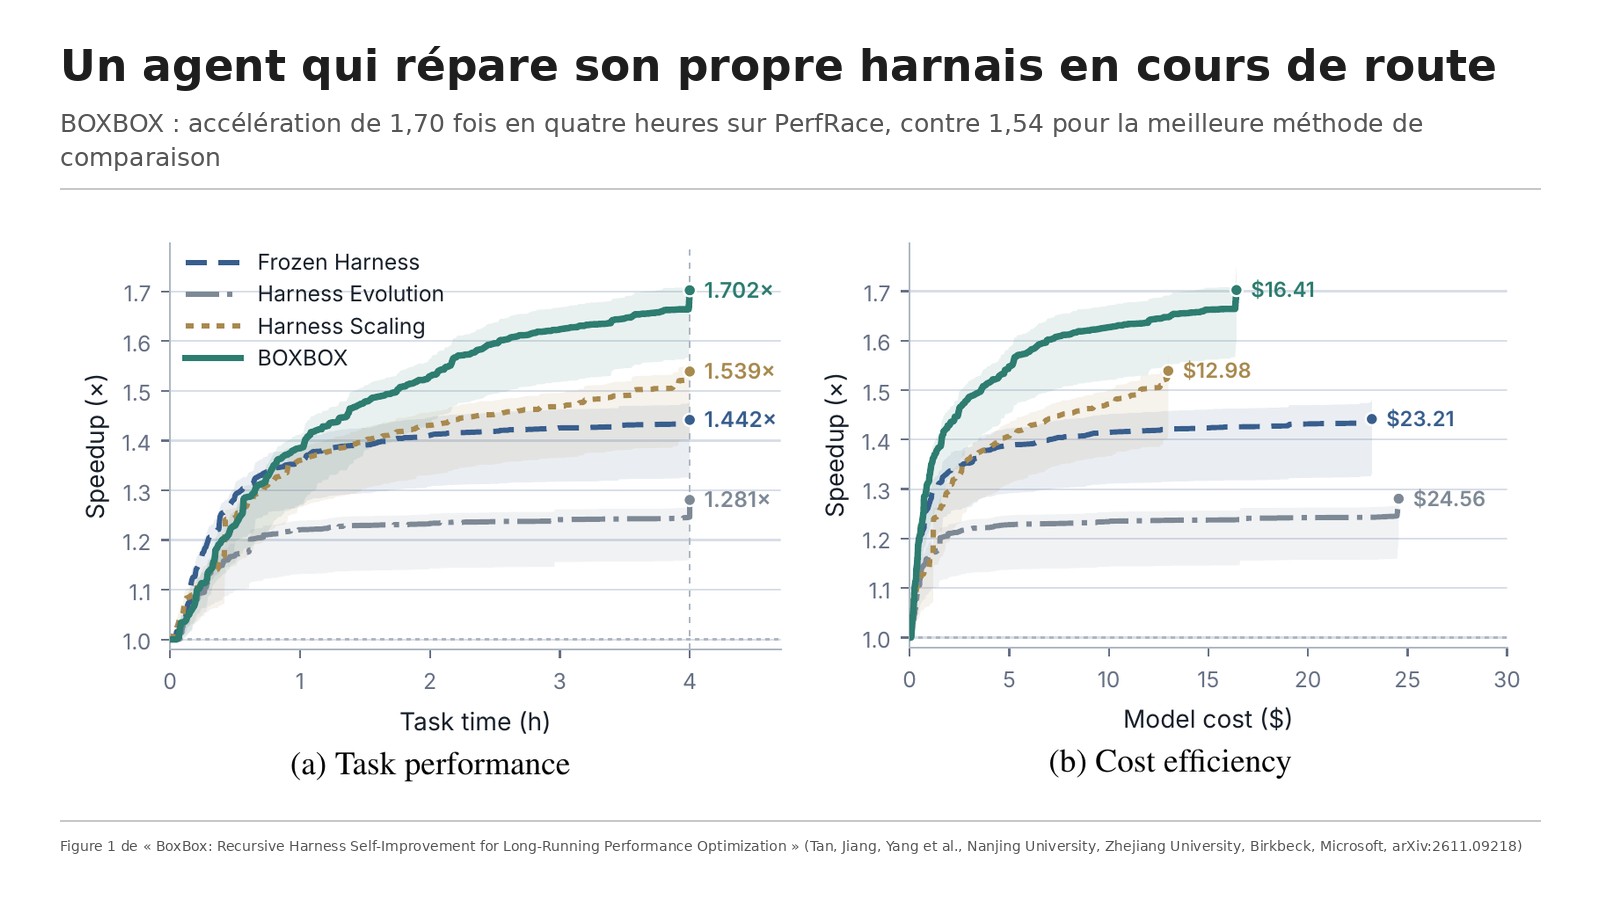
Sur 50 tâches de test, avec trois exécutions de quatre heures par tâche et le modèle GPT-5.6 Luna, BOXBOX atteint une accélération de 1,702 fois, contre 1,539 pour Harness Scaling (un contrôleur externe qui révise le harnais entre deux tentatives), 1,442 pour le harnais figé et 1,281 pour Harness Evolution, l’optimisation hors ligne, qui fait donc moins bien que de ne rien changer. Le coût moyen par exécution est de 16,43 dollars pour BOXBOX, 12,98 pour Harness Scaling, 23,22 pour le harnais figé et 24,56 pour Harness Evolution. Les revues ne prennent qu’une part médiane de 2,1 % du temps et 13,8 % du coût, avec une médiane de cinq revues par exécution.
Deux ablations, sur 14 tâches, confirment les choix : des revues imposées toutes les 30 minutes donnent 1,508 au lieu de 1,584, et une révision limitée à certaines parties du harnais donne 1,349.
Les limites
Les auteurs consacrent une section aux risques : un agent qui modifie son propre code d’exécution peut affaiblir des garde-fous ou introduire des failles, d’autant qu’il manipule du code venu de dépôts non fiables. Ils présentent BOXBOX comme un prototype de recherche, pas comme un cadre prêt pour la production, qui demanderait bac à sable, contrôle d’accès, revue de sécurité et validation humaine des changements.
Nos réserves : un seul modèle a été testé, GPT-5.6 Luna, qui sert aussi à filtrer les tâches du banc. Les ablations portent sur 14 tâches seulement. Harness Scaling reste la méthode la moins chère par exécution ; BOXBOX n’est plus efficace que sur l’indicateur d’accélération par dollar calculé tâche par tâche. Enfin, le banc et la méthode viennent de la même équipe.
Lecture Neurone21
Pour une entreprise qui fait tourner des agents longtemps (migration de code, optimisation, traitement de dossiers), deux enseignements se dégagent. Le premier est négatif et utile : un harnais optimisé une fois pour toutes sur d’autres tâches peut faire moins bien que le harnais de départ. Le second : laisser l’agent corriger ses outils en cours de route, avec un mécanisme de retour arrière, a fait progresser le résultat et baisser le coût par rapport au harnais figé.
Cela suppose une discipline que beaucoup de déploiements n’ont pas encore : historique de chaque changement, validation avant activation, possibilité de revenir à la version précédente. Sans ces garde-fous, un agent qui se modifie lui-même est un risque, ce que les auteurs écrivent aussi.
D’où vient ce papier
DAIR.AI (@dair_ai) l’a présenté le 9 novembre 2026 à 21:15 heure de Paris, et Elvis Saravia (@omarsar0) a reposté ce post à 23:16 heure de Paris. Nous avons lu la version officielle arXiv 2611.09218v1. Écarts avec le post :
Les chiffres du post sont ceux du papier : 1,70 fois à quatre heures contre 1,54 pour la meilleure méthode comparée. Le post parle d’un travail « de Microsoft et de collègues » ; les universités de Nanjing, Zhejiang et Birkbeck sont co-autrices, et les deux premiers auteurs sont rattachés à Nanjing et Zhejiang. Il ne précise pas qu’un seul modèle a été testé, que la méthode comparée la plus proche coûte moins cher par exécution, ni que les auteurs réservent BOXBOX à la recherche.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.09218
- Le PDF : https://arxiv.org/pdf/2611.09218
- La page du projet : http://aka.ms/boxbox
- Le post DAIR.AI reposté par Elvis Saravia : https://x.com/dair_ai/status/2119886501421167042
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/boxbox-recursive-harness-self-improvement-for-long-running-performance-optimizat-2611.09218