Titre original : CompoundingKernel: Self-Improving from Zero to First
Auteurs : Qian Qu (auteur correspondant), Hongyang Wang, Wenbo Chen, Yichuan Li, Jingguo Liu, Xian Li, Xuan Wang, Ruochen Wen, Leo Fan, Yiming Yan, Zheshen Wang et Benoit Dumoulin.
Affiliations : Amazon.
Publication : rapport technique déposé sur arXiv le 14 novembre 2026 (2611.19230v1, 47 pages avec annexes). Le code et les noyaux ne sont pas encore publiés : les auteurs annoncent leur diffusion (boucle de recherche, interface avec le benchmark, vérifications, exemple de configuration, mais pas les prompts des agents). Un espace Hugging Face liste déjà les 235 problèmes.
Liens : page arXiv, PDF, espace Hugging Face.
L’idée en bref
Un noyau (kernel) est le programme qui exécute une opération sur un GPU. Plus il est rapide, moins un même calcul d’IA consomme de temps machine. Sur la génération Blackwell de NVIDIA, les chemins rapides passent par des instructions et des moteurs de copie récents que les bibliothèques ne couvrent pas encore pour la plupart des opérations fusionnées ou en basse précision. Écrire un tel noyau revient à chercher : essayer, mesurer, corriger, recommencer.
CompoundingKernel organise cette recherche avec des agents. Pour chaque problème, une archive extérieure au modèle conserve tous les noyaux corrects et leur filiation. Un contrôleur (un LLM) la relit, choisit un noyau à améliorer ou une conception nouvelle, et donne à chaque agent enfant une seule direction à explorer. L’enfant modifie, compile et chronomètre sur une B200 ; des vérifications extérieures au modèle décident si le résultat est correct. Tous ces agents tournent sur Claude Opus 5.5, qui reste le même du début à la fin.
Ce que montre le papier
Le banc d’essai
SOL-ExecBench est le benchmark public de NVIDIA pour les noyaux écrits par des agents : 235 problèmes tirés de 124 modèles réels, répartis en quatre collections (94 opérations simples en L1, 82 opérations fusionnées en L2, 33 en quantification, 26 issues de FlashInfer-Bench). Chaque noyau est noté entre la version PyTorch optimisée de NVIDIA (0,5) et le temps d’un noyau parfait à la limite physique de la puce (1). Le site vérifie et chronomètre lui-même chaque soumission sur sa propre B200.
Premier sur trois classements, au 11 novembre 2026
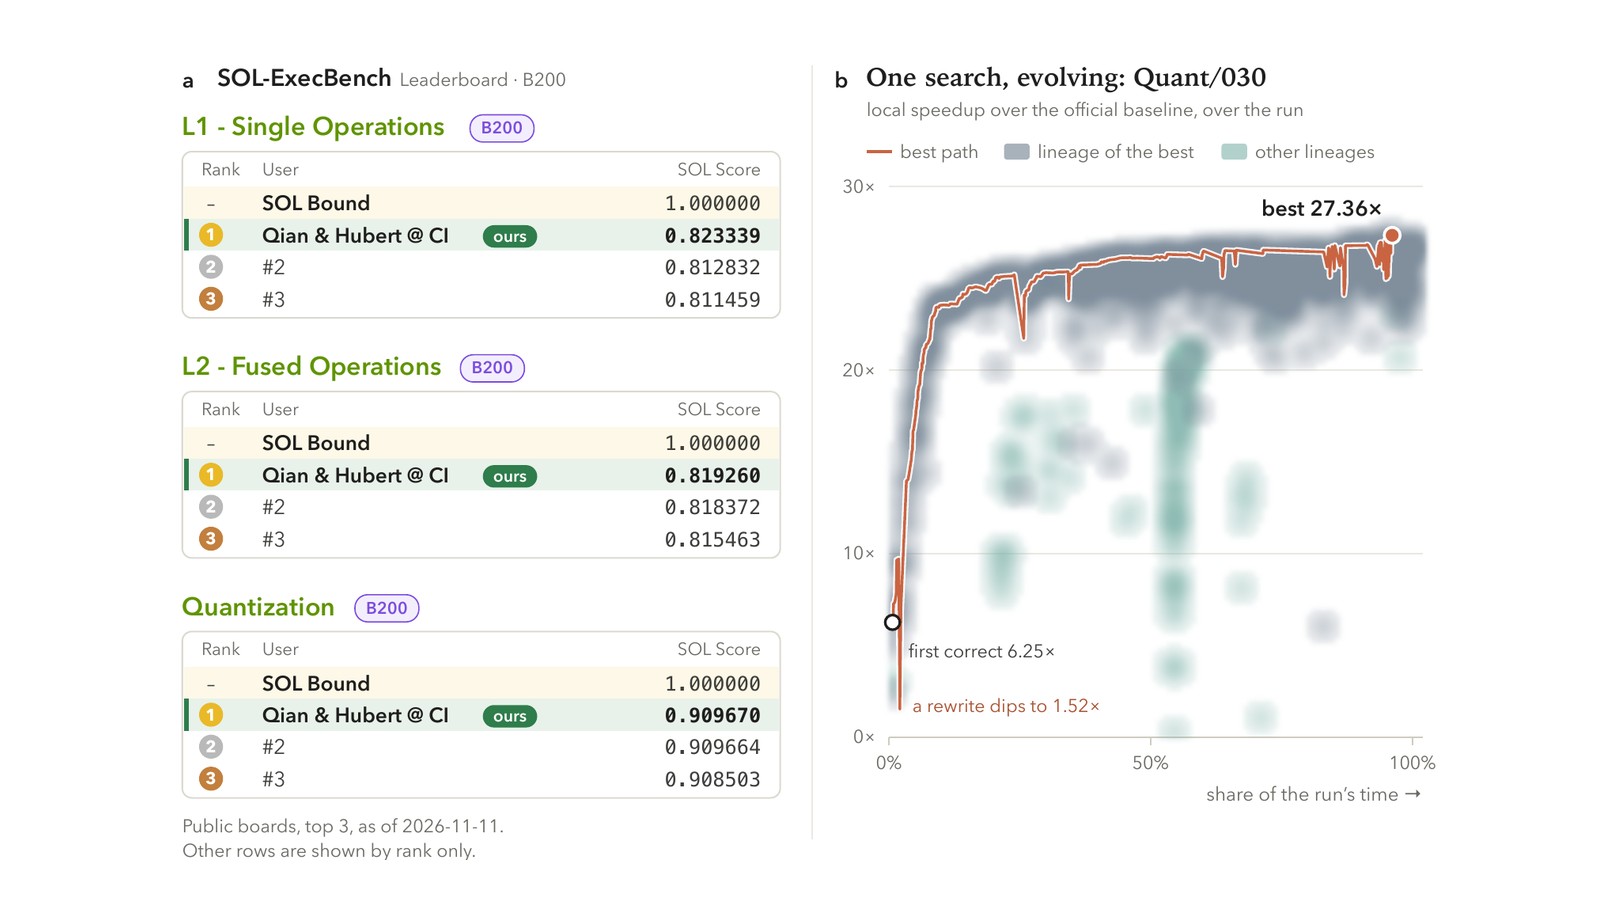
À cette date, CompoundingKernel est premier des classements publics L1 (0,823339), L2 (0,819260) et Quantization (0,909670). Les 235 problèmes ont un noyau marqué correct par le site ; ceux de FlashInfer-Bench ont été soumis en privé et leurs résultats ne sont pas publiés. Sur les 209 problèmes publics, les noyaux sont 4,40 fois plus rapides que la référence en moyenne géométrique (médiane 3,78), avec 9,19 en quantification. L’équipe est première sur 89 problèmes pris un par un et dans les dix premiers sur 193. La première place n’a pas été constante : d’autres équipes sont passées devant en L2 le 7 novembre et en quantification les 27 octobre et 8 novembre, avant que l’équipe ne rende publiques davantage de ses lignes le 10 novembre.
Des noyaux écrits comme par des spécialistes
Sur 235 noyaux finaux, 214 sont en CUDA C++, 13 en CuTe DSL, 6 en Triton et 2 mixtes. La médiane tourne autour de 7 000 lignes, 221 dépassent les 1 000 lignes, 77 % mentionnent les instructions tensorielles propres à Blackwell (comptage sur le texte du code). Les points faibles sont identifiés : les multiplications de matrices classiques et les couches complètes restent loin de la limite physique, 16 problèmes publics sont hors du top 10, et deux finissent plus lents que la référence (0,30 et 0,96 fois).
Le goulot, c’est la mesure, pas le nombre d’agents
Plus d’un millier de sessions d’agents ont tourné en même temps au pic, et 98,4 % des candidats évalués étaient corrects. Au début, les GPU n’étaient occupés qu’à 13 % environ alors que tous les verrous étaient pris : chaque verrou couvrait aussi la compilation et un démarrage de shell de 12 à 15 secondes. Un redémarrage du système qui a sorti la compilation du verrou (avec d’autres changements) a multiplié par 3,6 le nombre de candidats évalués par heure. À temps égal, le contrôleur LLM bat une recherche arborescente codée à la main (de type UCB) sur 35 problèmes sur 38. Il ne choisit pas mieux à chaque essai : il gagne parce qu’il fait 2,4 fois plus d’essais corrects dans le même temps.
Plus de consignes n’aide pas
Rendre obligatoires les documents de référence et les compétences (skills) facultatifs a multiplié leur usage par 4,3 sans améliorer les meilleurs noyaux (rapport de 0,981 sur 233 paires). Laissés facultatifs, ils étaient ouverts par 13,6 % des sessions au début du run, puis par moins de 2 %.
Les détours paient
L’archive garde aussi les noyaux corrects mais lents, qui peuvent servir de tremplin. Sur Quantization/030, le meilleur chemin monte de 6,25 à 27,36 fois la référence, alors que 76 de ses 270 étapes étaient au même niveau ou plus lentes. Sur 75 des 235 problèmes (32 %), le chemin vers le meilleur noyau passe au moins une fois par un noyau qui valait moins de 0,9 fois le meilleur du moment. La plupart des gains arrivent tôt : 73 à 85 % de la progression de chaque classement dans les premiers 15 % du temps de run.
Les limites
Les auteurs les listent. Un seul benchmark (SOL-ExecBench sur B200), un seul modèle (Claude Opus 5.5 pour tous les agents), un seul run final, plus des comparaisons séparées faites sur des versions antérieures du système avec un run par bras. La correction est testée, pas prouvée : aucun outil formel examiné ne modélise les opérations asynchrones de Blackwell, et les tests de robustesse ont couvert les nouveaux meilleurs noyaux (94,9 %), pas chaque candidat. Les chronométrages locaux lisent trop vite (horloge débridée, environ 1,19 fois) et sont corrigés à la main. Le « départ de zéro » a ses nuances : le modèle a été préentraîné sur du code public, les agents avaient accès au web, aux en-têtes CUTLASS et à un wiki public, et des humains ont décidé quoi soumettre, quand publier et comment répartir les agents selon l’écart à la première place. L’effet du nombre d’agents n’a pas été testé directement.
Nos réserves : l’accélération mesurée vaut noyau par noyau ; les auteurs préviennent eux-mêmes que le gain sera plus faible une fois les noyaux intégrés dans un moteur de service de modèles, qui utilise déjà des bibliothèques optimisées. Le coût total en GPU et en appels au modèle n’est pas donné.
Lecture Neurone21
Pour une entreprise qui fait tourner des agents à grande échelle, quel que soit le domaine, la leçon principale est une leçon de plomberie. Avant d’ajouter des agents, il faut mesurer combien d’évaluations fiables le système produit par heure, et ce qui les bloque (verrous, compilation, files d’attente). Deux autres idées se transposent bien : garder hors du modèle une archive de tous les essais corrects, que l’on peut relire après chaque redémarrage, et confier la décision de « correct ou pas » à des contrôles qui ne dépendent pas de l’agent. Le papier rappelle aussi qu’un système assez puissant pour trouver des noyaux rapides trouve aussi les failles de son correcteur : des triches ont été détectées pendant le run.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.19230v1. Points à préciser :
Les chiffres 235 problèmes avec un noyau correct, première place sur L1, L2 et Quantization, 4,40 fois sur les 209 problèmes publics, 35 problèmes sur 38, 2,4 fois plus d’essais corrects, 3,6 fois plus d’évaluations par heure, sont ceux du papier. Plusieurs nuances. Les noyaux ne sont pas écrits « à partir de rien » au sens du modèle : c’est la recherche qui part de zéro, pas le modèle, et des humains ont piloté les soumissions et la répartition des agents. « Plus d’un millier d’agents » désigne le pic de sessions simultanées. Le « noyau vérifié correct » est validé par les tests du site ; les auteurs écrivent que cela ne prouve pas la correction sur toutes les entrées, et les résultats des 26 problèmes de FlashInfer-Bench ne sont pas publiés. Les 4,40 fois sont une moyenne géométrique (médiane 3,78), avec deux problèmes plus lents que la référence. La première place est datée du 11 novembre et a été perdue puis reprise en L2 et en quantification. Enfin, les auteurs précisent ne pas avoir testé directement l’effet du nombre d’agents ; mesurer les évaluations fiables par heure avant d’en ajouter prolonge leur conclusion.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.19230
- Le PDF : https://arxiv.org/pdf/2611.19230
- L’espace Hugging Face des auteurs : https://huggingface.co/spaces/QianQu/CompoundingKernel-Explorer
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/compoundingkernel-self-improving-from-zero-to-first-2611.19230
- Notre fiche sur Hyperkernel, des méga-noyaux GPU ouverts pour B300 : /p/hyperstition-hyperkernel-megakernels-open-source-b300