Titre original : Beyond Token Savings: A Systematic Study of Context Compression in LLM Agents
Auteurs : Ritul Satish, Prasoon Sinha, Akiho Kawada, Neeraja J. Yadwadkar
Affiliations : Université du Texas à Austin.
Publication : déposé sur arXiv le 26 septembre 2026 (version 1), 31 pages.
Liens : page arXiv, PDF. Aucun dépôt de code n’est indiqué ; les implémentations et les consignes sont décrites en annexe.
L’idée en bref
Un agent qui travaille longtemps accumule un historique (raisonnements, actions, résultats d’outils) qui finit par saturer sa mémoire de travail. Les agents de programmation compressent donc cet historique : ils suppriment les vieux échanges, effacent d’anciens résultats d’outils ou résument le passé grâce au modèle lui-même. Le papier rappelle l’enjeu : dans une trace de 13 millions de sessions GitHub Copilot, les sessions avec compression représentent 44,2 % des jetons servis.
Les logiciels du marché mélangent trois décisions dans une même règle : comment compresser (la « primitive »), quand déclencher la compression (le « déclencheur ») et quelle part retirer (la « profondeur »). Les auteurs les font varier séparément, pour voir l’effet de chacune sur la réussite, les jetons consommés, la durée et le coût.
Ce que montre le papier
Le protocole. Huit primitives tirées de systèmes déployés, trois modèles ouverts servis localement (Qwen3.5-35B-A3B, Devstral-Small-2-24B, GLM-4.7-Flash) et un harnais minimal, mini-swe-agent, qui n’ajoute aucune gestion de mémoire. Deux tests : 100 problèmes de SWE-bench Verified (corriger un vrai bug dans un dépôt de code) et 40 tâches de Terminal-Bench (travail en ligne de commande). Chaque configuration est lancée trois fois, soit près de 35 000 exécutions.
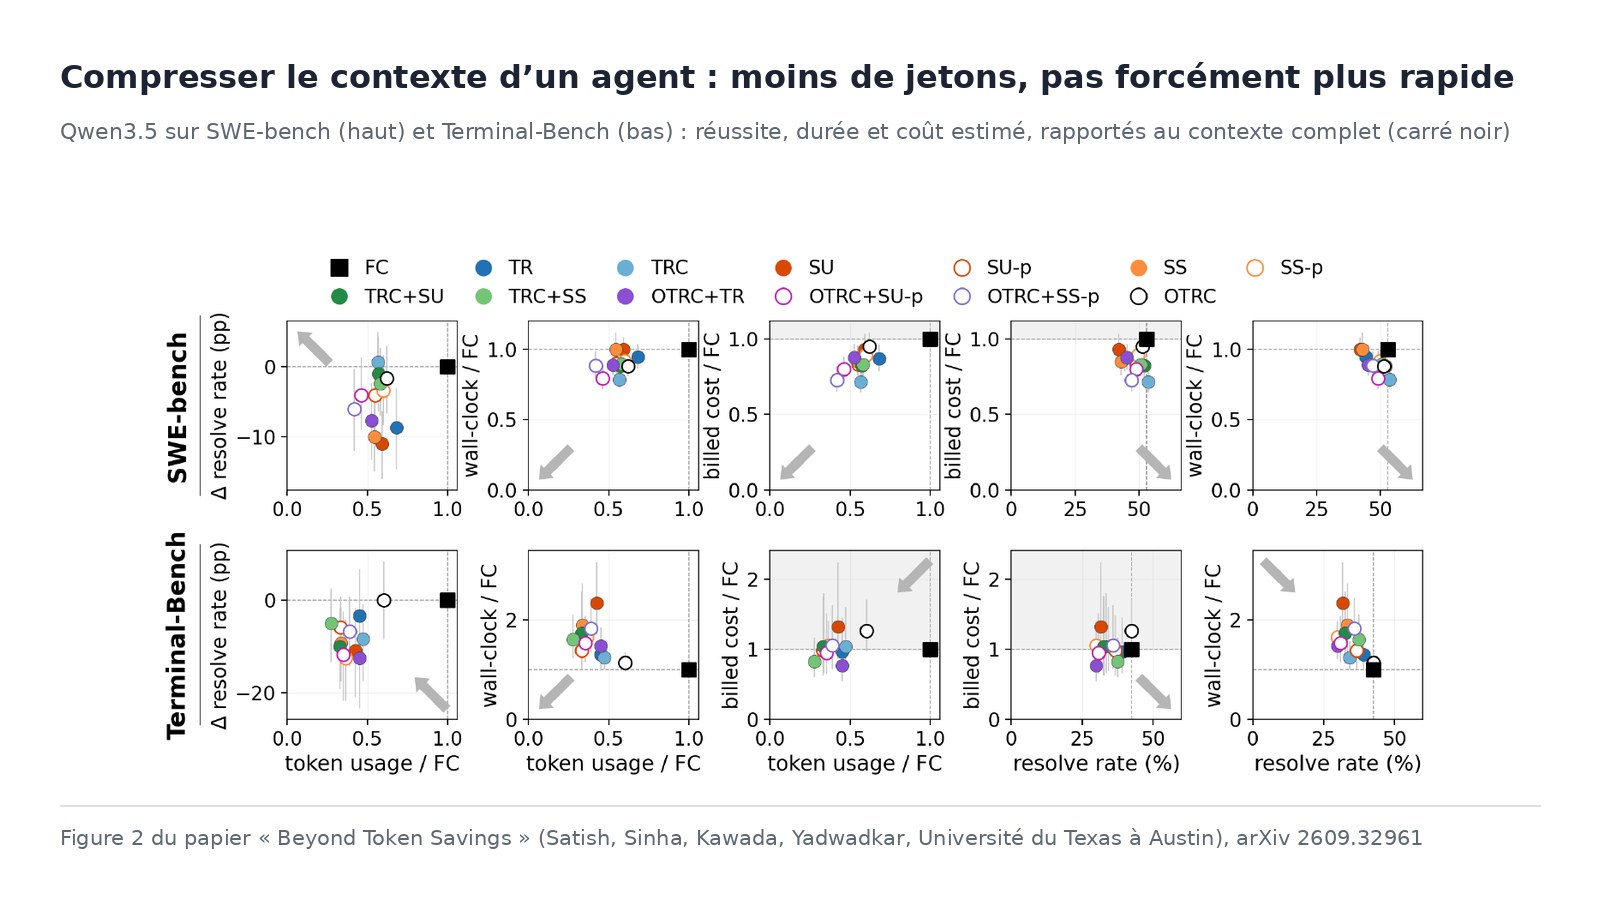
Moins de jetons, pas moins de temps. Sur Terminal-Bench avec Qwen, des stratégies qui consomment environ un tiers des jetons prennent 1,2 à 1,8 fois plus de temps que le contexte complet, et 11 sur 12 font baisser la réussite de 5 à 13 points. Sur SWE-bench, la meilleure stratégie pour Qwen garde la réussite du contexte complet tout en ramenant jetons, durée et coût à 0,57, 0,79 et 0,71 fois la référence.
Pourquoi. Le coût dépend de la mise en cache : un fournisseur facture souvent moins cher la partie du texte déjà traitée. Les auteurs supposent un prix dix fois plus bas pour ces jetons en cache. Une compression qui réécrit souvent l’historique casse ce cache et peut coûter autant, voire plus. La durée dépend aussi du nombre d’appels : les compressions déclenchées à intervalles fixes réduisent le plus les jetons par étape, mais demandent 10 % à 27 % d’appels en plus. Les stratégies combinées, déclenchées par un seuil de taille, réduisent les jetons de 22 % à 55 % avec un nombre d’appels proche du contexte complet.
Chaque modèle sa stratégie. Une stratégie qui marche bien avec Qwen et GLM fait tomber Devstral à 38,7 % de réussite sur SWE-bench et le rend 1,42 fois plus lent. Le classement des stratégies peut même s’inverser d’un modèle à l’autre. Deux stratégies au taux de réussite voisin ne résolvent pas non plus les mêmes problèmes.
Les limites
- Uniquement de la programmation, sur deux tests et des sous-ensembles : 100 problèmes de trois dépôts pour SWE-bench, 40 tâches pour Terminal-Bench, et 25 et 15 tâches pour les variations fines de seuil et de profondeur.
- Trois modèles ouverts de taille moyenne, servis localement ; rien n’est mesuré sur les grands modèles commerciaux.
- Un coût estimé, selon une hypothèse de tarification avec cache, et non facturé par un vrai fournisseur.
- Pas de section dédiée aux limites ni de code publié.
Lecture Neurone21
Pour les équipes qui exploitent des agents de code, la leçon est pratique : réduire le nombre de jetons n’est pas un objectif en soi. Il faut mesurer ce qui coûte vraiment, c’est-à-dire la durée de bout en bout, la facture réelle avec cache et le taux de réussite, et le faire pour chaque modèle. Une règle de compression copiée d’un outil du marché peut dégrader un autre modèle.
Ce travail rejoint d’autres papiers récents sur la gestion du contexte, qui plaident pour des stratégies adaptées à la tâche plutôt que des règles fixes.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2609.32961
- Le PDF : https://arxiv.org/pdf/2609.32961
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2106927371366596692
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/beyond-token-savings-a-systematic-study-of-context-compression-in-llm-agents-2609.32961