Titre original : Harness-Aware Distillation for Small Language Model Agents
Auteurs : Moonseok Choi, Taehong Moon, Giung Nam, Juho Lee
Affiliations : KAIST AI (Corée du Sud) ; Taehong Moon est indiqué comme chercheur indépendant.
Publication : déposé sur arXiv le 2 octobre 2026 (version 1).
Liens : page arXiv, PDF, page du projet. À la date de rédaction, le dépôt associé ne contient que la page du projet, pas de code d’entraînement.
L’idée en bref
Un agent fondé sur un modèle de langage travaille rarement seul : il est entouré d’un « harnais », le logiciel qui gère son contexte, ses outils et ses retours (suivi de l’état de l’environnement, liste des actions possibles, alerte quand une action tourne en rond). Pour réduire les coûts, on « distille » souvent un grand modèle en un petit : le petit modèle, l’élève, apprend à imiter le grand, le professeur. La distillation dite « sur politique » (on-policy distillation, OPD) fait corriger par le professeur les situations que l’élève rencontre lui-même.
Le constat des auteurs : le harnais reste en place après la distillation, donc l’élève n’a pas besoin de réapprendre ce que le harnais fournit déjà. Ce qui lui manque, c’est la capacité du professeur à bien agir à partir des informations du harnais. Leur méthode, HAD (Harness-Aware Distillation), cible précisément cela.
Ce que montre le papier
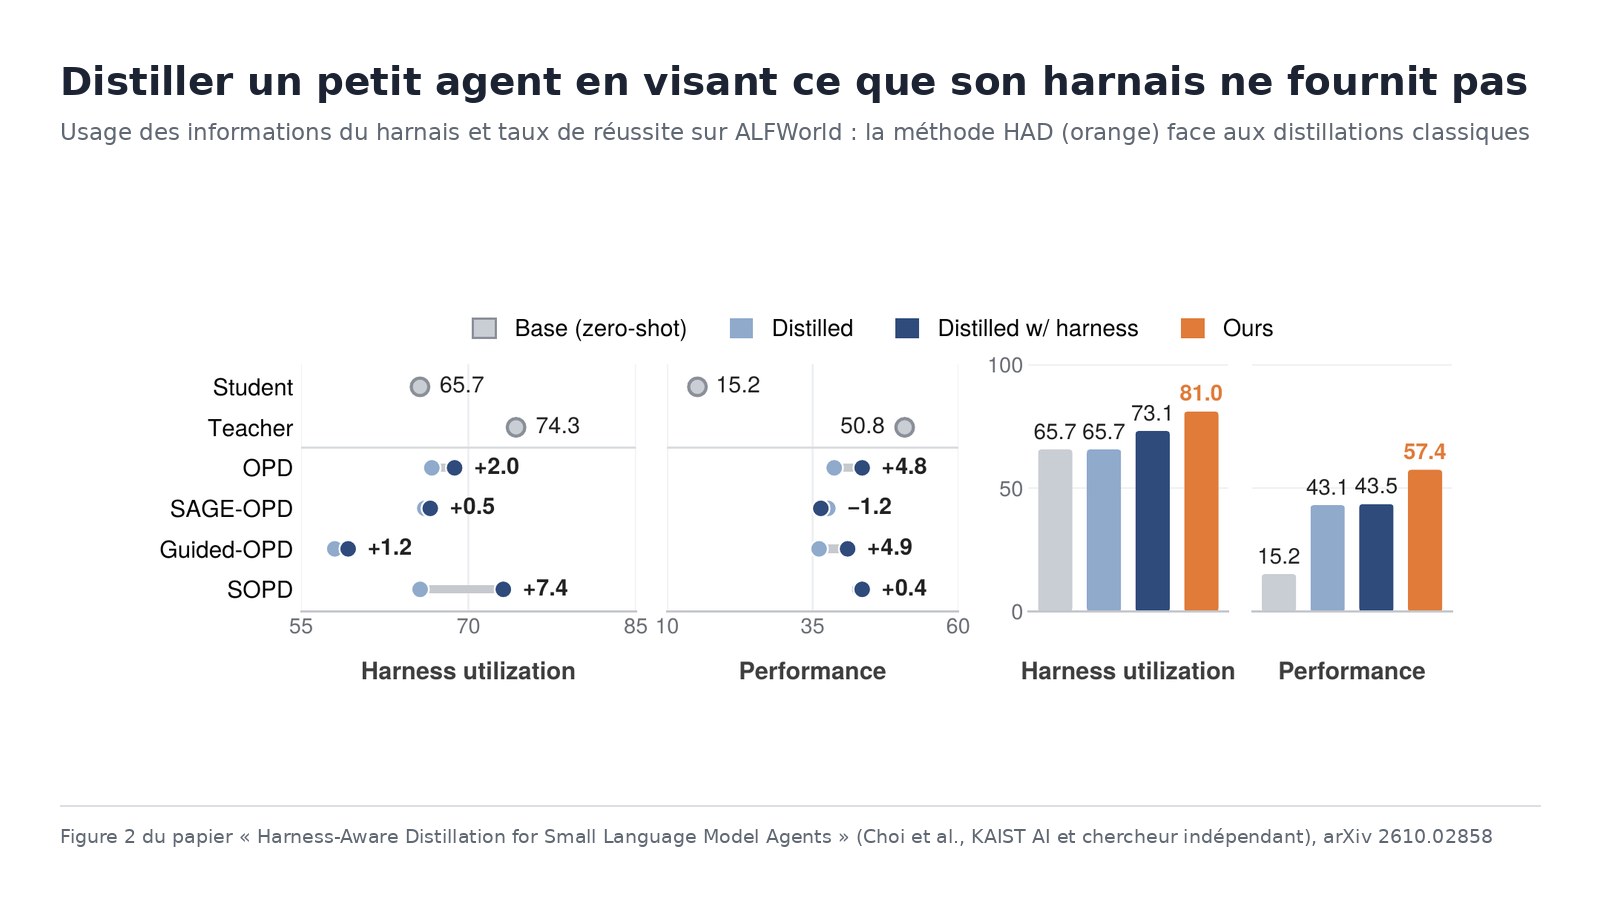
Ajouter le harnais ne suffit pas. Distiller simplement avec le harnais dans l’entrée fait passer l’usage des informations du harnais de 65,7 % à 73,1 % sur ALFWorld (un environnement textuel de tâches ménagères simulées), mais la réussite reste quasi stable, de 43,1 % à 43,5 % (moyenne des tâches déjà vues et inédites).
La méthode. Pour chaque situation, on interroge le même professeur deux fois, avec et sans les informations du harnais. Quand son action change, l’élève est entraîné à préférer celle choisie avec le harnais. Un filtre écarte les paires où l’action préférée contredit les relevés du harnais, par exemple « poser une assiette qu’on ne tient pas ». La méthode n’utilise ni récompense de tâche ni étiquette de réussite.
Les résultats. Avec des modèles Qwen3, l’élève de 1,7 milliard de paramètres distillé depuis un professeur de 8 milliards atteint 63,4 % de réussite sur les tâches ALFWorld inédites, contre 47,0 % pour la meilleure méthode de référence et 51,5 % pour le professeur. HAD arrive aussi en tête sur WebShop (achats en ligne simulés) et ScienceWorld (expériences scientifiques simulées), avec un élève de 0,6 milliard et un professeur de 30 milliards, mais avec des écarts bien plus faibles et des scores absolus bas. Un essai avec la famille Gemma 4 confirme l’avantage (37,3 % contre 32,1 %).
Sortir des impasses. L’élève HAD échappe à 59,7 % des blocages (boucles d’actions sans effet), alors qu’aucune méthode de référence ne fait nettement mieux que l’élève non entraîné, à 46,8 %. Sans harnais à l’évaluation, HAD retombe à 40,3 % : il dépend fortement du suivi d’état fourni par le logiciel.
Les limites
- Des modèles petits et des environnements textuels : élèves jusqu’à 2 milliards de paramètres, professeurs jusqu’à 30 milliards, aucun agent logiciel ou à appels d’outils réels, ce que les auteurs renvoient à des travaux futurs.
- Un harnais conçu à la main : un harnais appris ou optimisé automatiquement pourrait interagir autrement avec la méthode.
- Des gains inégaux : nets sur ALFWorld, minces sur WebShop, où le professeur garde un meilleur score.
- Pas de code publié à ce jour, ce qui empêche de reproduire les chiffres.
Lecture Neurone21
Le sujet touche directement à l’autonomie technique. Un petit modèle qui tient sur un serveur local ou un poste de travail, encadré par un bon harnais, peut rivaliser avec un modèle plus grand sur une tâche bornée. Pour une organisation qui veut garder ses agents chez elle plutôt que dépendre d’une API distante, la leçon est double : le harnais compte autant que le modèle, et distiller doit viser ce que le logiciel ne sait pas faire.
Reste à vérifier sur des tâches professionnelles réelles, avec des outils et des données d’entreprise, ce qui n’est pas l’objet de ce travail.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.02858
- Le PDF : https://arxiv.org/pdf/2610.02858
- La page du projet : https://moon4sake.github.io/harness-aware-distillation/
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2107507684270600394
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/harness-aware-distillation-for-small-language-model-agents-2610.02858