Titre original : EnvOpt: Automated Optimization for Agent Environments
Auteurs : Mingxuan Li, Huanzhi Mao, Qiuyang Mang, Hanchen Li, Joseph E. Gonzalez et Alex Dimakis.
Affiliations : University of California, Berkeley ; University of Chicago ; Bespoke Labs.
Publication : prépublication arXiv 2611.07372v1 (cs.AI), déposée le 5 novembre 2026, 36 pages avec annexes.
Liens : page arXiv, PDF, code.
L’idée en bref
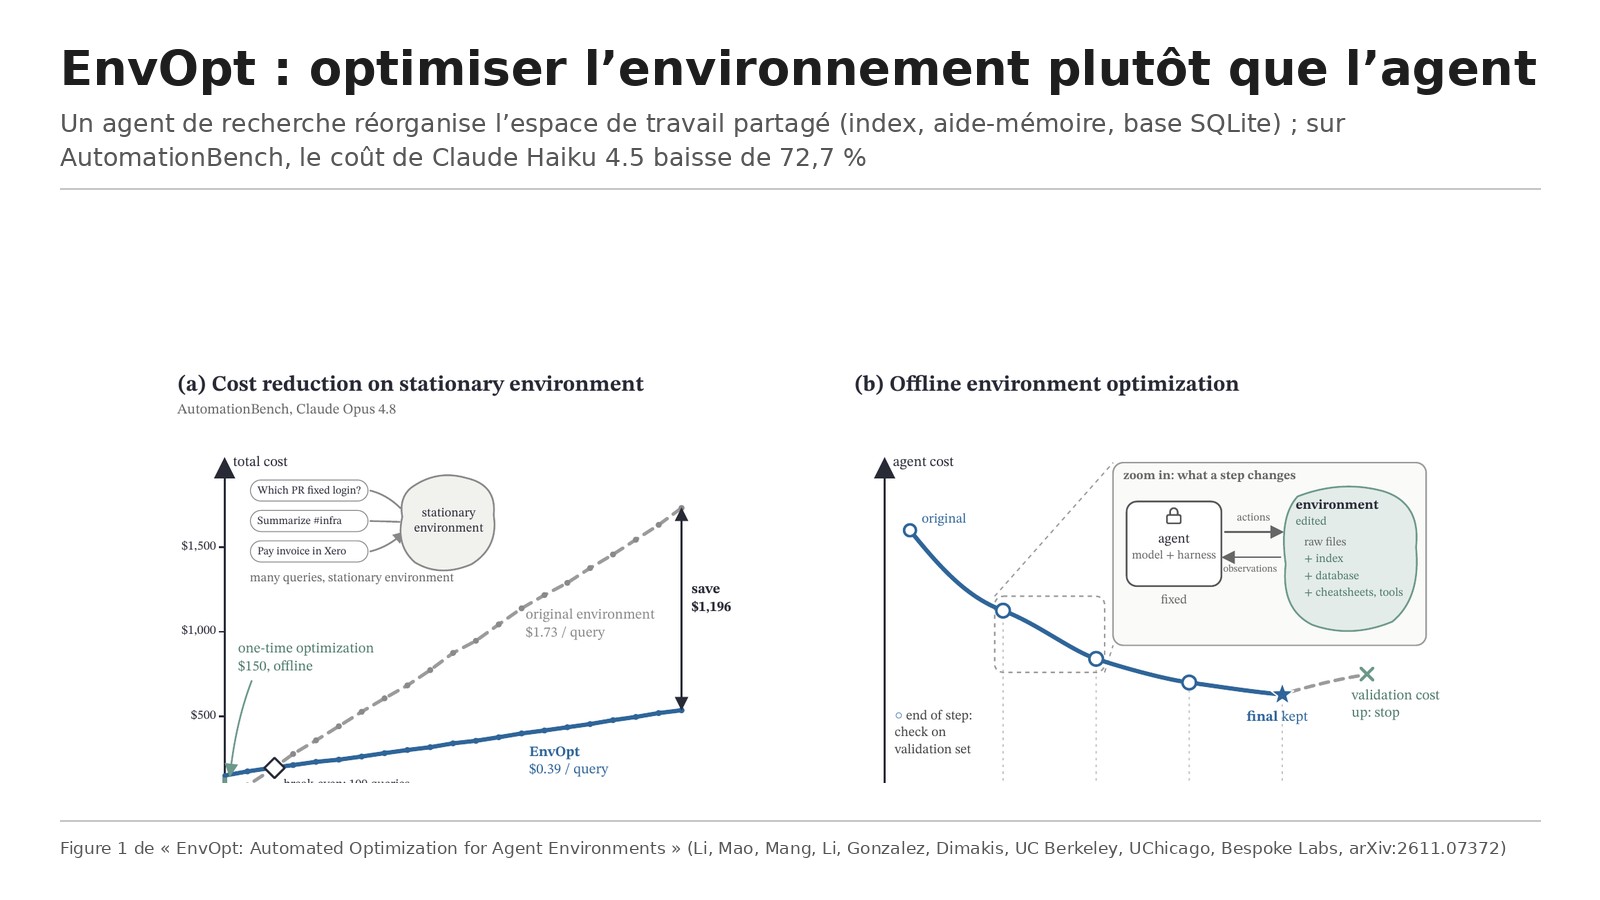
Le coût et la réussite d’un agent dépendent de trois choses : le modèle, le harnais et l’environnement dans lequel il travaille. On optimise beaucoup les deux premiers. Le troisième est souvent considéré comme fixe, alors que la même information peut être présentée de façons très différentes : un historique Slack derrière un serveur MCP, ou exporté en fichiers texte qu’on fouille avec grep.
Les auteurs parlent d’environnements « stationnaires » : une grosse collection d’artefacts qui reste la même pour beaucoup de tâches, comme l’espace Slack d’une entreprise, ses bases de données ou son dépôt de code. EnvOpt confie à un agent de codage (par exemple Codex) le rôle d’agent de recherche. Il fait tourner l’agent cible sur des tâches d’entraînement, regarde ses traces, modifie l’environnement, et recommence. Il n’a pas le droit de toucher au modèle ni au harnais. Les tâches d’entraînement n’ont pas de correcteur, pour éviter qu’il triche en notant les réponses ; un jeu de validation avec correcteur décide quand arrêter.
Ce que montre le papier
De fortes baisses de coût sur cinq bancs d’essai
Sur l’ensemble des cinq bancs (tâches d’espace de travail, d’ingénierie des données et de génie logiciel), le coût de l’agent cible baisse de 48 % en moyenne sur des tâches jamais vues, à réussite égale ou meilleure. Sur AutomationBench, Claude Haiku 4.5 passe de 2,33 % à 16,67 % de réussite et son coût baisse de 72,73 %. Sur Data-Eng-Bench, le coût de Codex avec GPT-5.6-luna baisse de 53,44 %, avec une réussite de 50,68 % à 53,88 %. Sur Workspace-Bench, la baisse est de 47,65 % pour l’agent cible.
Un environnement qui se transfère à d’autres modèles
L’environnement optimisé pour Haiku 4.5 sert aussi à des modèles plus forts : sur AutomationBench, Opus 5 réussit 35,17 % contre 33,83 % et coûte 68,13 % de moins ; Opus 4.8 coûte 77,41 % de moins. Ajouté au harnais optimisé par Meta-Harness, EnvOpt réduit encore le coût de 83,4 % et ajoute 11,17 points de réussite. L’optimisation d’AutomationBench a coûté 150,10 dollars en 6,6 heures, rentabilisée selon la Figure 1 après 109 requêtes pour Opus 4.8.
Ce que l’agent de recherche construit
Les modifications retenues sont concrètes : un programme qui présente les mails Gmail en texte brut, un aide-mémoire des points d’accès API pour Jira, Slack ou Xero, un index unique des fichiers d’un poste simulé, une base SQLite qui dit où se trouve chaque table, un programme qui classe les huit fichiers .go les plus probables pour un bug. L’essentiel de l’économie vient des résultats d’outils lus en entrée : sur AutomationBench, les jetons d’entrée par tâche passent de 171 641 à 41 466. Les auteurs documentent aussi les échecs : un fichier géant qui pousse l’agent à explorer davantage, un outil de recherche qui renvoie trop de fichiers.
Les limites
- Base de départ très basse : sur AutomationBench, Haiku 4.5 ne réussit que 2,33 % des tâches au départ, ce qui gonfle l’effet relatif ;
- juges approximatifs pendant l’entraînement : sans correcteur, l’agent de recherche s’est parfois fié à la longueur des réponses ou à des mots-clés, ce qui a nui aux résultats ;
- consignes pas toujours respectées : l’agent de recherche a tenté de changer l’effort de raisonnement de Codex malgré l’interdiction ;
- bugs qui persistent : un découpeur SQL fautif ajouté à l’étape 1 n’a été repéré qu’à l’étape 5, en gonflant le coût entre-temps ;
- environnements stationnaires uniquement : la méthode suppose que l’environnement change peu d’une tâche à l’autre.
Lecture Neurone21
C’est le papier le plus directement actionnable de la série pour une entreprise. Avant de changer de modèle ou de réécrire le harnais, il faut regarder ce que l’agent doit lire : des exports propres, un index, un aide-mémoire des API et une petite base qui dit où se trouvent les choses peuvent diviser la facture par deux ou plus. Et ce travail profite à tous les modèles qu’on branchera ensuite.
Un exemple concret : un agent qui répond sur un intranet documentaire coûte beaucoup moins cher si les documents sont convertis en texte, rangés par domaine et accompagnés d’un fichier d’index, que s’il doit tout ouvrir à chaque question. Steropes peut proposer ce chantier de « mise en forme de l’environnement » en amont de tout déploiement d’agent, avec un jeu de validation pour vérifier que la réussite ne baisse pas.
D’où vient ce papier
DAIR.AI (@dair_ai) l’a présenté le 6 novembre 2026 (14:27 UTC, 15:27 heure de Paris) ; Elvis Saravia (@omarsar0) l’a republié dix minutes plus tard. Nous avons lu la version officielle arXiv 2611.07372v1. Écarts avec le post :
Le post écrit que la réussite de Haiku 4.5 « augmente de 14,34 % » : il s’agit de 14,34 points de pourcentage, de 2,33 % à 16,67 %, pas d’une hausse relative. Il en va de même pour les 11,17 % ajoutés au-dessus de Meta-Harness, pour lesquels l’introduction du papier donne une autre valeur, 16 %. Les baisses de coût de 72,7 %, 68,1 % et 83,4 % correspondent au papier.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.07372
- Le PDF : https://arxiv.org/pdf/2611.07372
- Le code : https://github.com/itea1001/EnvOpt
- Le post DAIR.AI : https://x.com/dair_ai/status/2118711759792144408
- La republication d’Elvis Saravia : https://x.com/omarsar0/status/2118714128114024465
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/envopt-automated-optimization-for-agent-environments-2611.07372