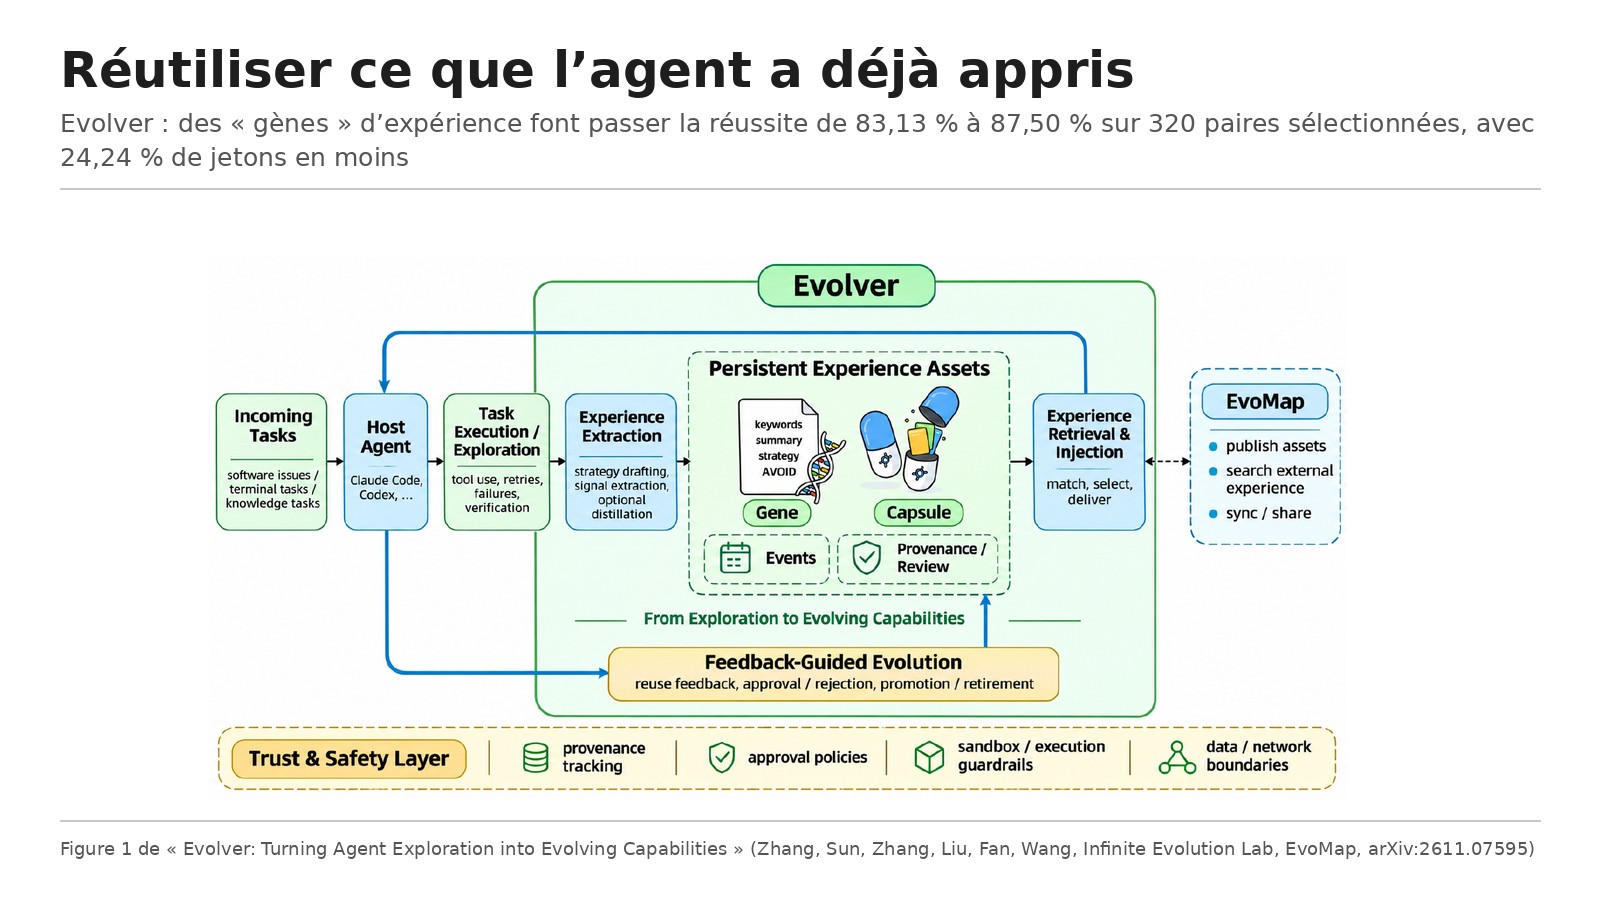
Titre original : Evolver: Turning Agent Exploration into Evolving Capabilities
Auteurs : Haoyang Zhang, Qumeng Sun, Xiao Zhang, Xiang Liu, Zhidong Fan et Junjie Wang.
Affiliation : Infinite Evolution Lab, EvoMap, l’entreprise qui publie l’outil Evolver et la plateforme EvoMap.
Publication : prépublication arXiv 2611.07595v1 (cs.SE), déposée le 5 novembre 2026, 12 pages.
Liens : page arXiv, PDF, code.
L’idée en bref
Un agent de code passe beaucoup de temps à explorer : il cherche les bons fichiers, rate une commande, corrige, vérifie. Ce savoir-faire reste d’ordinaire enfermé dans l’historique de la session, et la tâche suivante recommence l’enquête. Evolver veut garder ce savoir-faire et le resservir, sans réentraîner le modèle ni remplacer le harnais (Claude Code, Codex).
L’unité de base est un « gène » : un résumé de l’expérience, les étapes à suivre, les conditions où elles s’appliquent, des signaux pour reconnaître une tâche proche et, en option, un plan de vérification. Une « capsule » rattache le gène à un cas concret, un « anti-gène » dit ce qu’il ne faut pas refaire. Les candidats extraits automatiquement entrent en quarantaine, puis sont approuvés, rejetés ou révoqués, sans que le contenu stocké soit réécrit.
Ce que montre le papier
Un protocole en trois temps
Chaque tâche est d’abord exécutée sans aide (B), puis des stratégies sont tirées des traces de cette exécution, réussies ou ratées (E), enfin la tâche est rejouée dans une session neuve avec au plus 12 000 octets de gènes injectés (G). Deux harnais (Claude Code et Codex), deux modèles (deepseek-v4.1-flash et gpt-5.6-sol) et quatre bancs d’essai (Terminal-Bench 2.1, SWE-bench Multilingual, SWE-rebench, GAIA) donnent seize configurations de 20 tâches, soit 320 paires.
Plus de réussites, surtout dans le terminal
La réussite globale passe de 83,13 % à 87,50 %, soit 4,38 points. Claude Code gagne 2,50 points (85,00 % à 87,50 %), Codex 6,25 points (81,25 % à 87,50 %). Neuf configurations sur seize progressent, sept restent identiques. Le plus gros gain est celui de Codex avec DeepSeek sur Terminal-Bench 2.1 : de 70 % à 90 %. Sur l’ensemble, Terminal-Bench 2.1 passe de 64 à 71 tâches réussies sur 80, SWE-rebench gagne 5 points et GAIA 3,75 points, tandis que SWE-bench Multilingual reste à 96,25 %.
Moins de jetons, même quand le résultat ne change pas
La consommation moyenne par tâche tombe de 1 641,1 k à 1 243,3 k jetons, soit 24,24 % de moins. Les quatre couples harnais et modèle baissent, de 13,55 % (Claude Code avec GPT) à 35,96 % (Codex avec DeepSeek). Sur les 265 paires réussies avec et sans Evolver, la baisse est encore de 17,57 % (1 278,2 k à 1 053,6 k). Un exemple : compter des jetons dans un jeu de données sur Terminal-Bench 2.1 demande 112 appels au modèle sans Evolver et 17 avec, pour 86,5 % de jetons en moins.
Les limites
- jeu sélectionné, pas un échantillon : les auteurs écrivent que le choix final des tâches tient compte des gains observés et de la consommation de jetons ; les 320 paires sont un ensemble de diagnostic, pas un tirage au hasard des bancs d’essai ;
- même tâche, pas de généralisation : les gènes viennent en priorité de la même tâche, déjà exécutée une fois ; le protocole mesure la réutilisation, pas le transfert à des tâches nouvelles ni l’évolution en continu ;
- petits effectifs : 20 tâches par configuration, donc un écart de 5 points correspond à une seule tâche ;
- coûts partiels : le décompte de jetons exclut l’extraction de l’expérience et les autres frais hors exécution finale ;
- confiance variable : les contrôles d’admission et de confiance dépendent du chemin d’intégration, et certaines interfaces de récupération directe ne les appliquent pas ;
- auteurs juges et parties : l’équipe appartient à l’entreprise qui édite Evolver et EvoMap.
Lecture Neurone21
L’idée n’est pas neuve, et le papier le dit : garder ce qu’un agent a appris pour ne pas payer deux fois la même exploration. Ce qu’il apporte, c’est un format concret (procédure, conditions d’usage, signaux de reconnaissance, ce qu’il faut éviter) et un cycle de vie où une stratégie extraite automatiquement n’est pas crue sur parole : elle attend en quarantaine.
Pour une équipe qui fait tourner plusieurs agents sur des tâches qui reviennent, c’est le gain le plus tangible : moins de jetons sur ce qu’on sait déjà faire. Chez Steropes, où plusieurs bots relancent des travaux proches chaque jour, une note de procédure relue vaut mieux qu’un historique de conversation. Mais les chiffres de réussite sont à lire avec prudence : tâches rejouées, ensemble choisi après coup, et éditeur de l’outil aux commandes de l’évaluation.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 8 novembre 2026 (16:55 UTC, 17:55 heure de Paris), puis l’a reposté le 9 novembre 2026 (06:00 heure de Paris). Nous avons lu la version officielle arXiv 2611.07595v1. Écarts avec le post :
Les chiffres du post sont ceux de l’abstract : 320 paires, 83,13 % à 87,50 %, 24,24 % de jetons en moins, 265 paires et 17,57 %. Le post parle bien d’un ensemble « sélectionné », mais n’indique pas que ce choix tient compte des gains observés, ni que les gènes viennent surtout de la même tâche rejouée, ni que sept configurations sur seize ne progressent pas. Il ne mentionne pas non plus que les auteurs travaillent pour l’éditeur de l’outil.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.07595
- Le PDF : https://arxiv.org/pdf/2611.07595
- Le code : https://github.com/EvoMap/evolver
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2119473781689421855
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/evolver-turning-agent-exploration-into-evolving-capabilities-2611.07595