Titre original : Catching Developers in the Flow: Low-Latency Agentic Program Repair at Google Scale
Auteurs : Celal Ziftci, Spencer Greene, Ray Liu, Livio Dalloro, Lorenzo Dini
Affiliation : Google (New York).
Publication : déposé sur arXiv le 5 octobre 2026 (version 1), accepté à la conférence ASE 2026 (IEEE/ACM, génie logiciel automatisé).
Liens : page arXiv, PDF. Pas de code ni de données publiés : ils sont la propriété de Google, précisent les auteurs.
L’idée en bref
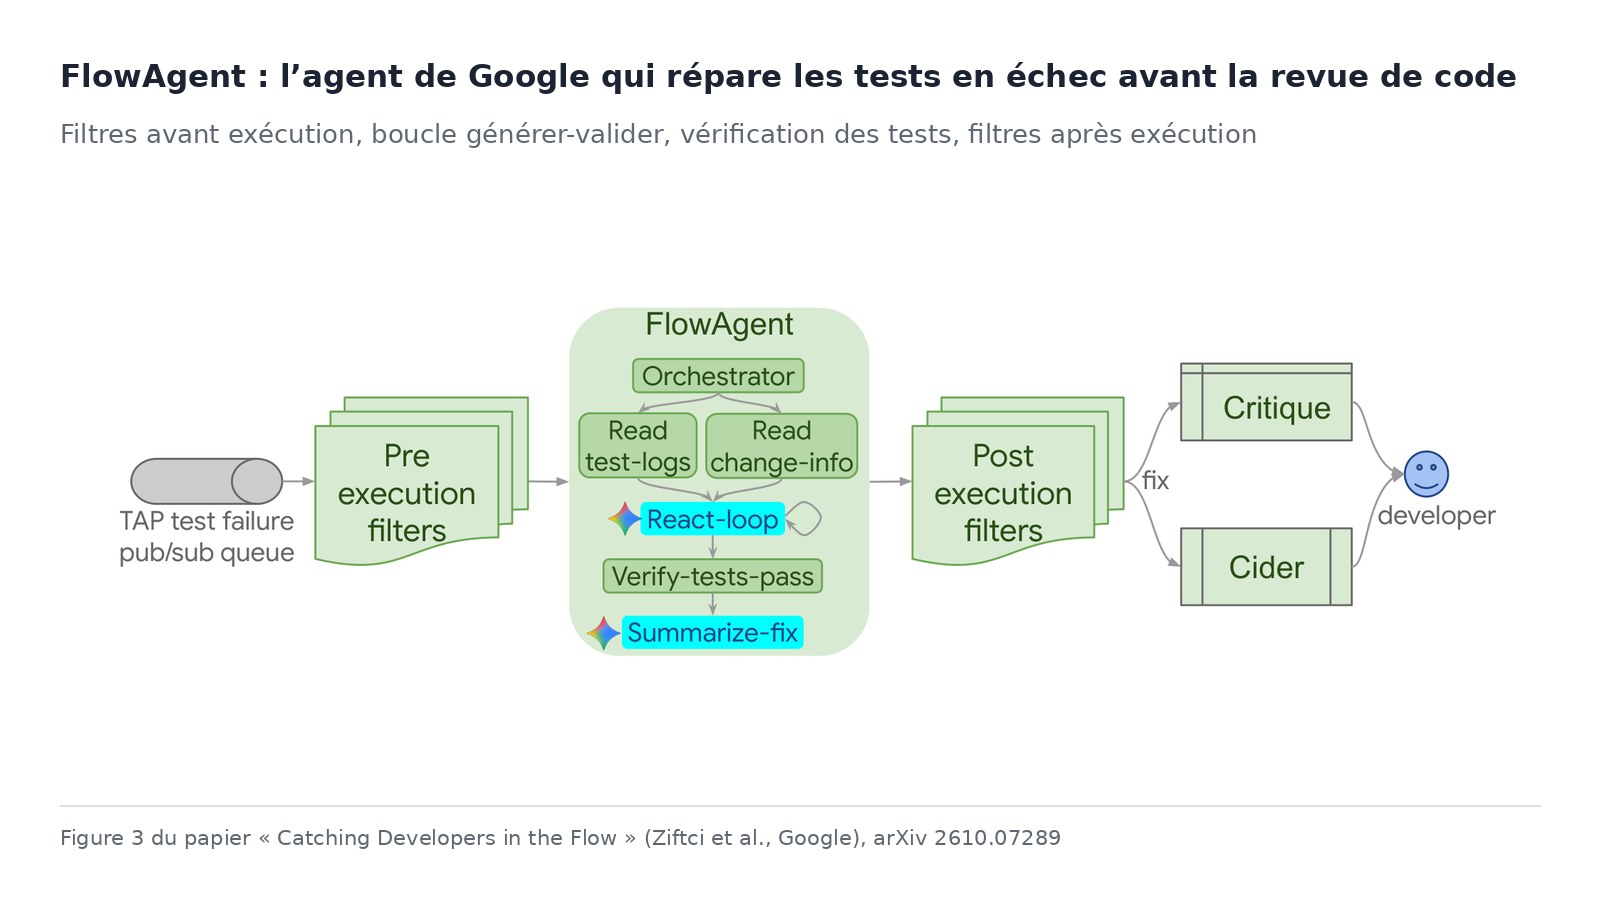
Chez Google, avant qu’une modification de code soit fusionnée, le système d’intégration continue (l’outil qui relance automatiquement tous les tests concernés) peut signaler des tests en échec. Le développeur met alors en médiane 27,48 minutes avant de retoucher son code. FlowAgent veut tenir dans cette fenêtre : dès qu’un échec est signalé, un agent tente de le réparer seul et affiche son correctif, avec un résumé de la cause, dans l’outil de revue de code (Critique) et dans l’environnement de développement interne (Cider). C’est, selon les auteurs, le premier système de réparation automatique de programmes conçu pour cette étape et ses contraintes de délai.
Ce que montre le papier
Une architecture simple. Des filtres écartent d’abord les cas inutiles : échecs de compilation, tests déjà en échec ou instables, modifications produites par des robots, changements de plus de 100 fichiers ou de 1 000 lignes. L’agent suit ensuite une boucle de type ReAct (le modèle alterne réflexion et actions : lire, modifier, compiler, lancer les tests), avec au plus 100 appels d’outils et 30 minutes. Les tests sont relancés une dernière fois de façon déterministe avant toute publication. Le modèle est une version interne de Gemini 2.5 Pro affinée sur le code de Google.
Une évaluation manuelle. Trois développeurs expérimentés ont examiné 195 échecs tirés au hasard dans 37 équipes : 131 correctifs étaient justes, soit 67,18 %.
Un déploiement à grande échelle. Depuis octobre 2025, l’agent a été déclenché sur 2 567 829 modifications en échec. Les filtres en ont écarté 1 785 955 ; il a tenté 781 874 réparations, en a réussi 421 818, puis 126 310 sont devenues caduques parce que le développeur avait déjà modifié ou soumis son code. Restent 295 508 correctifs affichés, 65 069 consultés et 28 554 appliqués. Le délai médian pour obtenir un correctif est de 9,85 minutes.
Des retours d’usage. Neuf développeurs interrogés saluent les résumés de cause et l’aide sur les tests fastidieux, comme ceux qui utilisent des objets simulés. Ils se plaignent aussi de correctifs qui suppriment ou désactivent un test, ou annulent leur propre modification.
Les limites
- Des filtres qui ne jugent pas la qualité. Le post d’Elvis Saravia laisse entendre que les deux filtres empêchent les suggestions faibles d’arriver au développeur. Le papier est plus nuancé : les filtres d’après exécution n’écartent que les correctifs devenus caducs. Des correctifs faux ou indésirables (ajouter une annotation qui ignore le test, avaler une assertion) arrivent bel et bien aux développeurs, et les auteurs travaillent à une étape de vérification supplémentaire.
- Un entonnoir étroit. Moins de 10 % des correctifs affichés ont été appliqués. Les auteurs l’expliquent en partie par des développeurs qui recopient le correctif à la main ou l’ajustent, sans le mesurer précisément.
- Une évaluation fermée. Les évaluateurs n’étaient pas propriétaires du code examiné, les volontaires interrogés forment un groupe auto-sélectionné, et ni le jeu d’évaluation ni le code ne sont publics.
- Un contexte très particulier, celui de l’outillage et du dépôt unique de Google, avec un modèle interne : la transposition à d’autres organisations n’est pas démontrée.
Lecture Neurone21
C’est l’un des rares papiers qui donnent un entonnoir complet d’un agent de code en production, du déclenchement à l’adoption réelle. Pour une direction technique, la leçon tient moins au taux de réussite qu’à l’ingénierie autour : filtrer agressivement les cas où l’agent n’a rien à faire, imposer un budget de temps calé sur le comportement des développeurs, revalider de façon déterministe, afficher le correctif là où les gens travaillent déjà.
Les chiffres rappellent aussi le coût caché : 643 milliards de jetons consommés pour 28 554 correctifs appliqués, et plus d’un quart des réparations réussies jetées parce qu’elles arrivaient trop tard. La rapidité de l’agent compte autant que sa justesse. Les auteurs affirment que la logique de FlowAgent se reproduit avec l’outillage du marché ; c’est plausible, mais à vérifier sur ses propres dépôts.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.07289
- Le PDF : https://arxiv.org/pdf/2610.07289
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2108276499615014936
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/catching-developers-in-the-flow-low-latency-agentic-program-repair-at-google-sca-2610.07289