Titre original : Object-Oriented Harness: Evolving Agent Harnesses through Object-Oriented Design
Auteurs : Gaotang Li, Bhavana Dalvi Mishra, Yifei Ming, Yanfei Chen, Zhongying CuiZhu, Lesly Miculicich, Long T. Le, Rui Meng, Chun-Liang Li, Hanghang Tong, Chen-Yu Lee, Tomas Pfister
Affiliations : Université de l’Illinois à Urbana-Champaign (UIUC), Google Cloud AI Research. Le premier auteur a mené ce travail pendant un stage chez Google.
Publication : déposé sur arXiv le 20 octobre 2026 (version 1).
Liens : page arXiv, PDF. Aucun dépôt de code n’est annoncé dans le papier.
L’idée en bref
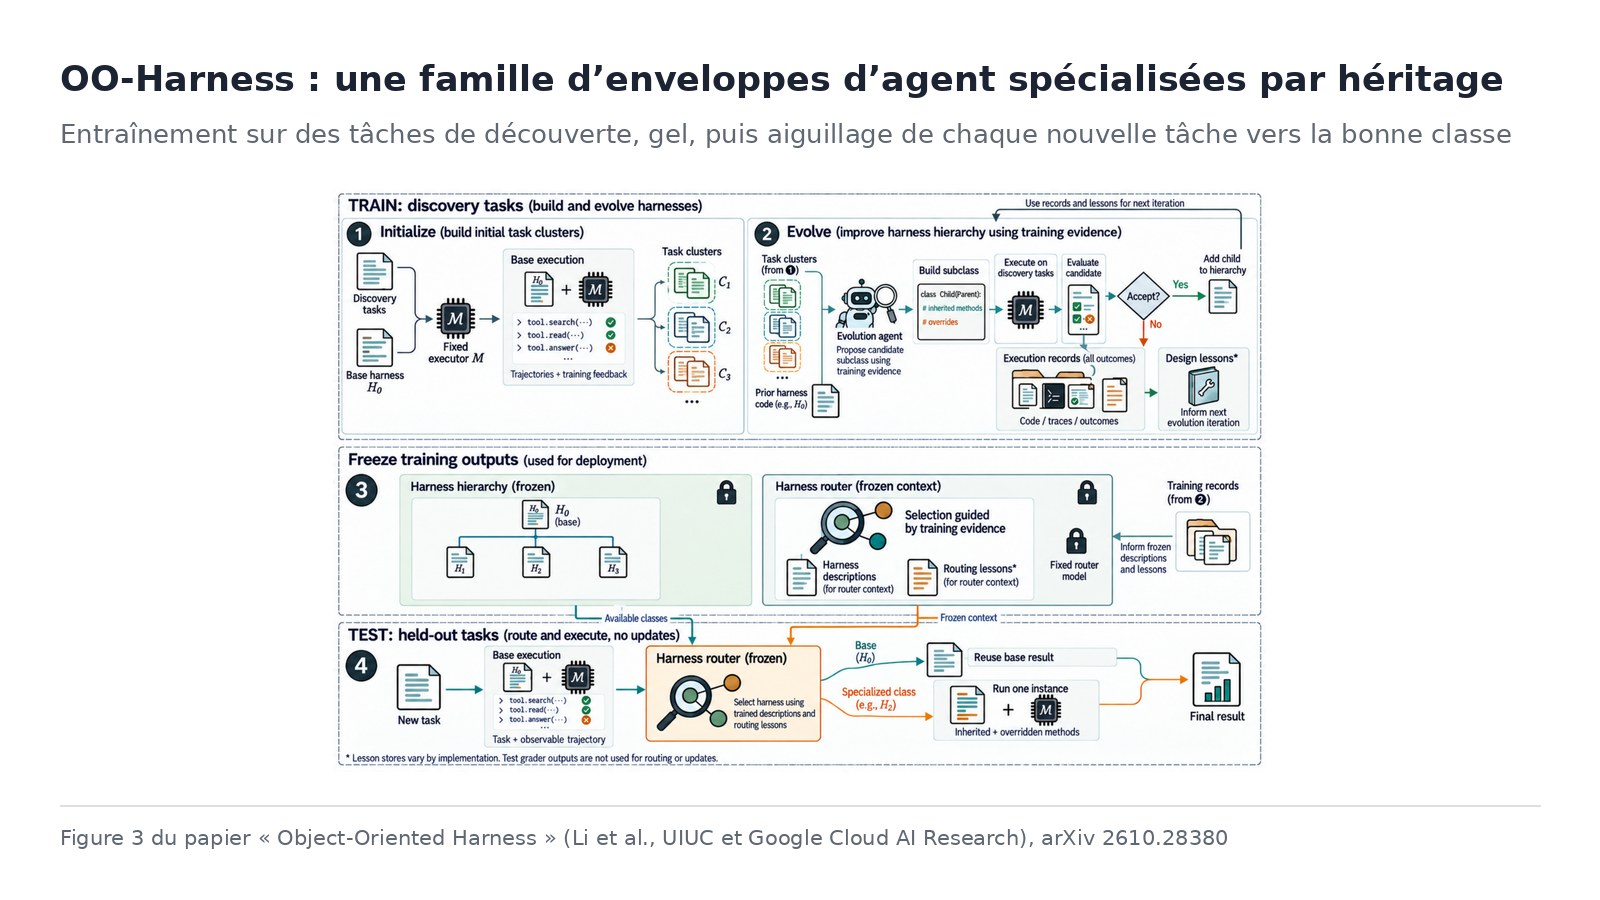
Le « harnais » (harness) d’un agent est le code qui entoure le modèle de langage : les consignes, les outils, la gestion du contexte, les règles d’arrêt et de vérification. Des méthodes récentes, comme Meta-Harness, font évoluer ce code automatiquement à partir des résultats, mais elles cherchent un seul harnais pour toutes les tâches. Or une amélioration utile à une famille de tâches peut en dégrader une autre. OO-Harness reprend la programmation orientée objet : un harnais de base, et des sous-classes qui en héritent et ne réécrivent que ce dont un groupe de tâches a besoin. Un aiguilleur choisit ensuite, pour chaque nouvelle tâche, la variante à utiliser.
Ce que montre le papier
La méthode. On lance d’abord le harnais de base sur des tâches dites de découverte, puis on regroupe les tâches qui échouent de la même façon. Un agent d’évolution (Claude Opus 4.8) écrit une sous-classe pour un groupe, la teste sur ce groupe seulement, la garde si elle fait mieux et consigne des « leçons » sur ce qui a marché ou non. En test, sur des tâches jamais vues, un aiguilleur (Claude Sonnet 5) lit la tâche et le déroulé du harnais de base, puis choisit une sous-classe ou conserve le résultat de base. Le modèle exécutant, Gemini 3.5 Flash, ne change jamais.
Les résultats. Sur trois bancs d’essai à longues tâches, moyenne de trois exécutions (tableau 1) :
- AutomationBench (flux métier en finance, RH, marketing, opérations, ventes et support) : score moyen de 61,62 % pour la base, 63,92 % avec Meta-Harness, 77,41 % avec OO-Harness ;
- Workspace-Bench (travail sur fichiers et applications) : de 25,45 % à 39,48 % ;
- Toolathlon-GYM (tâches multi-outils), taux de réussite stricte : de 31,15 % à 37,45 %.
OO-Harness devance aussi les deux approches d’optimisation globale testées, et de peu une autre approche à harnais spécialisés, Adaptive Auto-Harness (75,40 % sur AutomationBench). Dépenser plus de calcul au moment du test, en tirant plusieurs essais pour garder le meilleur ou en faisant se corriger le modèle, n’améliore pas les résultats de façon régulière.
L’héritage compte. Sur Workspace-Bench, construire les variantes par sous-classes fait 4,96 points de mieux que copier le même code évolué dans des classes indépendantes. Et lorsque les tâches de test viennent d’applications absentes de l’entraînement, l’aiguilleur revient au harnais de base et en conserve le score (59,18 %), alors que le harnais unique de Meta-Harness tombe à 44,90 %.
Les limites
- Une section limites très courte, qui ne parle que de dépendance aux API, de pannes, de limites de débit et de gestion des identifiants.
- Des comparaisons d’ablation sur une seule exécution, qu’il s’agisse de l’aiguillage ou de l’héritage, contre trois pour les résultats principaux ; Workspace-Bench n’est évalué que sur 100 tâches.
- Un coût sous-estimé par le compteur d’étapes. L’aiguilleur a besoin du déroulé de base : une tâche aiguillée vers une variante est donc exécutée deux fois. Le nombre d’étapes rapporté ne compte que la trajectoire finale. L’évolution mobilise aussi un modèle de pointe d’Anthropic, en plus de l’exécutant de Google.
- Pas de code publié à ce stade, ce qui rend la méthode difficile à vérifier.
Lecture Neurone21
Pour les entreprises qui déploient des agents sur leurs propres processus (CRM, support, bureautique), le papier va dans le sens d’une intuition de terrain : un même agent générique gère mal des tâches hétérogènes, et le gain vient souvent de l’enveloppe plus que du modèle. L’intérêt de l’approche est son organisation : chaque spécialisation reste lisible, testée sur son propre périmètre et révocable, avec un repli possible sur la version de base quand la tâche sort de l’ordinaire. C’est une forme de gouvernance du code d’agent autant qu’une technique d’optimisation.
À retenir aussi : ajouter du calcul au moment de répondre ne remplace pas un harnais adapté, et un harnais optimisé globalement peut dégrader les tâches qu’il n’a jamais vues.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.28380
- Le PDF : https://arxiv.org/pdf/2610.28380
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2112911038098317422
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/object-oriented-harness-evolving-agent-harnesses-through-object-oriented-design-2610.28380