Titre original : HarnessSQL: Harness-Native Training for SQL Agents in Realistic Database Environments
Auteurs : Haolin Yang, Jipeng Zhang, Zhiqiang Qian, Jian Xie, Shuaishuai Gong, Yike Guo, Sirui Han
Affiliations : Université des sciences et technologies de Hong Kong (HKUST), Microsoft Research, Université Tsinghua, Université de Macao.
Publication : version 1 déposée sur arXiv le 8 octobre 2026, version 3 le 14 octobre, 25 pages (prépublication).
Liens : page arXiv, PDF, code. Le dépôt de code ne déclare pas de licence à la date de rédaction.
L’idée en bref
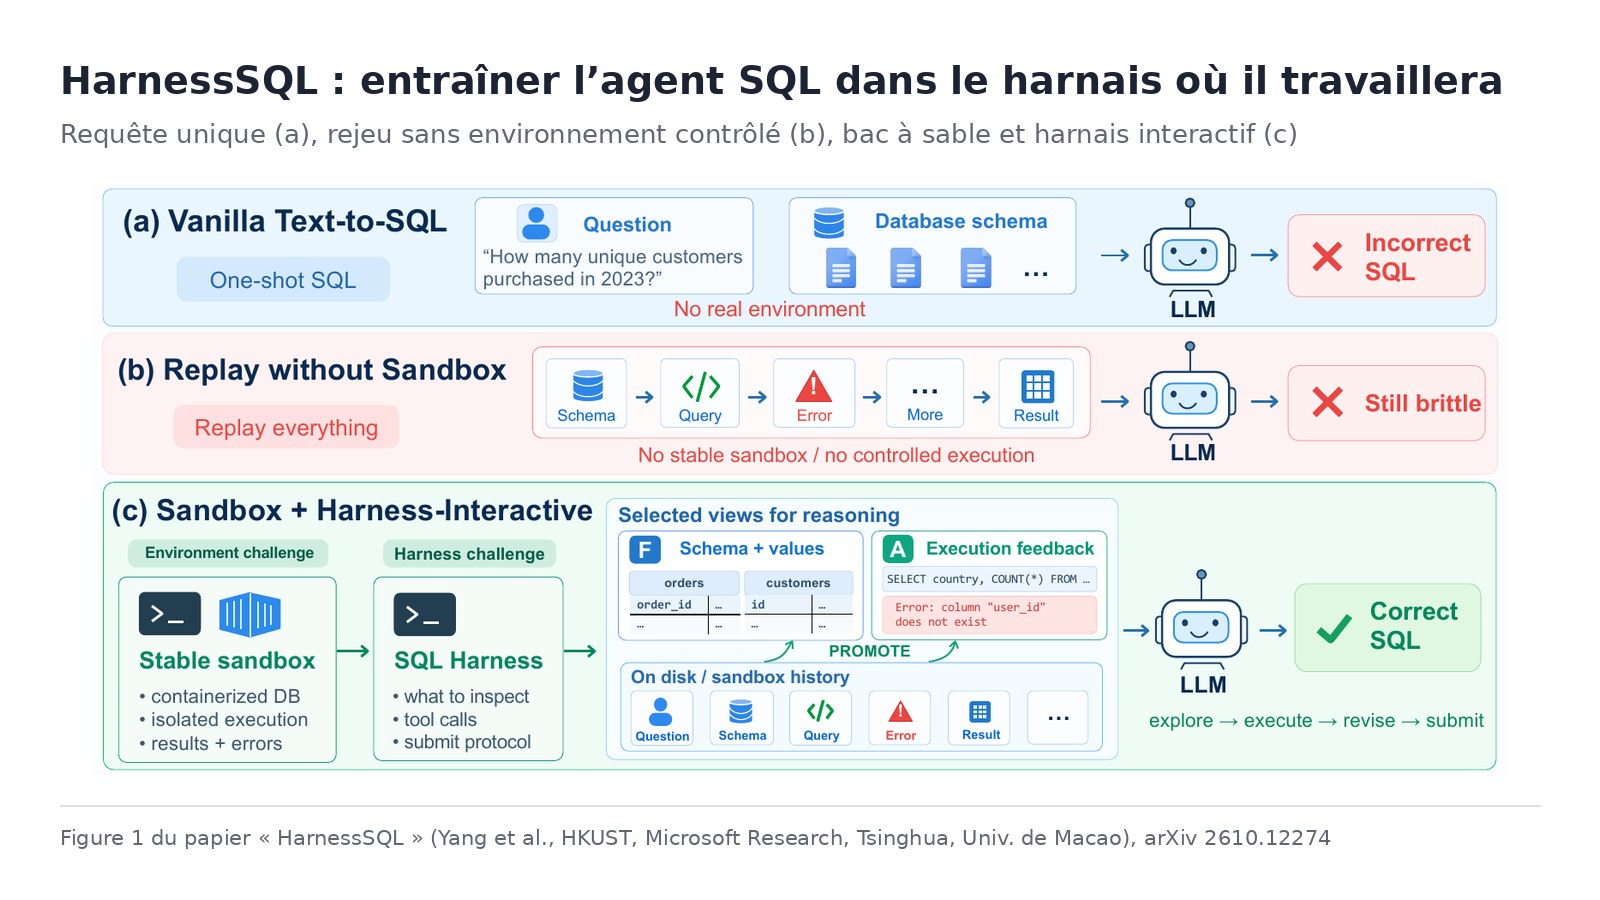
Les modèles « texte vers SQL » traduisent une question en une requête de base de données, d’un seul coup. En production, un agent de données fait autre chose : il inspecte les tables, lance des requêtes d’essai, lit les erreurs et corrige. Ce travail passe par un « harnais », le logiciel qui encadre ses outils et ses échanges avec la base. Or ce harnais n’apparaît en général qu’au déploiement : le modèle n’a jamais été entraîné dans les conditions où il travaille.
HarnessSQL entraîne le modèle directement dans ce harnais. Le harnais est réduit à quatre outils (lister les tables, lire leur structure, exécuter une requête en lecture seule, soumettre la réponse). Les bases sont isolées et exécutables, avec un correcteur caché qui connaît le bon résultat.
Ce que montre le papier
La méthode, en deux temps. D’abord, un modèle professeur plus puissant résout des tâches dans le harnais, et seules les trajectoires vérifiées sont gardées : 2 512 épisodes sur 79 bases, qui servent à un apprentissage supervisé. Ensuite, un apprentissage par renforcement récompense le modèle quand sa réponse finale produit le bon résultat.
Les résultats. Sur Spider 2.0-SQLite (135 tâches complexes), Qwen3-8B passe de 15,5 % à 45,2 % de réponses correctes, et Qwen3-14B de 22,2 % à 54,8 %, comme l’indique le post d’Elvis Saravia. Précision utile : ces scores de départ sont déjà mesurés dans le harnais. Sans harnais, le modèle de 8 milliards ne fait que 2,2 %. Les modèles spécialisés de 32 milliards testés (OmniSQL, Arctic-Text2SQL) plafonnent autour de 15 à 16 %, mais ce sont des modèles sans interaction, évalués avec leur protocole d’origine.
Le transfert. Sur deux tests jamais vus, les gains existent mais restent modestes en absolu : 9,0 % et 11,3 % sur BIRD-Interact Mini, qui impose un dialogue avec un utilisateur simulé, contre 1,7 % à 3,0 % pour les références ; 24,8 % et 28,5 % sur LiveSQLBench, contre 7,0 % à 8,9 %.
Pourquoi le harnais compte. À harnais identique au déploiement, un entraînement dans le harnais donne 30,4 % contre 9,6 % pour un entraînement classique. Le renforcement seul, sans la phase supervisée, ne donne que 20,0 %. Enfin, la qualité du professeur est décisive : un professeur trop faible dégrade l’élève sous son niveau de départ.
Les limites
- SQLite seulement : les dialectes courants en entreprise (PostgreSQL, Snowflake, BigQuery) ne sont pas couverts, limite reconnue par les auteurs.
- Un test principal proche de l’entraînement : les 30 bases SQLite d’entraînement sont identiques à celles du test Spider 2.0. Les auteurs vérifient en annexe qu’aucune question de test ne figure dans les données, mais l’avantage « à domicile » est réel ; les tests de transfert sont plus parlants.
- Pas de comparaison avec des modèles de pointe ni avec d’autres agents entraînés de la même façon : les références sont des modèles sans interaction.
- Le professeur principal n’est pas clairement identifié dans le texte ; l’ablation utilise Qwen3.6-27B.
Lecture Neurone21
L’interrogation de bases de données en langage naturel est l’un des usages d’agents les plus demandés en entreprise. Ce travail apporte un argument concret : un petit modèle, de 8 à 14 milliards de paramètres, peut être hébergé en interne, ce qui évite d’envoyer ses schémas de données à une API externe. Entraîné dans le harnais exact de production, il devient bien plus fiable qu’un modèle beaucoup plus gros qui écrit une requête d’un jet.
Les scores restent loin de la perfection, surtout hors du domaine d’entraînement. Le code publié permet toutefois de tester la méthode sur ses propres bases.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.12274
- Le PDF : https://arxiv.org/pdf/2610.12274
- Le code : https://github.com/YangHaolin0526/HarnessSQL
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2109026263453294956
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/harnesssql-harness-native-training-for-sql-agents-in-realistic-database-environm-2610.12274