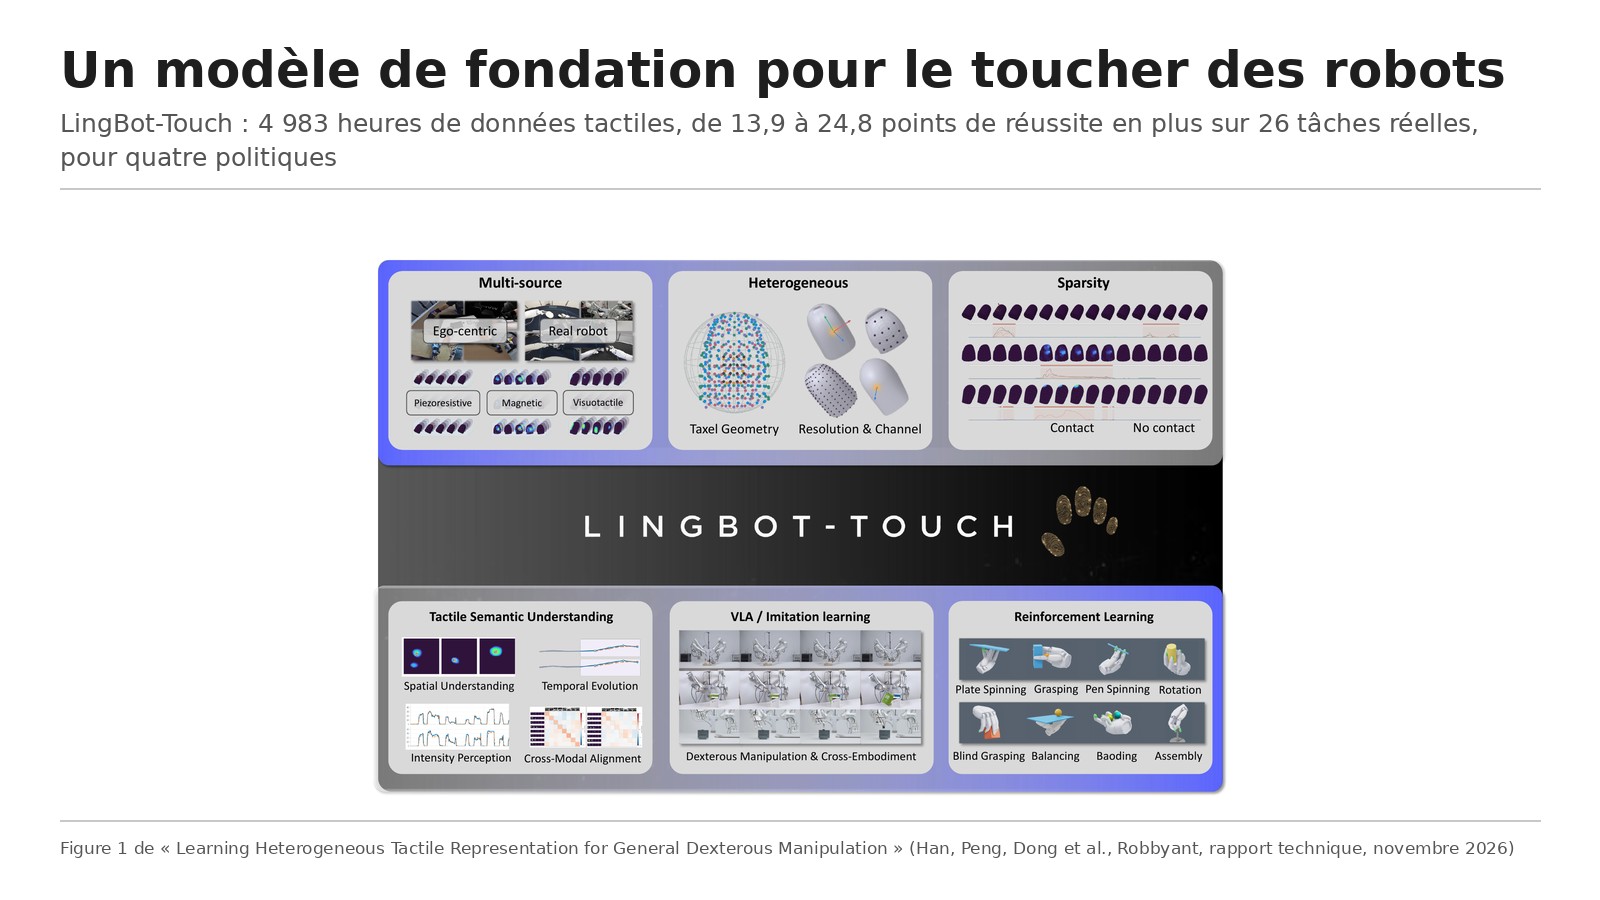
Titre original : Learning Heterogeneous Tactile Representation for General Dexterous Manipulation
Auteurs : Bing Han, Yichuan Peng, Haoyu Dong, Yuanmeng Hu, Yongyi Jia, Fangjing Wang, Kecheng Zheng, Yiming Zhang, Yanhong Zeng, Xiaoqing Zhang, Chen Song, Rundong Zou, Anqi Dong, Yuan Guan, Ka Leong Cheng, Xing Zhu, Yujun Shen, Nan Xue et Wei Ning (responsable du projet).
Affiliation : Robbyant, la filiale d’intelligence incarnée d’Ant Group.
Publication : rapport technique publié le 9 novembre 2026 dans le dépôt GitHub du projet, sans dépôt arXiv à cette date ni relecture par les pairs.
Liens : rapport en PDF, code sur GitHub, poids sur Hugging Face.
L’idée en bref
Les robots manipulent encore presque uniquement à la vue, qui ne dit ni la force exercée, ni si la prise glisse, ni ce qui se passe sous un doigt caché. Des capteurs tactiles existent (piézorésistifs, magnétiques, optiques), mais chaque type produit des signaux incompatibles avec les autres : canaux, résolution, disposition et fréquence diffèrent. Résultat, pas de format commun, pas de grand corpus, pas de recette partagée.
L’équipe part d’un constat simple : un doigt qui appuie sur une arête est le même événement physique, quel que soit le capteur. Elle place donc les points de mesure de chaque capteur dans un espace commun, celui du bout du doigt, et entraîne un seul encodeur pour les trois familles.
Ce que montre le papier
Un corpus de 4 983 heures
Le corpus réunit 4 983 heures d’enregistrements, 464 431 épisodes et 1,33 milliard d’images tactiles : 2 197 heures de gants piézorésistifs portés par des opérateurs humains, 1 136 heures de gants magnétiques et 1 650 heures de mains robotisées téléopérées à capteurs optiques. Un gant ne demande pas de robot, ce qui permet d’enregistrer des heures de manipulation quotidienne.
Prédire dans l’espace latent plutôt que reconstruire
L’encodeur, un Transformer partagé, apprend en prédisant la représentation de zones masquées (80 % des points à la fin de l’entraînement), dans la lignée des architectures JEPA. Face à deux méthodes qui reconstruisent le signal brut (MAE et VAE), sur les mêmes données, cette approche est la meilleure ou à égalité sur toutes les tâches de test. Avec plus de données, la méthode VAE se dégrade même sur quatre tâches sur cinq. Explication avancée : un signal tactile est surtout fait de zéros, et le reconstruire pousse le modèle à apprendre le fond plutôt que le contact.
Ce que l’encodeur sait sans réentraînement
Gelé, sur la main Sharpa Wave dont les capteurs sont vus à l’entraînement, l’encodeur retrouve la force au bout du doigt à 0,81 newton près (sur une plage de 0 à 30), le centre du contact à 0,12 millimètre près, et retrouve la bonne image vidéo à partir du seul toucher dans 72,6 % des cas parmi les cinq premiers, contre 16,5 % pour FTP-1, le modèle concurrent le plus proche. Sur la main XHand1, dont le modèle de capteur magnétique n’a jamais été vu, il fait mieux que FTP-1 muni d’un adaptateur spécifique sur les cinq tâches de test.
Le gain sur de vrais robots
Sur 26 tâches réelles à deux bras (éjecter une carte SD, déboucher un stylo, transférer un œuf, fermer une fermeture éclair, trier selon la rigidité), l’encodeur gelé, version Tiny de 5,46 millions de paramètres, fait passer la réussite moyenne de Diffusion Policy de 21,6 % à 35,6 %, de π0.5 de 48,1 % à 69,9 %, de LingBot-VLA de 48,3 % à 73,1 % et de T-Rex de 45,4 % à 68,6 %. Il ajoute moins de 0,2 % de paramètres. Donner aux mêmes politiques le signal tactile brut rapporte au plus la moitié de ce gain, et le fait souvent baisser. En simulation, sur douze tâches de dextérité, l’apprentissage par renforcement réussit 69 % des essais avec cet encodeur, contre 46 % avec un réseau convolutif entraîné pour la tâche et 21 % sans toucher.
Les limites
L’équipe en cite trois : il faut tester sur davantage de mains robotiques (deux ici), les capteurs capacitifs sont absents faute de données de qualité suffisante, et le modèle se concentre sur le bout des doigts, ce qui laisse la paume et le reste des doigts peu couverts.
Nos réserves : c’est un rapport d’entreprise, non relu par des pairs, publié avec le produit. Les 26 tâches réelles ont été choisies, selon le rapport lui-même, pour que le toucher compte, ce qui favorise mécaniquement un encodeur tactile. Chaque résultat repose sur 20 essais par tâche. LingBot-VLA, l’une des quatre politiques testées, vient de la même maison. Le rapport écrit dans son introduction un gain de 14 à 26 points, alors que ses propres chiffres détaillés donnent 13,9 à 24,8.
Lecture Neurone21
Pour un intégrateur ou un industriel qui équipe des robots de préhension fine, le résultat le plus concret est le format : un petit encodeur gelé, que l’on branche sur une politique existante sans la modifier, publié sous licence Apache 2.0 avec ses poids. Le second résultat compte pour les achats : les heures enregistrées avec un capteur servent à un autre, donc on peut collecter avec le matériel le plus simple à déployer, un gant par exemple, et exploiter les données sur la main réellement installée.
Le toucher reste pourtant une brique jeune. Deux mains, des tâches choisies pour lui et aucune évaluation indépendante : avant d’en faire un argument de vente, il faudra des essais sur d’autres plateformes, idéalement hors de l’écosystème Robbyant.
D’où vient ce papier
Robbyant (@robbyant_brain) a annoncé LingBot-Touch le 9 novembre 2026 à 20:11 heure de Paris. Elvis Saravia (@omarsar0) a répondu à 22:28 heure de Paris avec le lien du rapport technique, qu’il qualifie de « great read », puis l’a recommandé dans un second post le 10 novembre à 00:52 heure de Paris. Nous avons lu le rapport officiel publié dans le dépôt GitHub du projet. Écarts avec les posts :
Le post de Robbyant parle de « près de 5 000 heures », ce qui correspond aux 4 983 heures du rapport. Le résumé d’Elvis, selon lequel la prédiction latente bat MAE et VAE sur les mêmes données, est conforme au rapport. Aucun des deux posts ne mentionne que les tâches réelles ont été choisies pour que le toucher compte, ni que le gain d’introduction (14 à 26 points) diffère des chiffres détaillés (13,9 à 24,8).
Pour aller plus loin
- Le rapport technique (PDF) : https://github.com/Robbyant/lingbot-touch/blob/main/paper/Learning_Heterogeneous_Tactile_Representation_for_General_Dexterous_Manipulation.pdf
- Le code : https://github.com/Robbyant/lingbot-touch
- Les poids Tiny et Small : https://huggingface.co/collections/robbyant/lingbot-touch
- La page du projet : https://technology.robbyant.com/lingbot-touch
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2119941151516209594