Titre original : LoGRA: Scaling LLM Reinforcement Learning with Low-Rank Gradient Sketches
Auteurs : Shaokun Zhang, Yifan Zhang, Jian Hu, Yueying Li, Hao Zhang, Binfeng Xu, Jan Kautz, Yi Dong
Affiliations : NVIDIA.
Publication : version 1 déposée sur arXiv le 5 octobre 2026, version 3 le 17 octobre, 17 pages.
Liens : page arXiv, PDF, code. Le papier indique que le code est disponible dans la bibliothèque Molt ; le lien pointe vers la branche consacrée à LoGRA, publiée sous licence Apache 2.0.
L’idée en bref
L’apprentissage par renforcement (RL), qui améliore un modèle en récompensant ses bonnes réponses, est devenu central dans l’entraînement des grands modèles de langage. Il coûte cher en mémoire, et pas seulement à cause des poids du modèle. Il faut aussi stocker les gradients, c’est-à-dire la direction dans laquelle corriger chaque poids, et l’état de l’optimiseur Adam, deux tableaux supplémentaires par poids. Pour un modèle de 7 milliards de paramètres, les poids pèsent environ 14 Go, mais l’état d’Adam en ajoute 56. Un matériel capable de faire tourner un modèle peut donc être incapable de l’améliorer.
La parade la plus répandue, LoRA, gèle le modèle et n’entraîne que de petites matrices ajoutées. LoGRA fait autrement : il met à jour tous les poids, mais ne construit jamais le gradient complet des grandes matrices. Chaque gradient est compressé à la volée par une projection aléatoire de rang 256 (une forme résumée de la matrice), tirée à nouveau à chaque pas, puis la mise à jour est reconstruite à partir de deux petites matrices. Un garde-fou prédit avant chaque pas de combien le comportement du modèle va changer, mesuré par la divergence de Kullback-Leibler (KL), et réduit le pas s’il dépasse un budget.
Ce que montre le papier
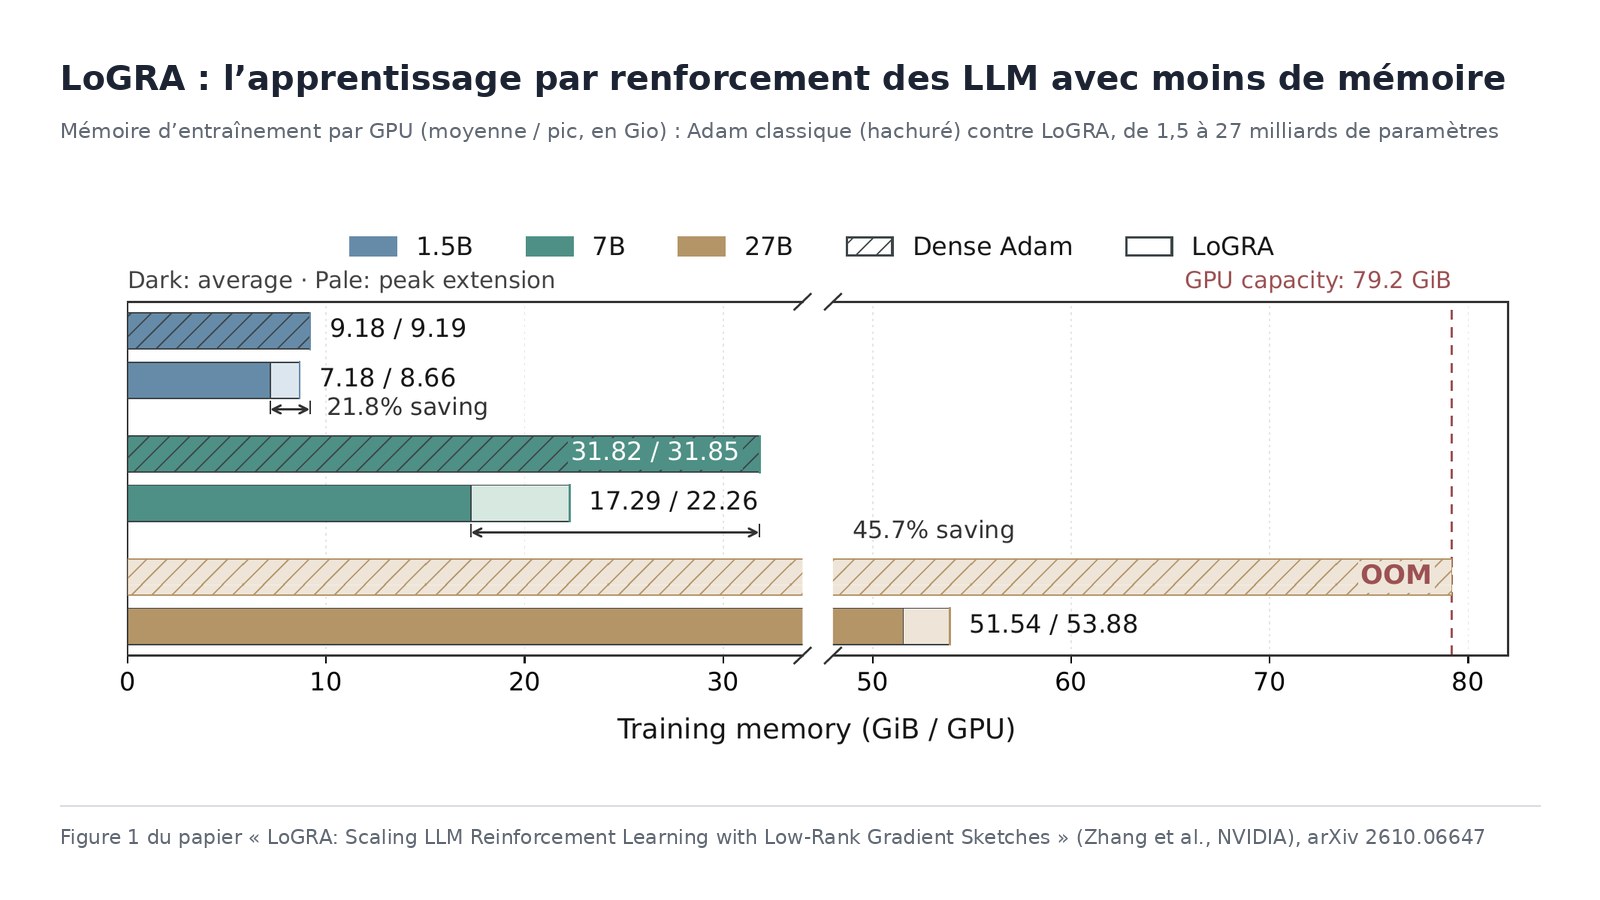
Moins de mémoire. Sur des modèles Qwen entraînés au raisonnement mathématique, la mémoire moyenne d’entraînement par GPU passe de 9,18 à 7,18 Gio à 1,5 milliard de paramètres (−21,8 %) et de 31,82 à 17,29 Gio à 7 milliards (−45,7 %). Ces mesures excluent la mémoire utilisée pour générer les réponses.
Sans perte nette de précision. Sur MATH-500, à 7 milliards, LoGRA atteint au mieux 72,33 % de bonnes réponses au premier essai, contre 72,48 % pour Adam classique. À 1,5 milliard, il fait même mieux (67,87 % contre 63,77 %). La vitesse d’entraînement est comparable.
Face à LoRA. À 1,5 milliard, sur les 300 premiers pas d’entraînement, LoGRA utilise 7,18 Gio en moyenne contre 13,21 pour LoRA de rang 256. Il réussit 81,8 % des problèmes en quatre essais contre 81,4 %, mais fait environ 2 points de moins au premier essai (68,47 % contre 70,45 %), et chaque pas est un peu plus lent. Les auteurs le disent : l’avantage porte sur la mémoire, pas sur la précision ni la vitesse.
Un 27 milliards sur un seul serveur. Sur un nœud de huit GPU, Adam classique manque de mémoire dès son premier pas avec Qwen3.8-27B. LoGRA l’entraîne plus de 1 100 pas sur un mélange de problèmes difficiles, et le score sur des problèmes réservés passe de 39,69 % à 62,94 %, avec un pic à 65,52 %, sans effondrement.
Les limites
- Surtout des mathématiques : la plupart des comparaisons portent sur un jeu de problèmes (DAPO-Math) et un test (MATH-500), avec des modèles Qwen.
- Une comparaison avec LoRA courte : 300 pas seulement, sur le plus petit modèle.
- Pas de comparaison à 27 milliards : Adam classique ne tient pas en mémoire, il n’y a donc pas de référence pour juger la qualité de cet entraînement.
- Trois répétitions par configuration, sur un seul type de recette d’entraînement.
- Pas de section dédiée aux limites dans le papier.
Lecture Neurone21
La mémoire des GPU est l’un des verrous les plus concrets pour les laboratoires et les entreprises qui veulent adapter eux-mêmes un modèle ouvert plutôt que dépendre d’un fournisseur. Pouvoir faire de l’apprentissage par renforcement complet d’un modèle de 27 milliards sur un seul serveur de huit GPU, au lieu d’une grappe, abaisse ce seuil. C’est un enjeu direct d’autonomie technique pour les acteurs européens au parc de calcul limité.
Il reste à vérifier la méthode sur d’autres tâches que les mathématiques. Le code est ouvert, ce qui permet de le faire.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.06647
- Le PDF : https://arxiv.org/pdf/2610.06647
- Le code : https://github.com/skzhang1/labs-molt/tree/logra/examples/scripts/logra
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2109771098120450299
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/logra-scaling-llm-reinforcement-learning-with-low-rank-gradient-sketches-2610.06647