Titre original : LongHarness: Advancing Agentic Reasoning over 100M-Token Corpora via Stateful Evidence Management
Auteurs : Songtao Huang, Zhijie Zhong, Xiaohan He, Shuaiyu Zhang, Zhiyin Yu, Li Kang, Heng Zhou, Yutao Fan, Xiangchao Yan, Bo Zhang, Shiyang Feng
Affiliations : Université Fudan, Shanghai Artificial Intelligence Laboratory, Université de Pékin, Université Jiao Tong de Shanghai, Université des sciences et technologies de Chine, Institut de technologie de Harbin.
Publication : déposé sur arXiv le 9 octobre 2026 (version 1), 19 pages.
Liens : page arXiv, PDF. Aucun code n’est indiqué dans le papier.
L’idée en bref
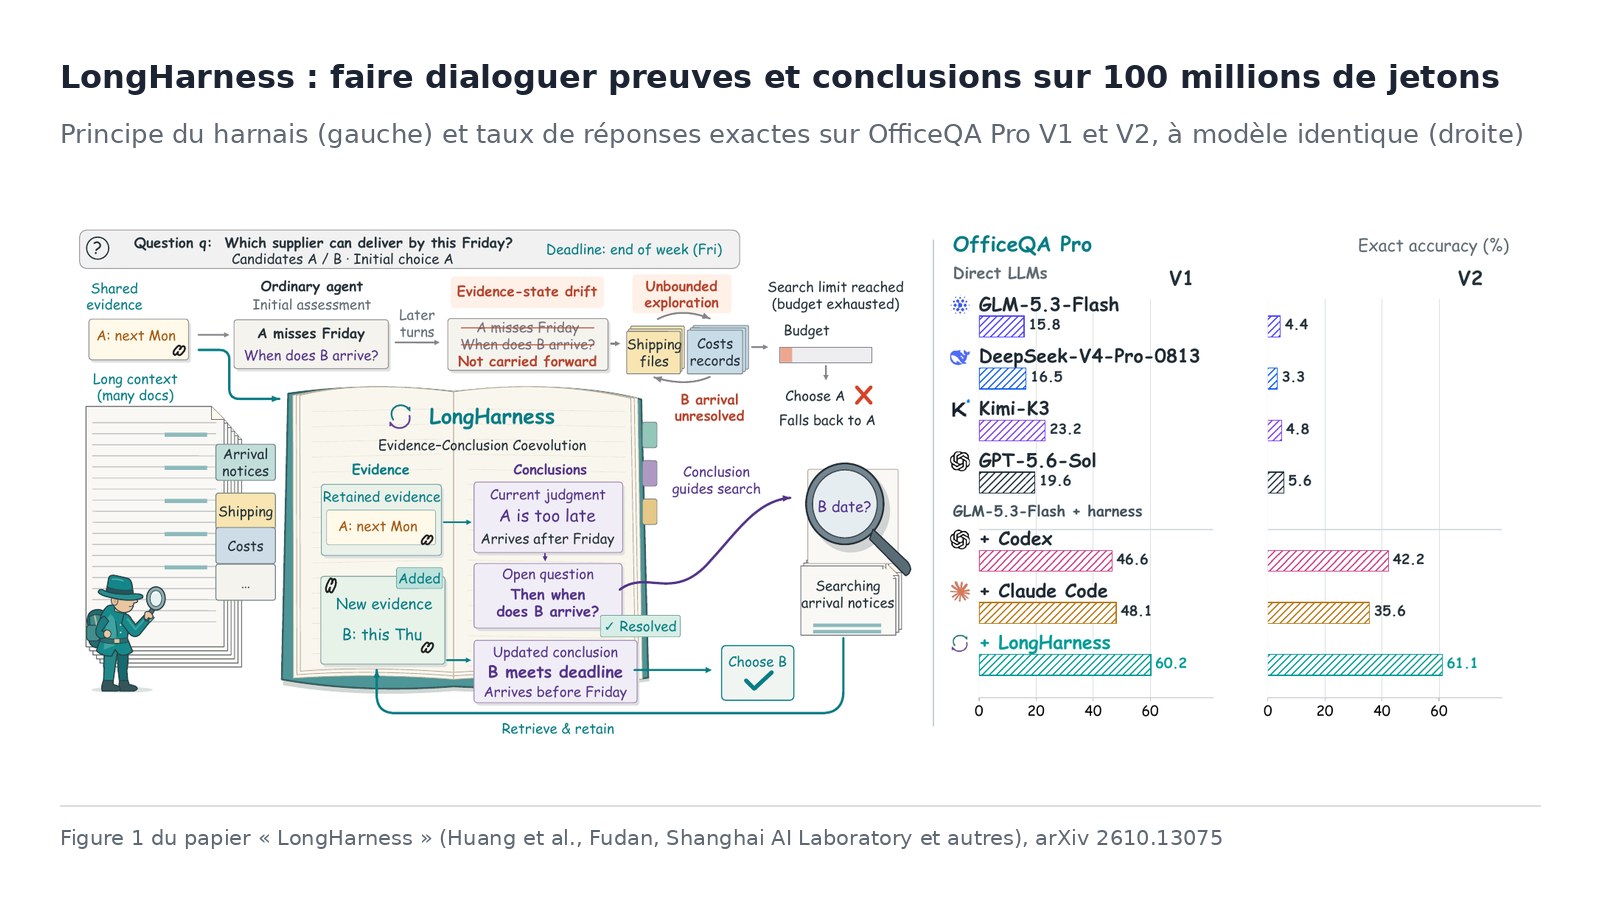
Répondre à une question en fouillant un fonds documentaire bien plus grand que la mémoire de travail d’un modèle (sa « fenêtre de contexte ») est un usage typique en entreprise. Les harnais d’agents actuels, ces logiciels qui organisent les recherches et lectures du modèle, empilent tout dans un historique de conversation qui grossit. Les auteurs y voient deux pannes liées : une exploration sans fin, où l’on cherche toujours plus sans combler le vrai manque d’information, et une « dérive » où des preuves déjà trouvées, ou des corrections, n’atteignent plus la réponse finale.
LongHarness tient donc deux états explicites : une banque de preuves et un état des conclusions. Les conclusions encore ouvertes décident de la prochaine recherche ; chaque nouvelle preuve confirme ou révise la conclusion qui l’a demandée. Un mécanisme de « cycle de vie » garde les preuves à jour et traçables.
Ce que montre le papier
Le terrain. OfficeQA Pro V1 compte 133 questions sur 697 documents du Trésor américain, environ 100 millions de jetons au total. V2 double le corpus (1 435 documents) avec 90 questions qui exigent de combiner des valeurs de plusieurs sources. L’agent doit lui-même trouver les bons documents. S’y ajoutent deux tests où le contexte utile est fourni : AA-LCR et la partie la plus longue de LongBench v2.
Le harnais fait la différence. Avec le même modèle, GLM-5.3-Flash, la réponse directe (des passages présélectionnés par un moteur de recherche classique, dans une fenêtre de 256 000 jetons) atteint 15,8 % de réponses exactes sur V1 et 4,4 % sur V2. Avec LongHarness, 60,2 % et 61,1 %. Le saut de 4,4 % à 61,1 % mis en avant par Elvis Saravia est réel, mais il compare un mode sans agent à un agent : Codex et Claude Code, avec le même modèle, atteignent déjà 46,6 % et 48,1 % sur V1.
Face aux harnais du marché. Sur V1, LongHarness devance Claude Code de 12 points (12,0 dans le texte, 12,1 d’après le tableau). Sur V2, il devance Codex de 18,9 points (61,1 % contre 42,2 %). Avec un autre modèle, Qwen3.8-Flash, il atteint 61,7 % sur V1, 8,3 points devant Claude Code ; mais sur V2, son avance sur Codex tombe à 1,1 point. Il obtient aussi les meilleurs scores sur LongBench v2 (75,9 % et 76,9 % selon le modèle) et AA-LCR (84,0 % et 87,0 %).
Pourquoi. Les tests d’ablation (retrait d’un composant à la fois) montrent que chaque mécanisme compte, surtout sur V2. Les parcours de LongHarness s’allongent aussi moins que ceux des concurrents quand le corpus grossit.
Les limites
- Une seule exécution par configuration pour les résultats principaux, faute de moyens de calcul. Trois exécutions avec GLM-5.3-Flash, en annexe, confirment toutefois l’avance (moyenne de 59,9 % sur V1 contre 49,4 % pour Claude Code).
- Des écarts qui dépendent du modèle : l’avance s’effondre sur V2 avec Qwen3.8-Flash.
- Peu de questions : 133 et 90 sur OfficeQA Pro, donc des scores sensibles à quelques réponses.
- Des budgets différents selon les harnais (200 tours pour Codex et Claude Code, 200 étapes et un plafond de lecture pour LongHarness), ce qui complique la comparaison.
- Pas de code publié ni de section dédiée aux limites.
Lecture Neurone21
C’est l’un des papiers les plus directement utiles pour les entreprises : interroger un fonds documentaire géant (archives financières, contrats, documentation technique) est un besoin courant. Le message rejoint une tendance de fond : à modèle égal, la façon d’organiser la recherche et la mémoire de l’agent peut peser plus lourd que le choix du modèle. L’idée centrale, distinguer explicitement ce qu’on sait, d’où on le sait et ce qui reste à trouver, est simple à transposer dans un outil maison.
Faute de code, il faudra cependant la réimplémenter, et la vérifier sur ses propres documents.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.13075
- Le PDF : https://arxiv.org/pdf/2610.13075
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2110083302728323346
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/longharness-advancing-agentic-reasoning-over-100m-token-corpora-via-stateful-evi-2610.13075