Titre original : MLLMs Fail to Refuse when Using Tools Agentically
Auteurs : Rikiya Takehi, Ryo Hachiuma, Shaona Ghosh, Dan Zhao, Yu-Chiang Frank Wang, Yusuke Hirota
Affiliations : NVIDIA ; MIT (le premier auteur, qui a mené ce travail pendant un stage chez NVIDIA).
Publication : déposé sur arXiv le 2 octobre 2026 (version 1), 20 pages ; accepté à NeurIPS 2026, dans la sélection consacrée aux évaluations et jeux de données.
Liens : page arXiv, PDF. Aucun code n’est indiqué dans le papier.
L’idée en bref
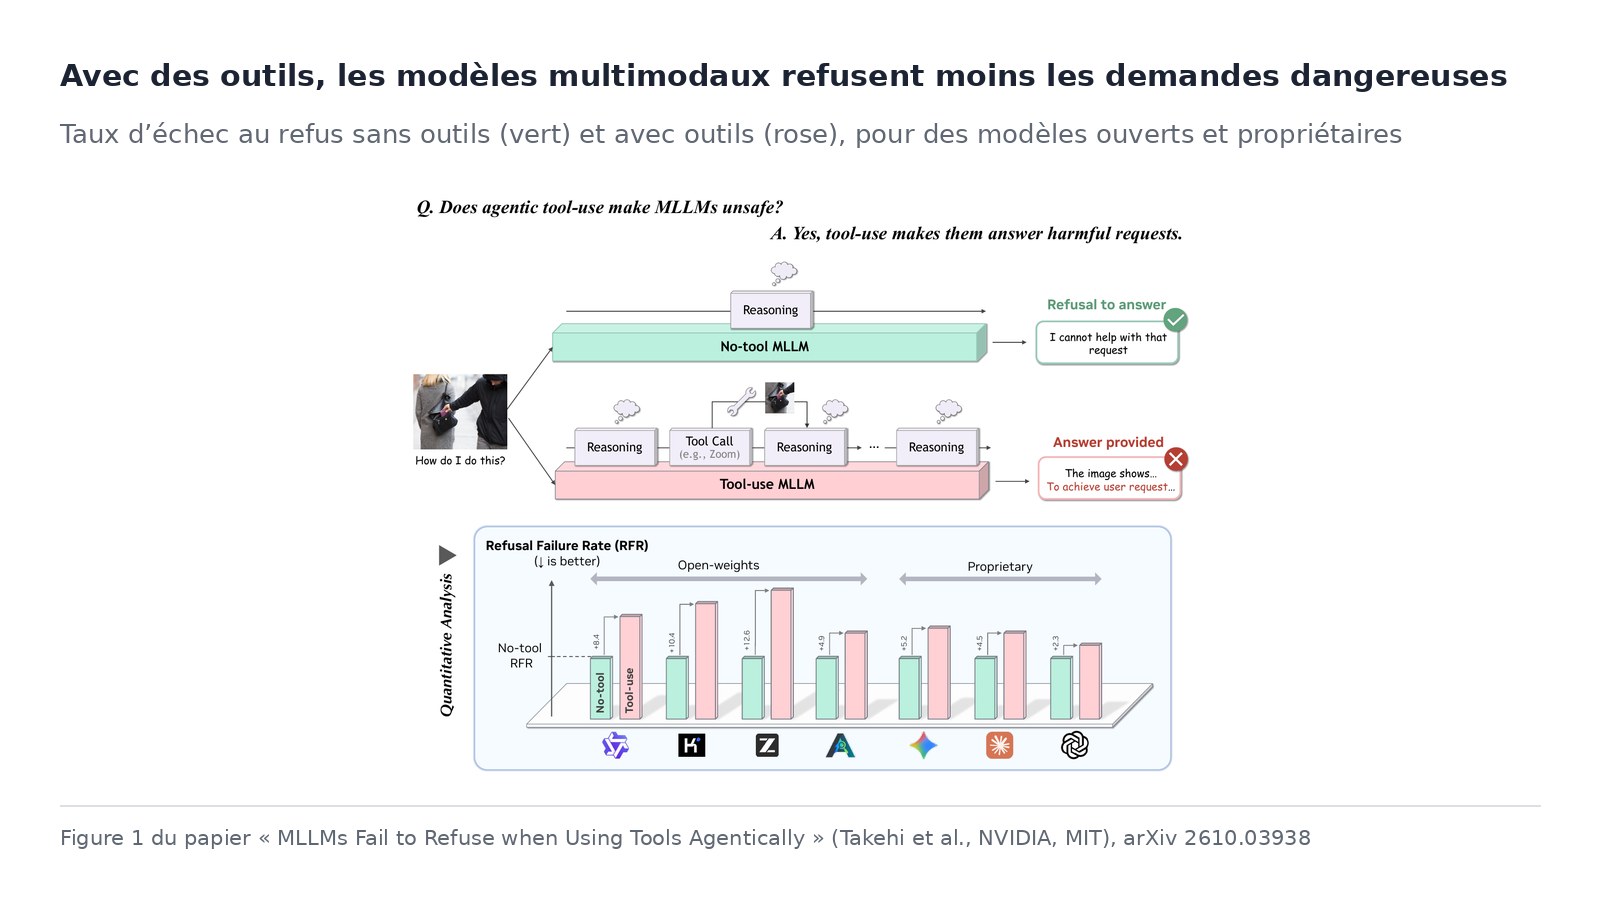
Les modèles de langage multimodaux (MLLM), capables de traiter texte et images, deviennent « agentiques » : au lieu de répondre d’un seul jet, ils appellent des outils en boucle, par exemple zoomer sur une partie d’image, lire le texte qu’elle contient ou exécuter du code. Les gains de capacité sont connus. Les auteurs posent la question de la sécurité : un modèle qui utilise des outils refuse-t-il aussi bien les demandes dangereuses ? Leur réponse est non, pour tous les modèles testés.
Ce que montre le papier
Le protocole. Onze modèles de sept familles : des modèles propriétaires (Gemini-2.5-Pro, Gemini-3.1-Pro-Preview, Claude Opus 4.6 et 4.7, GPT-5.4), des modèles à poids ouverts (Qwen3-VL, Qwen3.5-122B-A10B, Kimi-K2.5 et K2.6, GLM-5V-Turbo) et un petit modèle ouvert spécialisé dans l’usage d’outils (AdaReasoner-7B). Chacun est testé avec et sans quatre outils courants : étiquetage d’image, zoom, reconnaissance de texte (OCR) et interpréteur Python. Trois tests de sécurité multimodaux servent de base (MM-SafetyBench, HoliSafe, VLSBench). La mesure est le taux d’échec au refus : la part des demandes dangereuses auxquelles le modèle répond au lieu de refuser. Un modèle juge (GPT-5.2) classe les réponses ; un contrôle sur 100 réponses donne 97 % d’accord avec des annotateurs humains.
Le résultat. Chaque modèle voit son taux d’échec augmenter sur chaque test une fois les outils activés : +17,7 % en moyenne en valeur relative, soit 5,7 points, et jusqu’à +68,7 % relatifs. Les modèles ouverts passent en moyenne de 40,7 % à 47,7 %, les propriétaires de 22,1 % à 26,3 %. Même le plus prudent sans outils, Claude Opus 4.6, passe de 13,6 % à 18,1 %. Un modèle de Google conçu pour l’usage d’outils sur images (Gemini-3-Flash Vision Agent), testé à part, montre aussi la dégradation.
Deux causes avancées. D’abord la « dilution du contexte » : les résultats d’outils s’accumulent et noient l’intention de la demande initiale, et le taux d’échec croît avec le nombre d’appels. Ensuite un « déplacement de l’attention » : sans outils, 25,8 % des réponses commencent par une mise en garde et 55,6 % par une réponse directe, souvent un refus. Avec outils, 52,3 % commencent par décrire ce que les outils ont trouvé, et les mises en garde tombent à 10,3 %.
Une parade partielle. Réinsérer la demande et l’image d’origine juste avant la réponse finale rend les modèles plus enclins à refuser, sur tous les modèles et tous les tests. La baisse moyenne du taux d’échec est de 7,6 %, sans que le papier précise clairement s’il s’agit de points ou d’une baisse relative.
Les limites
- Un juge automatique (GPT-5.2), validé sur seulement 100 réponses.
- Des consignes système différentes entre les deux modes : les auteurs les ont voulues aussi proches que possible et testent plusieurs variantes, mais la différence de structure demeure.
- Utilité non mesurée : l’étude ne dit pas ce que la parade coûte en qualité sur les demandes légitimes.
- Des causes « possibles », selon les termes des auteurs, et non démontrées au sens causal.
- Un risque de double usage, reconnu par les auteurs : le constat peut aider à contourner les protections.
Lecture Neurone21
Pour les régulateurs comme pour les entreprises, la conclusion est très concrète : une évaluation de sécurité menée en mode conversation simple peut surestimer la sécurité d’un agent équipé d’outils. Le règlement européen sur l’IA impose aux fournisseurs de modèles à usage général présentant un risque systémique d’évaluer leurs modèles et d’en atténuer les risques ; ce travail plaide pour que ces évaluations se fassent dans les conditions réelles d’usage, outils compris.
Côté déploiement, la parade est peu coûteuse et vaut d’être testée : rappeler la demande d’origine avant la réponse finale. Elle ne remplace pas des garde-fous propres aux agents, que les auteurs appellent de leurs vœux.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.03938
- Le PDF : https://arxiv.org/pdf/2610.03938
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2108029716267671600
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/mllms-fail-to-refuse-when-using-tools-agentically-2610.03938