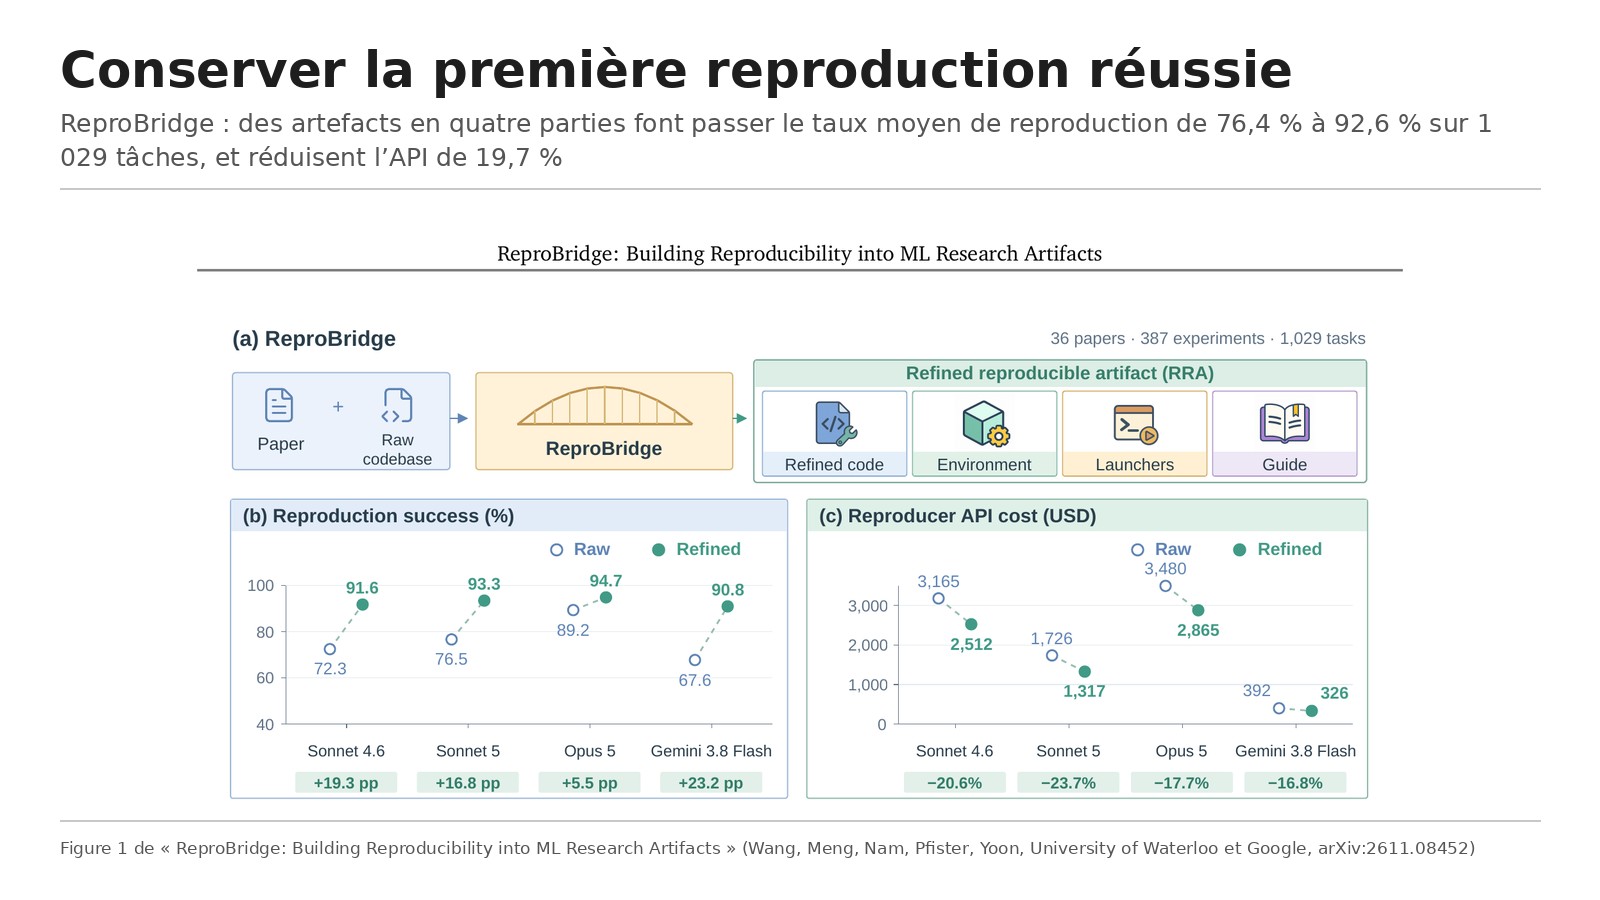
Titre original : ReproBridge: Building Reproducibility into ML Research Artifacts
Auteurs : Yubo Wang, Rui Meng, Jaehyun Nam, Tomas Pfister et Jinsung Yoon.
Affiliations : University of Waterloo et Google. Yubo Wang est affilié aux deux ; les quatre autres auteurs sont affiliés à Google.
Publication : prépublication arXiv 2611.08452v1 (cs.AI), déposée le 5 novembre 2026, 38 pages avec annexes.
Liens : page arXiv, PDF, page du projet.
L’idée en bref
Reproduire une expérience d’apprentissage automatique, ce n’est pas seulement cloner un dépôt. Il faut souvent reconstruire des détails dispersés entre le papier, le code publié et l’environnement : dépendances incompatibles, configuration prévue, correction d’un chargeur de données, passage des sorties au score annoncé. Quand un agent y parvient, ces décisions restent souvent enfouies dans une conversation ou un historique de terminal. Le suivant recommence l’enquête.
Les auteurs standardisent un artefact reproductible raffiné en quatre parties : un code nettoyé, une procédure d’environnement, des lanceurs d’expériences et un guide de reproduction. ReproBridge est le flux d’agents qui construit cet artefact à partir du papier et du dépôt officiel. L’hypothèse : conserver les procédures récupérées lors d’une première reproduction améliore les tentatives suivantes, indépendantes.
Ce que montre le papier
Un banc d’essai ancré dans des reproductions humaines
ReproBridge-Bench part de 742 papiers Spotlight d’ICML 2026, en retient 36 avec une implémentation officielle accessible, et en extrait 1 463 mesures des tableaux principaux. Cinq reproducteurs humains, chacun sur un serveur séparé et à partir du même commit, fournissent cinq scores de référence par tâche. 1 029 tâches (70,3 %), issues de 387 expériences, ont des références compatibles avec le score publié et forment le jeu d’évaluation : 701 stables et 328 plus variables. Les 434 autres se répartissent entre désaccord numérique (183), blocage d’exécution (186) et limite de ressources ou d’accès (65). Un auditeur séparé vérifie que le nombre rendu vient bien d’une exécution nouvelle, car un chiffre proche peut masquer une mesure substituée.
Le raffinement relève tout le monde au-dessus de 90 %
Quatre modèles sont évalués trois fois en session neuve, avec le code brut ou l’artefact raffiné : Claude Sonnet 4.6, Claude Sonnet 5, Claude Opus 5 et Gemini 3.8 Flash (Tableau 3, identifiants en annexe, Tableau 11). Le taux moyen de reproduction passe de 76,4 % à 92,6 %. Les gains vont de 5,5 points pour Opus 5 (de 89,2 % à 94,7 %) à 23,2 points pour Gemini 3.8 Flash (de 67,6 % à 90,8 %). L’écart entre le meilleur et le plus faible tombe de 21,6 à 3,9 points. Les dépenses d’API des sessions de reproduction baissent de 16,8 % à 23,7 %, soit 19,7 % en moyenne. Ces coûts d’API excluent la construction, l’audit et les GPU.
Sur 45 capsules de CORE-Bench Hard, le même type d’artefact fait passer le succès de 62,2 % (code brut) à 73,3 %, le temps médian de 33 à 14,4 minutes, et le coût par capsule réussie de 8,43 $ à 4,34 $.
Chaque composant compte, le code et l’environnement le plus
Une ablation sur 287 tâches et 12 papiers, avec Sonnet 5, compare le code brut (73,9 %), les sorties ordinaires d’une exécution (81,2 %) et l’artefact complet (93,0 %). Enlever le code raffiné coûte 5,2 points, l’environnement 4,5, le guide 3,8 et les lanceurs 3,1. Dans la première évaluation, 813 échecs sur code brut deviennent des succès avec l’artefact, contre 136 retours en arrière. Un exemple concret : dans Effective Model Pruning, le chargeur publié étiquette les 10 000 images de validation de TinyImageNet comme une seule classe ; avec l’artefact, la perte de validation d’un ResNet-18 passe de 8,898 à 2,288, proche des 2,303 du papier.
Les limites
- jeu retenu, pas un taux de conférence : l’évaluation porte sur 36 papiers sélectionnés et sur les agents testés ;
- cinq observations de référence sont un choix de protocole, pas une garantie d’incertitude suffisante ;
- compatibilité numérique ne prouve ni la validité scientifique ni une fidélité complète ; un artefact raffiné peut aussi conserver une mauvaise hypothèse ;
- audits automatiques imparfaits : face à une relecture humaine de 818 issues, l’auditeur principal (Codex) a une précision de 88,6 % et un rappel de 79,5 % ;
- économies d’API mesurées sur les sessions de reproduction suivantes ; construire les 36 artefacts a coûté 5 026 $ d’API (139,61 $ par papier), hors GPU, audit et relecture humaine.
Lecture Neurone21
Le geste utile n’est pas de changer de modèle dès qu’un agent n’arrive pas à relancer un dépôt. C’est de figer ce que la première exécution réussie a dû inventer : versions, commande d’installation, script qui lance vraiment l’expérience, et la règle qui transforme les fichiers de sortie en chiffre de tableau. Sans cela, le prochain agent paie à nouveau l’enquête.
Steropes, qui fait travailler plusieurs bots en relais sur du code et de la recherche, peut reprendre ce format en quatre parties comme livrable interne : ce n’est pas un journal de conversation, c’est un paquet qu’un autre agent (ou une autre personne) peut exécuter sans le contexte d’origine. Un chiffre qui « tombe juste » ne suffit pas : le papier montre qu’il faut aussi garder la preuve de l’exécution.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 7 novembre 2026 (15:14 UTC, 16:14 heure de Paris), puis l’a reposté le 8 novembre 2026 (04:20 heure de Paris). Nous avons lu la version officielle arXiv 2611.08452v1. Écarts avec le post :
Le post est fidèle aux chiffres de l’abstract et du Tableau 3 : 76,4 % à 92,6 %, baisse d’API de 19,7 %, 1 029 tâches et 36 papiers, cinq scores de référence, écart de 21,6 à 3,9 points, et pertes les plus fortes quand on retire le code ou l’environnement. Il n’indique pas que les 1 029 tâches viennent de 387 expériences, ni que la baisse d’API exclut les 5 026 $ de construction. « Google » correspond aux affiliations : quatre auteurs sont chez Google, le premier aussi à l’Université de Waterloo.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.08452
- Le PDF : https://arxiv.org/pdf/2611.08452
- La page du projet : https://wyyyb.github.io/reprobridge_website/
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2119085975880212842
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/reprobridge-building-reproducibility-into-ml-research-artifacts-2611.08452