Titre original : The uneven rise of AI-generated web content
Auteurs : Adam Visokay (université de Californie à Berkeley), Soumyakanti Pan (université de Washington), Molly Griston (université du Colorado à Boulder), Polina Iasakova (université d’État de l’Oregon), Mark Nepf (université de Washington), Denis Peskoff (Berkeley), Riya Sinha et Yiwei Wu (université du Texas à Austin), Jikai Sun (université du Minnesota), Isabelle Thiara (université de Washington), Letao Wang (université Washington de Saint-Louis), Lauren Yan (centre médical de l’université du Kansas) et Tyler H. McCormick (université de Washington). Adam Visokay et Soumyakanti Pan sont co-premiers auteurs. Tous ont participé, comme organisateurs ou participants, à l’école d’été en sciences sociales computationnelles 2026 de l’université de Washington (SICSS-UW).
Publication : prépublication arXiv 2610.36631v1 (cs.AI), déposée le 27 octobre 2026, 61 pages avec les annexes.
Liens : page arXiv, PDF.
L’idée en bref
Combien de pages du web public contiennent aujourd’hui du texte écrit ou retouché par un modèle de langage ? La question compte doublement : le web est à la fois ce que lisent les clients et les citoyens, et la principale matière première des futurs modèles. Si une part croissante de ce texte vient d’anciens modèles, les nouveaux apprendront de plus en plus de leurs prédécesseurs.
Les auteurs ne se contentent pas de passer un détecteur sur des pages. Ils partent du principe qu’un détecteur se trompe, dans les deux sens, et pas de la même façon selon la langue, le type de site ou la longueur du texte. Ils combinent donc deux détecteurs, mesurent leurs erreurs sur des corpus étiquetés et sur des pages antérieures à 2022 (où le texte IA est supposé quasi absent), puis corrigent leurs estimations avec un modèle statistique bayésien qui propage cette incertitude jusqu’aux chiffres publiés (introduction et section 4.3).
Ce que montre le papier
Un échantillon de 5,1 millions de pages
L’étude porte sur 5 118 347 pages issues de 505 974 domaines, tirées de 71 collectes du Common Crawl entre janvier 2019 et août 2026. Seules les pages avec au moins 500 caractères de texte extrait sont retenues, ce qui exclut les pages de navigation ou de connexion. L’échantillon est stratifié selon la place du domaine dans le graphe des liens du web (six niveaux de PageRank, du « Top » au « Tail »), puis redressé pour représenter l’ensemble des pages éligibles (section 2). Le détecteur principal est la version ouverte de Pangram, un classifieur affiné à partir de Llama-3.2-3B ; le second, Binoculars avec le couple Falcon-7B, n’est utilisé que sur les pages en anglais (section 4.2).
Un quart des pages en août 2026, et une hausse qui accélère
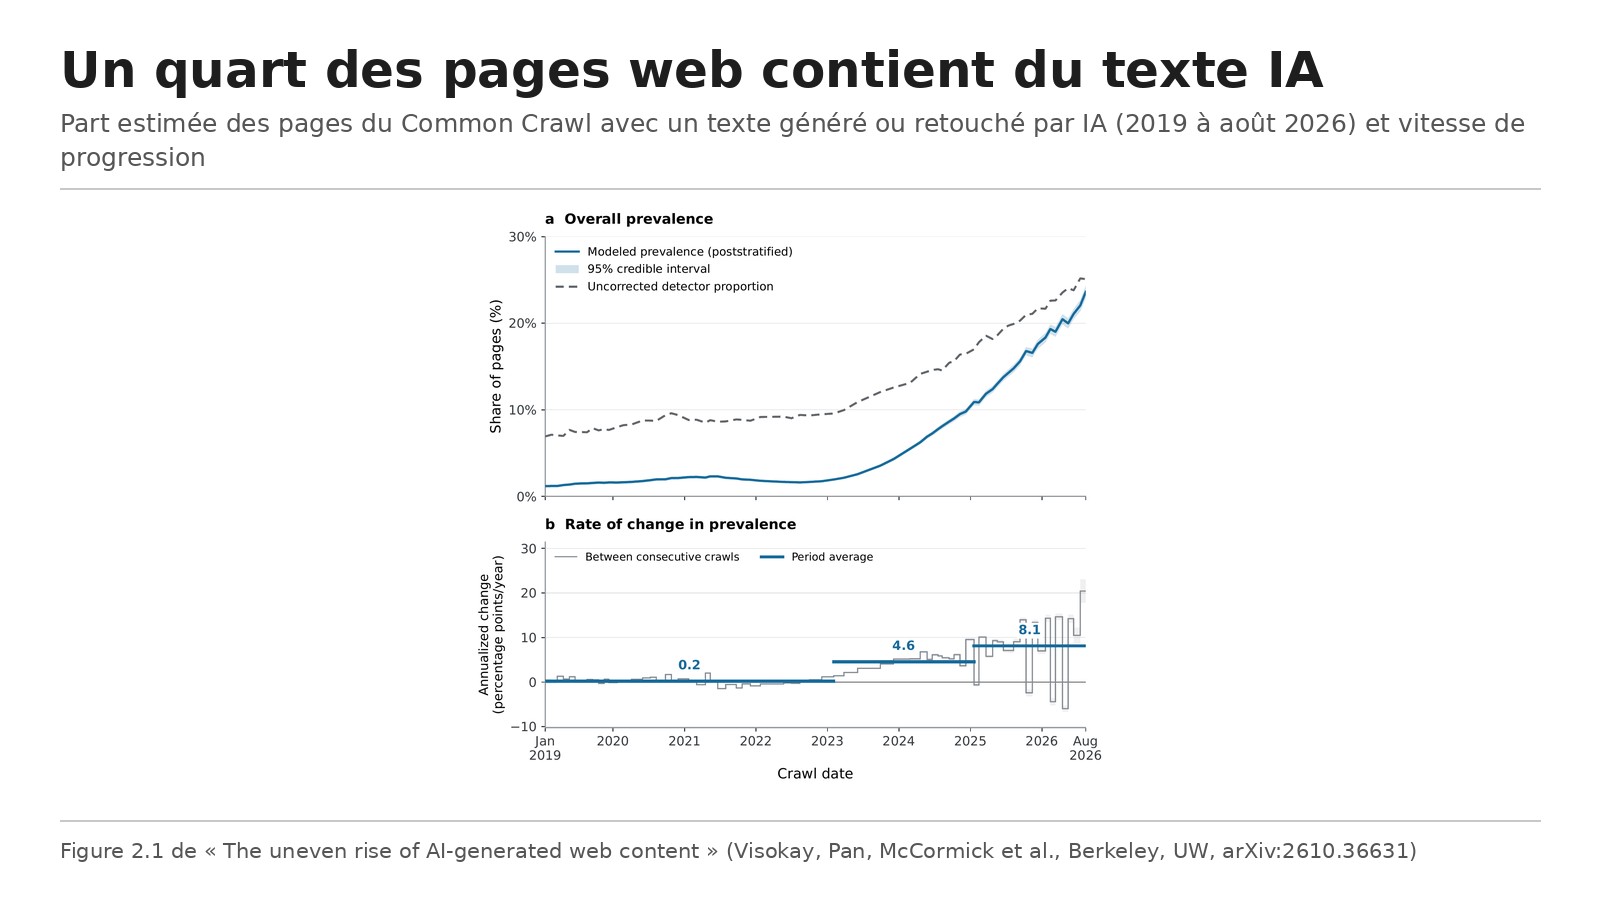
En août 2026, les auteurs estiment qu’environ une page sur quatre contient un texte entièrement généré ou retouché par IA : environ 24 % (23,6 % pour le modèle retenu, intervalle de crédibilité à 95 % de 22,9 à 24,4 %). Avant fin 2022, la part était proche de zéro. La progression annuelle moyenne était de 0,2 point de 2019 à février 2023, de 4,6 points de février 2023 à janvier 2025, puis de 8,1 points de janvier 2025 à août 2026 (section 2.1 et figure 2.1). La courbe brute du détecteur, sans correction, donne des valeurs nettement plus élevées sur toute la période, signe que ses faux positifs pèsent lourd.
Les petits sites tirent la hausse
Le texte IA a atteint tous les niveaux du web, mais pas au même rythme. En août 2026, il touche 11,6 % des pages des domaines les plus centraux (plateformes, grandes institutions, grands médias) et 27,5 % des pages du niveau le moins central, celui des petites entreprises, associations locales et sites personnels. Les deux niveaux les plus périphériques, qui regroupent 99 % des domaines et 70,5 % des pages éligibles, expliquent 78,8 % de la hausse totale depuis décembre 2021. L’écart tient après correction de la composition des niveaux par langue, type de domaine et longueur (section 2.2 et figure 2.2).
L’anglais et le .com en tête, les .gov et .edu loin derrière
En août 2026, 32,8 % des pages uniquement en anglais contiennent du texte IA, contre 17,0 % des pages sans anglais, et l’écart se creuse : la hausse annuelle est de 10,8 points pour l’anglais contre 4,8 points pour les autres langues depuis janvier 2025 (section 2.3). Par type de domaine, la part atteint 29,5 % sur les .com, 20,4 % sur les .net, 14,6 % sur les .org, 6,1 % sur les .edu et 5,8 % sur les .gov. À composition identique, l’écart entre .com et .gov se réduit de 23,6 à 18,9 points, mais il reste large (section 2.4 et figure 2.4).
Un détecteur ne prouve rien à lui seul
Les mesures d’erreur sont parlantes. Sur des pages anglaises antérieures à 2022, où presque tout signalement est une erreur, le détecteur ouvert de Pangram signale à tort 4,5 % des pages uniquement en anglais et 28,5 % des pages bilingues, alors qu’il est réglé pour 1 % de faux positifs sur des textes de référence. En langues autres que l’anglais, il ne repère que 36,3 % des textes IA d’un corpus étiqueté (sections 4.2 et 4.2.4). Les auteurs insistent dans leur discussion : un score de détecteur est un indice, pas une preuve d’auteur, et ils citent le Caine Prize for African Writing : en octobre 2026, quelques jours après la remise du prix, la nouvelle lauréate a été placée sous examen parce qu’un détecteur commercial la jugeait presque entièrement générée par IA, ce que son auteur dément (section 3).
Les limites
Les auteurs reconnaissent que (section 5) :
- le Common Crawl ne couvre que les pages accessibles à un robot d’indexation : les contenus derrière une connexion, dans les applications ou sur les sites qui bloquent les robots en sont absents, dont une grande partie des réseaux sociaux ;
- seuls les textes d’au moins 500 caractères sont mesurés, faute de détecteurs fiables sur les textes courts : posts, commentaires et avis isolés échappent à l’étude ;
- une page qui regroupe des textes courts (fil de commentaires, liste d’avis) est notée comme un seul document ;
- le modèle ne tient pas compte de la ressemblance entre pages d’un même domaine, ce qui aurait rendu le calcul impraticable sur plus de 500 000 domaines.
Réserves de notre lecture, tirées du papier :
- Les erreurs des deux détecteurs ne sont pas indépendantes sur les textes IA (corrélation de 0,27 sur le corpus RAID), alors que le modèle les suppose indépendantes ; les auteurs estiment que ce biais tend à sous-estimer la part de texte IA (section 4.2.2).
- La sensibilité hors anglais repose sur un seul corpus multilingue, avec des textes de modèles de 2023 et sans le français, l’espagnol, le néerlandais ou le japonais (section 4.2.4). Le chiffre global vaut pour le web dans son ensemble, pas pour le web francophone.
- L’étude mesure la présence d’un texte IA dans une page, pas sa part dans la page ni sa qualité : une page entièrement générée et une page simplement relue par IA comptent pareil.
Lecture Neurone21
Pour une entreprise, ce papier dit deux choses très concrètes. La première concerne sa propre communication : sur les sites .com, près de trois pages sur dix contiennent déjà du texte IA, et la proportion la plus forte se trouve chez les petites structures. Écrire avec une IA est devenu banal ; ce qui distingue désormais un site, c’est un contenu vérifié, daté, signé et appuyé sur une expérience réelle. Les institutions publiques et éducatives, beaucoup plus prudentes, montrent qu’un usage plus mesuré reste possible.
La seconde concerne les données. Toute équipe qui constitue un corpus à partir du web pour entraîner, affiner ou alimenter un RAG interne récupère aujourd’hui une part importante de texte produit par des modèles, surtout en anglais et sur les petits sites. Filtrer par date, privilégier les sources institutionnelles et garder la trace de l’origine de chaque document devient une bonne pratique, pas un luxe.
Enfin, la leçon méthodologique vaut pour les ressources humaines, l’enseignement ou les achats : un détecteur de texte IA se trompe, parfois beaucoup, et différemment selon la langue. Il ne doit jamais servir seul à juger un candidat, un élève ou un fournisseur.
Le post d’Elvis Saravia reprend fidèlement les chiffres principaux : plus de 5 millions de pages de 2019 à 2026 et environ 24 % de pages avec du texte généré ou retouché par IA en août 2026. Il ne précise pas qu’il s’agit d’une estimation corrigée des erreurs des détecteurs, avec un intervalle de 22,9 à 24,4 %, ni que la mesure exclut les réseaux sociaux et les textes courts. Le résumé du papier parle de « près de 25 % » ; le corps du texte retient 24 %.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.36631
- Le PDF : https://arxiv.org/pdf/2610.36631v1
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2115497580746719303
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/the-uneven-rise-of-ai-generated-web-content-2610.36631