Titre original : System Optimizations for Cost-Efficient Agent Harnesses
Auteurs : Jongseok Park, Jiaxiang Yu, Eric Zhou, Tony Hong, Sunga Kim, Yusuf Afifi, Ian Wong, Ion Stoica et Alvin Cheung (auteur de correspondance).
Affiliations : University of California, Berkeley, Northwestern University et University of Illinois Urbana-Champaign.
Publication : prépublication arXiv 2611.12122v1 (cs.AI), déposée le 9 novembre 2026.
Liens : page arXiv, PDF.
L’idée en bref
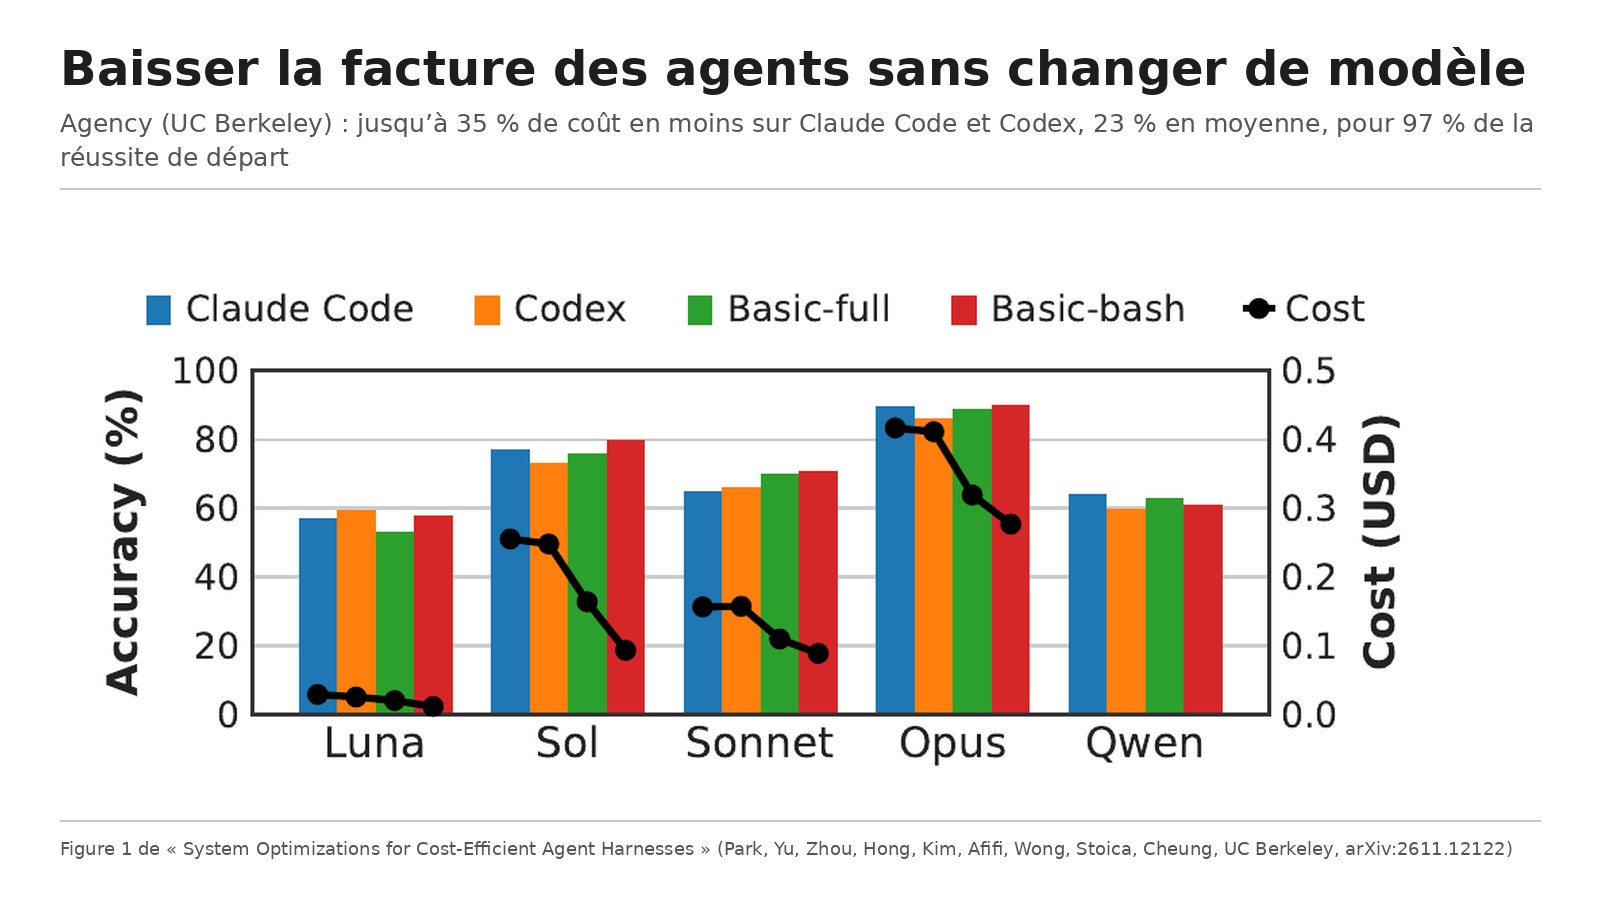
Un harnais, c’est le logiciel qui entoure le modèle dans un agent : la consigne système, les outils, la boucle d’appels. Claude Code et Codex en sont deux exemples très utilisés. L’équipe de Berkeley part d’un constat : avec les modèles récents, le harnais change peu le taux de réussite, mais il change beaucoup la facture. Sur 100 tâches de code, un harnais réduit au seul outil bash réussit à peu près aussi bien que Claude Code ou Codex, alors que ces deux derniers coûtent facilement deux fois plus, à cause de consignes et d’outils plus longs.
Plutôt que de toucher au modèle, les auteurs cherchent où l’argent part pendant une session, puis construisent Agency, une couche qui s’intercale entre un harnais existant et le modèle, sans modifier ni l’un ni l’autre, pour y brancher des économies.
Ce que montre le papier
Où part l’argent
À chaque tour, l’agent renvoie tout son contexte au modèle. Même mis en cache et facturé bien moins cher, ce contexte relu finit par dominer : sa part du coût passe de 13 % et 30 % pour les sessions courtes à 53 % et 73 % au-delà de 256 000 jetons. À taille de contexte égale, une session qui multiplie les appels d’outils coûte de 1,6 à 26 fois plus. Les sorties d’outils sont peu utiles : l’agent ne réutilise que 27 % de leurs jetons, et 36 % des sorties ne servent jamais. Dans les tâches de recherche documentaire, 57 % à 89 % des tours servent à fouiller les fichiers, pour 22 % à 50 % du coût, et 42 % des listages de dossiers répètent ce qu’une autre session a déjà fait.
Cinq techniques, une seule couche
Agency capte tout ce que fait le harnais (appels au modèle, processus lancés, accès aux fichiers) et laisse y brancher des règles. Les auteurs ont vérifié qu’elle ne coûte rien en soi : sur cinq tâches répétées 100 fois avec Claude Code, l’écart de coût est de -1,50 %, avec un intervalle de confiance de -4,69 % à +2,04 %. Ils y ont branché cinq techniques : compacter les sorties d’outils avant qu’elles entrent dans le contexte, retirer du contexte les lignes devenues inutiles à l’aide d’arbres de décision, résumer chaque sous-tâche terminée, remplacer les fouilles de dossiers par une table SQLite des fichiers, et pousser l’agent à regrouper ses appels d’outils.
Les résultats
Testé avec Claude Code, Codex et un harnais minimal, sur quatre modèles et 200 tâches (code et recherche documentaire), l’ensemble ramène le coût moyen à 0,77 fois celui de départ, avec un taux de réussite à 0,97 fois. Selon le modèle et le harnais, le coût va de 0,65 à 0,85 fois, d’où le « jusqu’à 35 % » du résumé. Les gains sont plus forts sur Codex (0,75) que sur Claude Code (0,81). Le plus petit modèle, GPT-6 Luna, perd un peu plus en réussite (0,93), car il suit mal les consignes d’usage de la table SQLite.
C’est en recherche documentaire que l’effet est le plus net : avec des fichiers aux noms aléatoires rangés dans une arborescence profonde, le coût tombe à 0,51 à 0,66 fois. Sur le code, il reste entre 0,80 et 0,96 fois. Prise seule, la table des fichiers baisse le coût de 32 %. Le regroupement des appels, lui, l’augmente de 2 % avec GPT-6 Luna, qui ajoute des appels inutiles pour regrouper.
Les limites
Les auteurs signalent que leurs bancs d’essai sont deux à trois fois plus courts que les sessions réelles, ce qui sous-estime selon eux les économies possibles. Les potentiels de la partie analyse sont mesurés après coup et doivent être lus comme des maximums théoriques. Entre 17 % et 29 % des tâches coûtent plus cher avec Agency, souvent les plus courtes, où il y a peu à retirer. Les résultats dépendent de la formule de facturation actuelle des fournisseurs, qui peut changer. Enfin, le code d’Agency n’est pas publié avec le papier.
Lecture Neurone21
Pour une entreprise qui paie des agents de code à l’usage, le message est simple : la facture se joue surtout sur la longueur des sessions et le nombre d’appels, pas sur le choix d’un harnais plus riche. Les leviers les plus faciles à reprendre ne demandent pas Agency : ouvrir une nouvelle session par tâche, ranger les fichiers avec des noms parlants, fournir un index du dépôt ou du corpus documentaire, et surveiller le nombre d’appels d’outils par tâche en plus de la taille du contexte.
Le papier rappelle aussi qu’une économie de jetons n’est pas forcément une économie d’argent : compresser un contexte déjà en cache coûte une réécriture, et retirer une information dont l’agent a besoin lui fait faire des tours de plus. C’est un bon garde-fou avant d’acheter un outil qui promet de « réduire les jetons ».
D’où vient ce papier
DAIR.AI (@dair_ai) l’a présenté le 10 novembre 2026 à 18:18 heure de Paris, et Elvis Saravia (@omarsar0) a reposté ce post le 12 novembre à 02:59 heure de Paris. Nous avons lu la version officielle arXiv 2611.12122v1. Écarts avec le post :
Le post attribue aux chercheurs de Berkeley le constat qu’un changement de harnais fait varier le coût « jusqu’à 2,6 fois » sur le même modèle. Dans le papier, ce chiffre de 2,6 est repris d’études antérieures ; la mesure propre des auteurs montre Claude Code et Codex à environ deux fois le coût des harnais minimaux. Le post ne précise pas non plus que les 35 % sont le meilleur cas, la moyenne étant de 23 %, ni que la réussite baisse de 3 % en moyenne.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.12122
- Le PDF : https://arxiv.org/pdf/2611.12122
- Le post de DAIR.AI reposté par Elvis Saravia : https://x.com/dair_ai/status/2120204345602101457
- Notre fiche sur ParetoSaddler, qui optimise un harnais sur la qualité et le coût : /p/optimisation-agent-cout-qualite-paretosaddler