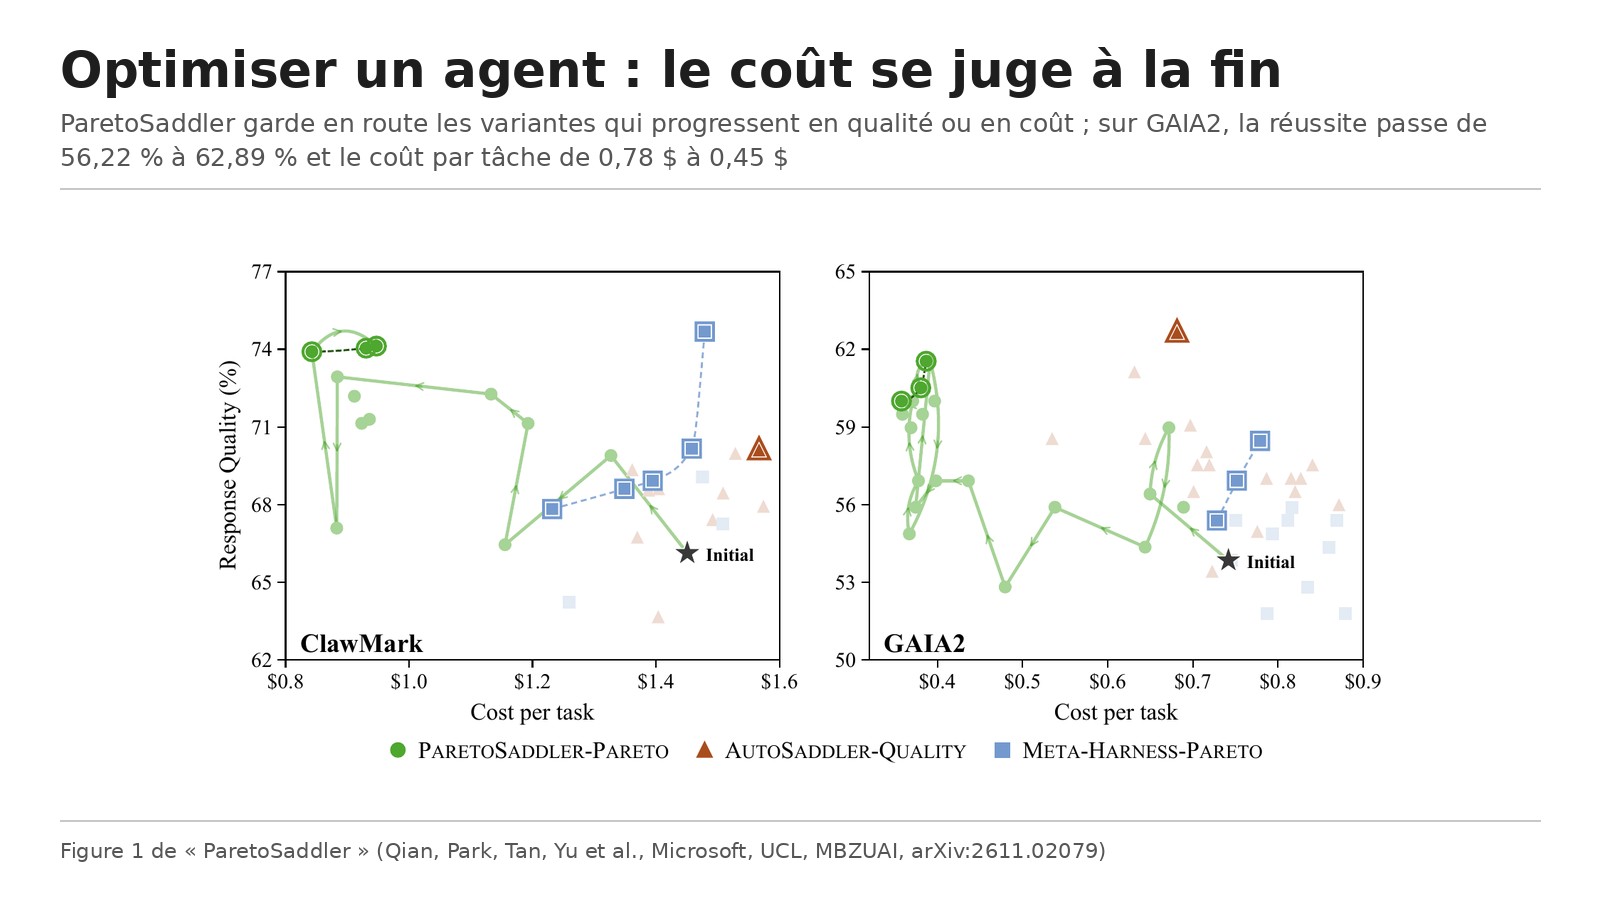
Titre original : ParetoSaddler: Pareto-Guided Optimization of Agent Harnesses for Quality and Cost
Auteurs : Xingzhi Qian, Sungho Park, Rongyuan Tan, Jianbo Yu (contribution égale), Jue Zhang (auteur de correspondance), Lorenzo Cavallaro, Menglin Xia, Yanzhi Chen, Xinnuo Xu, Yu Kang, Xinran Zheng, Gagan Somashekar, Xuchao Zhang, Chetan Bansal, Qingwei Lin et Victor Rühle (16 auteurs).
Affiliations : Microsoft, University College London, POSTECH, SUSTech, Southeast University et MBZUAI. Les quatre premiers auteurs ont mené ce travail pendant un stage chez Microsoft.
Publication : prépublication arXiv 2611.02079v1 (cs.AI), déposée le 1er novembre 2026.
Liens : page arXiv, PDF.
L’idée en bref
Un agent, ce n’est pas seulement un modèle de langage. C’est aussi un harnais : les consignes, les outils, la mémoire et le code qui entourent le modèle. Des méthodes récentes, comme Meta-Harness ou AutoSaddler (le socle sur lequel ParetoSaddler est construit), laissent un autre modèle réécrire ce harnais par petites modifications, en gardant celles qui améliorent le score. Le plus souvent, elles ne regardent que la qualité.
ParetoSaddler ajoute le coût, avec une règle précise : pendant la recherche, une modification est gardée dès qu’elle progresse sur la qualité ou sur le coût, même si elle dégrade l’autre pour l’instant. La préférence finale (par exemple « la meilleure qualité sous un budget donné ») ne s’applique qu’à la fin, au moment de choisir le harnais à déployer. Chaque candidat est évalué plusieurs fois, et un test statistique (le bootstrap bayésien) décide si le progrès observé est crédible ou s’il s’explique par le hasard des essais.
Ce que montre le papier
Une meilleure réussite pour un coût moindre
Les auteurs testent sur deux bancs d’essai : ClawMark (92 tâches, dont 22 pour le test) et GAIA2 (300 tâches de test), deux bancs d’agents qui enchaînent de longues séquences d’actions (ClawMark simule des collègues-agents dans des métiers, avec état persistant et outils). Les groupes de tâches de test (par exemple e-commerce, journalisme et assistant juridique pour ClawMark) sont distincts de ceux utilisés pendant la recherche. Les chiffres sont des moyennes sur trois répétitions sur les tâches de test, avec leur écart-type. Le coût est celui du modèle qui exécute les tâches, calculé avec une grille de prix.
Sur ClawMark, le harnais initial atteint 70,86 % de réussite pour 1,17 $ par tâche ; la version retenue par ParetoSaddler (variante PS-ParetoQ) atteint 81,35 % pour 1,01 $. Sur GAIA2, on passe de 56,22 % pour 0,78 $ à 62,89 % pour 0,45 $. En relatif, le papier annonce plus 14,8 % de qualité et moins 13,7 % de coût sur ClawMark, plus 11,9 % de qualité et moins 42,3 % de coût sur GAIA2.
Plus de qualité et moins de coût que l’optimisation sur la qualité seule
La référence qui n’optimise que la qualité (AutoSaddler-Quality) obtient 73,86 % pour 1,24 $ sur ClawMark et 57,33 % pour 0,61 $ sur GAIA2. ParetoSaddler fait mieux sur les deux axes : 7,49 points de plus sur ClawMark, 5,56 points de plus sur GAIA2, avec un coût plus bas. La version la moins chère de l’ensemble de Pareto, PS-ParetoC, atteint 79,60 % pour 0,92 $ sur ClawMark et 62,11 % pour 0,47 $ sur GAIA2. La variante qui minimise le coût en gardant la qualité à moins de 10 points sous le départ, PS-MinCost, atteint 75,16 % pour 0,82 $ et 56,11 % pour 0,44 $. Le point de comparaison Meta-Harness en version Pareto reste à 73,25 % pour 1,06 $ et 54,33 % pour 0,83 $.
Pourquoi ça marche : les essais répétés et la porte de promotion
Les auteurs retirent une pièce à la fois. Sur ClawMark, dans le réglage qui minimise le coût (PS-MinCost), une porte de promotion qui ne regarde que le coût laisse passer 3 modifications, contre 11 avec la porte de Pareto. Un exemple du papier : une modification (le candidat I-11) fait monter la qualité sur un petit lot de 83,65 % à 87,62 % au prix de 10,5 % de coût en plus, ce qu’un filtre sur le coût aurait rejeté ; conservée, elle sert de base aux révisions suivantes (I-14, I-16), et le harnais final obtient un meilleur point de test.
Évaluer une seule fois au lieu de trois fait tomber la qualité finale de 81,35 % à 75,71 % sur ClawMark. Remplacer le test bayésien par une simple moyenne la fait tomber à 76,53 % pour 1,15 $. Les auteurs rappellent que la même tâche, répétée, varie de 18,8 % en qualité et de 25,6 % en coût (coefficient de variation moyen entre les répétitions) : sans répétition, on promeut du bruit.
Le coût de l’optimisation elle-même
Sur GAIA2, le modèle optimiseur coûte plus cher par modification proposée avec ParetoSaddler : 9,62 $ par patch, contre 6,01 $ pour AutoSaddler-Quality et 5,42 $ pour Meta-Harness en version Pareto. Les essais répétés ont un prix, que le papier chiffre.
Les limites
Les auteurs signalent que :
- répéter les évaluations alourdit le budget d’optimisation, et le bootstrap capture la variation entre répétitions plutôt que celle due au choix des tâches ;
- une seule règle de promotion est étudiée, sur deux bancs d’essai seulement, avec une mesure de qualité et de coût en jetons ; ni la sécurité ni la confidentialité ne sont évaluées, et le papier précise que ces gains ne prouvent pas qu’un agent est prêt pour un déploiement réel ;
- sur ClawMark, seules les tâches du premier stade sont utilisées ;
- le code et le site du projet « seront disponibles » (https://aka.ms/ParetoSaddler-website) : rien n’est encore publié, donc rien n’est vérifiable de l’extérieur.
Réserves de notre lecture :
- les auteurs sont majoritairement de Microsoft, et le papier évalue sa propre méthode, sans reproduction indépendante ;
- les coûts sont ceux de l’agent qui exécute les tâches sous une grille de prix donnée (GPT-5.4 pour ClawMark, GPT-5.5 pour GAIA2), pas le coût total de l’optimisation ; un changement de tarifs peut déplacer les résultats ;
- les gains sont mesurés sur le jeu de test des deux mêmes bancs que ceux de la recherche (domaines distincts), avec trois répétitions seulement : sur ClawMark, l’écart-type est de 3,11 points pour PS-ParetoQ et de 3,54 points pour AS-Quality.
Lecture Neurone21
Pour une équipe qui règle les consignes et les outils d’un agent métier, la leçon pratique tient en deux gestes. Mesurer chaque essai plusieurs fois avant de garder une modification, parce que la même tâche donne des résultats très différents d’un passage à l’autre. Et suivre le coût en même temps que la réussite dès le départ, sans le réserver au choix final.
Un exemple concret : pour un agent qui répond aux demandes de remboursement d’une boutique, une consigne plus longue peut améliorer la précision tout en coûtant 10 % de plus par conversation. Si le coût sert de filtre dès le début, cette consigne disparaît avant d’avoir pu servir de base à une version plus économique. Le papier montre que garder les deux pistes ouvertes jusqu’à la fin a permis d’obtenir les harnais les plus intéressants.
Ce résultat prolonge nos fiches sur le harnais auto-amélioré testé sur ARC-AGI-3 et sur le harness learning de CMU, et il complète notre dossier sur le harnais des agents IA. À lire avec prudence : deux bancs d’essai, une méthode pas encore publiée, et des coûts propres à une grille de prix donnée.
Le post d’Elvis Saravia est fidèle au papier : la préférence de coût est bien appliquée à la fin, et les harnais choisis par Pareto battent bien l’optimisation sur la qualité seule sur les deux axes. Précisions : les pourcentages de réussite sont des points absolus sur le jeu de test, et les pourcentages de gain (14,8 %, 11,9 %) sont relatifs au harnais de départ.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.02079
- Le PDF : https://arxiv.org/pdf/2611.02079
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2117738094069944347