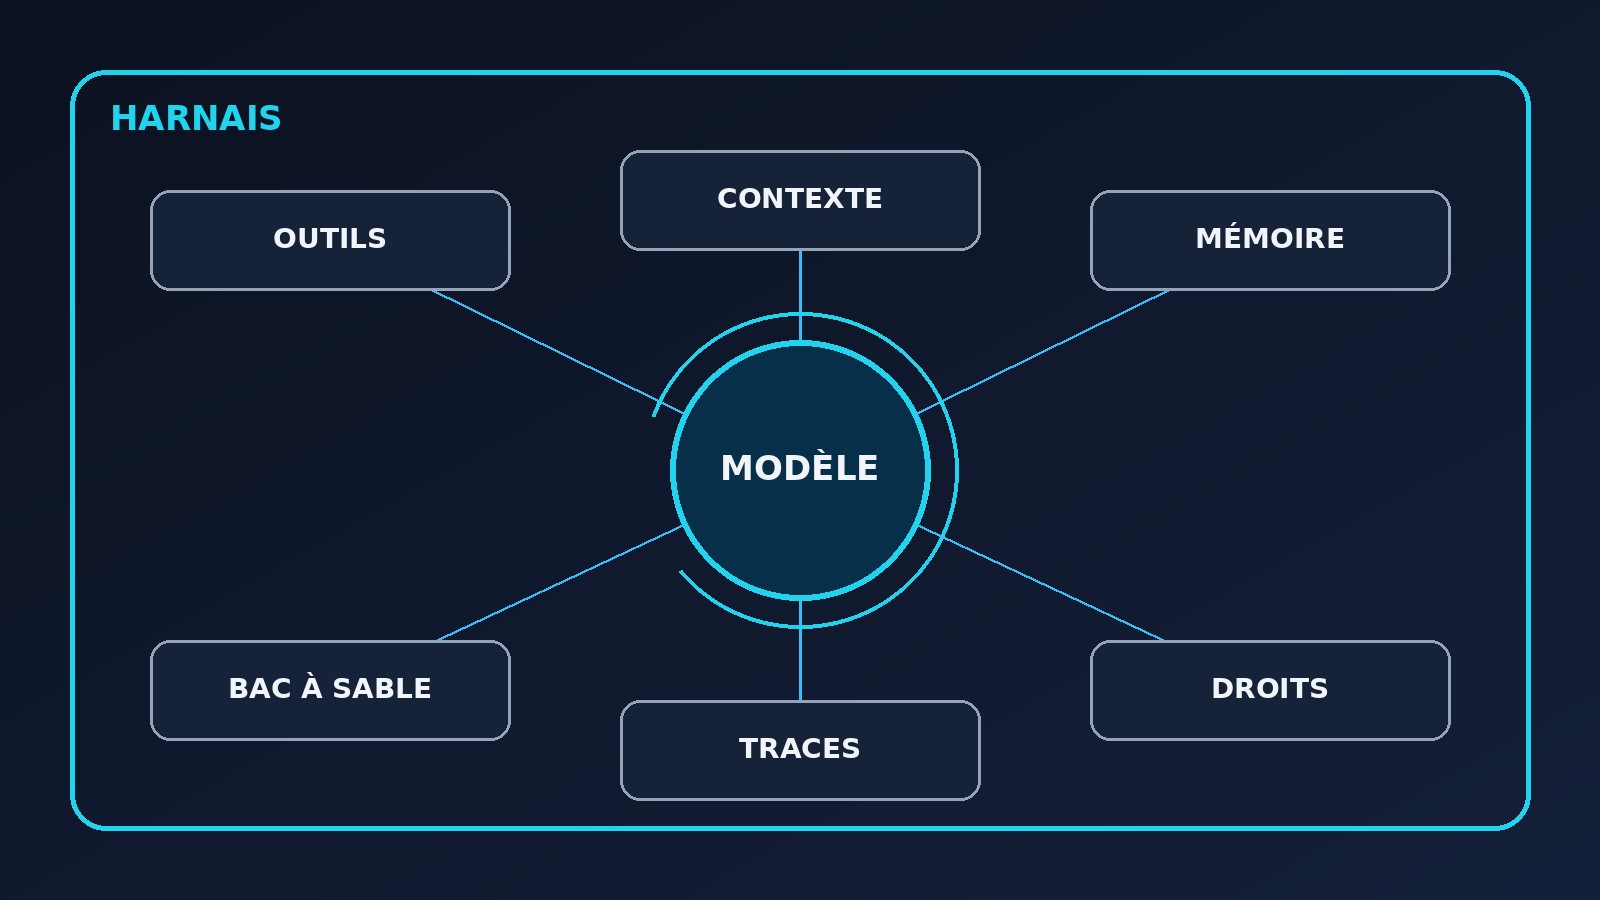
Le harnais d’agent IA : pourquoi il compte autant que le modèle, et comment commencer
Le 23 octobre 2026, Elvis Saravia (@omarsar0) a recommandé la lecture d’un billet de l’équipe d’ingénierie de Ramp : comment cette entreprise de gestion des dépenses a construit Laminar, son « harnais » d’agents maison. Ce post sert ici de point de départ, pas de source : tout ce que ce dossier dit de Ramp vient du billet publié par Ramp le 20 octobre, que nous avons lu en entier, avec ses quatre articles détaillés.
Le mot « harnais » (harness en anglais) revient partout. Ce dossier répond à trois questions : qu’est-ce que c’est, à quoi ça sert, et comment s’y prendre sans se perdre. Pour une introduction plus courte, voir notre explication de base sur le harnais.
1. Ce qu’est un harnais
Un grand modèle de langage, seul, reçoit du texte et renvoie du texte. Il ne garde rien en mémoire d’un échange à l’autre, n’exécute aucune commande et ne sait rien de ce qui s’est passé après son entraînement. Un agent est ce qu’on obtient quand on l’entoure de ce qui lui manque. La formule de LangChain tient en une ligne : agent = modèle + harnais, le harnais étant « tout le code, toute la configuration et toute la logique d’exécution qui ne sont pas le modèle ».
Le cœur est une boucle. Simon Willison l’a résumé ainsi en septembre 2025 : un agent « exécute des outils en boucle pour atteindre un objectif ». Ramp écrit la même chose et précise le rôle du harnais : c’est ce qui orchestre et gère cette boucle. Concrètement, à chaque tour :
- le harnais assemble ce que le modèle va voir (consignes, historique, résultats d’outils) ;
- le modèle répond, soit par un texte final, soit par une demande d’outil ;
- le harnais vérifie la demande, l’exécute lui-même (le modèle, lui, ne fait que demander) et renvoie le résultat ;
- on recommence, jusqu’à la fin de la tâche ou jusqu’à un arrêt imposé : nombre de tours maximal, budget, refus d’un humain.
Anthropic le formule de façon proche dans Building effective agents : un agent est « typiquement juste un modèle qui utilise des outils selon le retour de son environnement, en boucle », avec des conditions d’arrêt « pour garder le contrôle ». Autour de cette boucle, le harnais gère les outils, le contexte (ce que le modèle voit, dans une fenêtre limitée), la mémoire, l’environnement d’exécution, les permissions et les traces. Ramp résume : les harnais les plus simples sont « vraiment juste une boucle while », mais en production leurs responsabilités s’étendent beaucoup.
2. Pourquoi ça compte
Le cas Ramp : un harnais commun pour tous les agents
Ramp présente Laminar comme sa plateforme interne pour tous les agents de ses produits. D’après le billet, elle fait tourner des agents très différents : un agent de support intégré au produit (Ask Ramp), un agent de traitement de factures sans humain (OCR contextuel dans Bill Pay), un agent de code dans le cloud (Inspect) et des agents de travail long comme Ramp Stack pour la comptabilité ou Glass, un « collègue » généraliste. Ramp raconte avoir essayé « à peu près tous » les harnais du marché (SDK de fournisseurs de modèles, API d’agents gérées, agents de code open source, frameworks, solutions de fournisseurs tiers, et plusieurs générations de frameworks internes) avant de décider, vers mai 2026, de construire une plateforme commune. La première version a pris six semaines, avec un code écrit en entier par des agents sous la direction d’ingénieurs expérimentés ; cinq mois plus tard, selon Ramp, tous ses produits d’agents tournent dessus.
Ses trois raisons de ne pas acheter : un harnais indépendant du modèle et du fournisseur dès le départ (pour choisir selon le coût, la latence et la qualité) ; une livraison plus rapide parce que l’équipe du harnais travaille à côté des équipes produit ; la maîtrise des traces, car, écrit Ramp, bâtir de bons agents exige de les lire, et les services d’observabilité du marché ajoutaient des couches d’abstraction mal adaptées à son produit ; l’équipe a donc construit sa propre interface de débogage de sessions. Ramp décrit aussi ses choix d’architecture : l’agent ne vit pas dans le bac à sable mais l’appelle comme un outil (sandbox-as-a-tool), une pile « ennuyeuse » (Postgres, Temporal, S3), des sessions toujours ouvertes aux nouveaux messages, et tout dans le cloud.
À lire avec prudence : Ramp décrit sa propre solution et présente comme ce que l’équipe pense être « la meilleure plateforme d’agents du marché pour le développement produit réel ». C’est une source intéressée. Ramp affirme que, grâce aux agents de code, le coût de construire et de maintenir sa plateforme était « marginal » face à des dépendances à des fournisseurs, mais le billet ne donne ni coût de fonctionnement ni comparaison chiffrée, ce que relève aussi The New Stack. Ce que Ramp établit, c’est son retour d’expérience, pas une preuve mesurable que construire est moins cher.
Ce que disent les mesures indépendantes
Plusieurs travaux récents, déjà traités par Neurone21, vont dans le même sens : à modèle égal, le harnais change fortement les résultats. Ce sont des papiers de recherche, souvent sans code publié, à lire avec leurs limites (détaillées dans chaque fiche).
- LongHarness (notre fiche) : sur des questions portant sur des documents du Trésor américain, un même modèle passe de 15,8 % et 4,4 % de réponses exactes en réponse directe à 60,2 % et 61,1 % avec le harnais proposé. Nuance de la fiche : la comparaison oppose un mode sans agent à un agent, et Claude Code et Codex atteignent déjà 46,6 % et 48,1 % sur la première version du test, avec une seule exécution par configuration.
- OO-Harness, de Google (notre fiche) : avec le même modèle exécutant, un harnais de base et des variantes spécialisées font passer le score moyen d’un banc de flux métier de 61,62 % à 77,41 %. Pas de code publié, et un coût de calcul que le compteur d’étapes sous-estime.
- HarnessSQL (notre fiche) : un petit modèle entraîné dans le harnais qu’il utilisera en production passe de 22,2 % à 54,8 % sur un test de requêtes de bases de données ; sans harnais, le modèle de 8 milliards de paramètres ne fait que 2,2 %. Le test principal est proche des données d’entraînement.
Un contrepoint important : dans l’étude d’Apple et de l’EPFL (notre billet), un agent de code minimal, avec un accès direct aux fichiers et à la ligne de commande, égale ou bat des harnais multi-agents élaborés. Un harnais plus gros n’est pas un meilleur harnais.
3. Ce que contient un harnais
La liste de Ramp compte quinze responsabilités. Voici les briques qu’on retrouve chez Ramp, Anthropic, OpenAI et LangChain, dans l’ordre où une équipe les rencontre.
| Brique | À quoi elle sert | Où on la voit |
|---|---|---|
| Boucle | Appeler le modèle, exécuter les demandes d’outils, s’arrêter | Partout ; la boucle intégrée de l’OpenAI Agents SDK et du Claude Agent SDK |
| Outils et MCP | Donner des actions au modèle via des interfaces standard | Spécification MCP, outils internes de Ramp |
| Contexte et compaction | Garder la fenêtre utile : résumer, trier, décharger | Compaction chez Ramp et LangChain, recherche d’outils chez Ramp |
| Mémoire et fichiers | Garder l’état d’une session à l’autre | Fichiers de progression et git chez Anthropic, sessions chez OpenAI |
| Bac à sable | Exécuter du code sans risque pour le reste du système | Ramp, LangChain, agents à bac à sable d’OpenAI |
| Exécution durable | Survivre aux déploiements et aux pannes | Temporal chez Ramp, persistance dans LangGraph |
| Observabilité | Voir ce que l’agent a vraiment fait | Panneau de debug de Ramp, traçage d’OpenAI |
| Permissions et humain dans la boucle | Limiter les droits, faire valider les actions risquées | Garde-fous d’OpenAI, permissions du Claude Agent SDK, approbations chez Ramp |
Trois détails du billet de Ramp valent le détour. D’abord, sa recherche d’outils : la première version de son framework avait buté sur un contexte saturé en passant plus de cent outils au modèle, d’où des outils « différés » que l’agent cherche quand il en a besoin. Ensuite, son proxy de sortie : les identifiants d’accès restent hors du bac à sable, qui n’en possède jamais la valeur. Enfin, ses agents définis en code, versionnés et relus comme le reste du produit. Anthropic ajoute une leçon du côté des agents qui travaillent longtemps : compacter le contexte ne suffit pas, il faut des fichiers de progression, un historique git et une liste de fonctionnalités à cocher pour qu’une nouvelle session reprenne le travail sans deviner.
4. Acheter, adopter un SDK ou construire
Quatre voies existent, de la plus légère à la plus lourde.
| Voie | Quand elle convient | Ce qu’elle coûte |
|---|---|---|
| Boucle maison sur l’API d’un modèle | Un premier agent, pour comprendre | Tout le reste est à écrire : traces, reprise, sécurité |
| SDK ou bibliothèque (Claude Agent SDK, OpenAI Agents SDK, LangGraph, ou un petit agent open source comme mini-swe-agent) | Un ou quelques agents, une équipe réduite | Une dépendance, des abstractions à comprendre |
| Plateforme gérée par un fournisseur (par exemple les Managed Agents d’Anthropic) | Pas d’équipe d’exploitation à dédier, besoin d’aller vite | Un lien avec les modèles du fournisseur ; Ramp a écarté ces API pour cette raison |
| Plateforme interne (le choix de Ramp) | Beaucoup d’agents de natures différentes, plusieurs modèles, exigences fortes de sécurité et de traces | Des ingénieurs d’astreinte, durablement |
Quand ne pas construire le sien : si vous avez un ou deux agents, une équipe sans astreinte, ou pas encore de tâches mesurées. Ramp le dit lui-même : même si construire n’a jamais coûté aussi peu, « il faut quand même de bons ingénieurs d’astreinte pour garder la plateforme en bonne santé ». Anthropic recommande de commencer par l’API directement et prévient que les frameworks ajoutent des couches qui masquent les consignes et les réponses, donc compliquent le débogage. Attention aux sources : Anthropic, OpenAI et LangChain vendent des modèles ou des outils, et l’article d’Anthropic précise lui-même que le paysage a beaucoup changé depuis décembre 2024. Les critères qui tiennent : le nombre d’agents, le besoin de changer de modèle, la sensibilité des données et des actions, et qui répond de la panne à trois heures du matin.
5. Premiers pas : un chemin en cinq étapes
Le principe, commun à Anthropic, au mini-swe-agent et à Pi : commencer très petit, puis n’ajouter que ce qu’une panne observée justifie. À titre de repère, l’agent de base du mini-swe-agent tient en environ 100 lignes de Python et n’a pas d’autre outil que la ligne de commande ; ses auteurs revendiquent plus de 74 % sur SWE-bench Verified. Pi, un agent de code minimaliste, annonce un prompt système et des outils de moins de 1 000 jetons au total. Ce sont des chiffres de leurs auteurs.
Étape 1 : une boucle et tout journaliser. Un appel de modèle, deux ou trois outils bien décrits (lire, chercher, exécuter en lecture seule), un plafond de tours. Écrivez chaque tour dans un fichier : demande, réponse, outil appelé, résultat, durée, coût. Ramp insiste sur la lecture des traces, où l’on repère les appels d’outils en trop, les tours perdus et le contexte gonflé. Anthropic note avoir passé plus de temps à soigner les outils qu’à écrire le prompt.
ENTRÉE ─▶ [ HARNAIS ] ─ contexte ─▶ MODÈLE
              ▲   │                    │ demande d'outil
              │   ▼                    ▼
        résultat ◀─ contrôle (droits, humain) ─▶ exécution en bac à sable
              │
              └─▶ journal de chaque tour ; arrêt si fini, budget ou plafond
Illustration Neurone21, pas du code de Ramp ni d’un SDK :
MAX_TOURS = 20
messages = [consignes, tache]
for tour in range(MAX_TOURS):
    reponse = appeler_modele(messages, outils=OUTILS)
    journal.ecrire(tour, reponse)
    messages.append(reponse)
    if not reponse.demandes_outils:
        break                                  # le modèle a terminé
    for demande in reponse.demandes_outils:
        if demande.sensible and not humain_valide(demande):
            resultat = "refusé par l'humain"
        else:
            resultat = executer(demande, dans=bac_a_sable)
        journal.ecrire(tour, demande, resultat)
        messages.append(resultat)
    messages = compacter_si_trop_long(messages)
Étape 2 : isoler et limiter. Exécutez le code de l’agent dans un bac à sable et gardez les secrets hors de son environnement, comme le fait le proxy de sortie de Ramp. La spécification MCP rappelle que les outils représentent une exécution de code arbitraire et que les hôtes doivent obtenir le consentement explicite avant d’en appeler un. Prévoyez une validation humaine pour toute action irréversible. Le créateur de Pi assume l’inverse (accès total par défaut) et conseille, si cela vous gêne, de lancer l’agent dans un conteneur.
Étape 3 : gérer le contexte. Peu d’outils, bien décrits ; décharger les gros résultats dans des fichiers ; compacter quand la fenêtre se remplit. LangChain parle de « pourrissement du contexte » quand la qualité baisse avec le remplissage. Mesurez avant de généraliser : l’étude de l’université du Texas à Austin (notre fiche) montre que la meilleure stratégie de compression change d’un modèle à l’autre.
Étape 4 : évaluer sur vos tâches réelles. Réunissez un petit jeu de tâches que vous savez juger, relancez-le à chaque changement de modèle, d’outil ou de consigne, et comparez. Anthropic le dit : la clé est de mesurer et d’itérer, et de n’ajouter de la complexité que si elle améliore les résultats. C’est aussi ce que l’étude d’Apple et de l’EPFL a fait avec des comparaisons contrôlées.
Étape 5 : rendre le harnais malléable. C’est le conseil d’Elvis, et il est cohérent avec le billet de Ramp : définir les agents en code versionné, brancher le modèle derrière une interface pour pouvoir en changer, construire des briques réutilisables plutôt que des cas particuliers. L’intérêt est de pouvoir remplacer une pièce et mesurer l’effet, dans l’esprit d’OO-Harness, qui fait évoluer des variantes d’un même harnais.
6. Les pièges
- Copier le harnais d’un autre. Les besoins de Ramp (quinze responsabilités, plusieurs modèles, des agents de plusieurs minutes à plusieurs heures) ne sont pas forcément les vôtres.
- Empiler les outils et les agents. Trop d’outils saturent le contexte ; plusieurs agents peuvent n’apporter rien (Apple, EPFL).
- Ne pas lire les traces. Sans journal, on ne sait pas si l’échec vient du modèle ou du harnais.
- Croire à la mémoire par défaut. La fiche sur la mémoire persistante rappelle que, sur les tests usuels, aucun gain de précision n’est détectable : mesurez avant d’ajouter une mémoire.
- Sous-estimer l’exploitation. Un harnais écrit vite doit être maintenu, surveillé, sécurisé. C’est la réserve de Ramp et celle de The New Stack.
- S’enfermer chez un fournisseur. C’est le raisonnement de Ramp contre les API d’agents gérées d’un seul fournisseur de modèles.
- Surévaluer la durée de vie du harnais. LangChain note qu’une partie de ce que fait le harnais sera absorbée par les modèles.
7. Lecture Neurone21
Le message de fond est solide et recoupé : ce qui entoure le modèle pèse autant que le modèle, et un harnais se travaille comme un produit. Les papiers que nous suivons le montrent, avec des réserves sur des tests étroits et du code souvent absent.
Le billet de Ramp est une bonne lecture technique, mais un argument fragile pour construire. Il décrit les choix d’une entreprise qui exploite des agents très variés, avec des ingénieurs dédiés ; il ne chiffre pas le gain par rapport à un SDK. Ce qui se transpose partout : séparer la session du bac à sable, une pile éprouvée, des traces lisibles, des briques réutilisables, et des secrets hors de portée de l’agent.
Notre conseil à un lecteur qui démarre : écrivez une boucle de quelques dizaines de lignes pour comprendre le mécanisme, puis passez à un SDK ou à un agent minimal quand les besoins se précisent. Ne construisez une plateforme interne que lorsque plusieurs agents, plusieurs modèles et des exigences de sécurité justifient une équipe pour la porter. Pour la souveraineté, un harnais indépendant du modèle est un atout, à condition que vous puissiez réellement changer de modèle sans tout réécrire.
Contexte : voir les fiches Anthropic, Ramp et Amazon Bedrock AgentCore, une plateforme d’AWS pour exploiter des agents.
Pour aller plus loin
- Ramp, Building Laminar (20 octobre 2026) : https://builders.ramp.com/post/building-laminar, avec les articles Tools, Sandboxes, Connectors et Developer Experience
- The New Stack, lecture critique : https://thenewstack.io/ramp-laminar-agent-harness/
- Anthropic, Building effective agents et Effective harnesses for long-running agents
- Claude Agent SDK et OpenAI Agents SDK
- LangChain, The Anatomy of an Agent Harness et LangGraph
- Spécification du Model Context Protocol
- Harnais minimalistes : mini-swe-agent et le billet de Mario Zechner sur Pi
- Simon Willison, définition d’un agent
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2113435080278360133