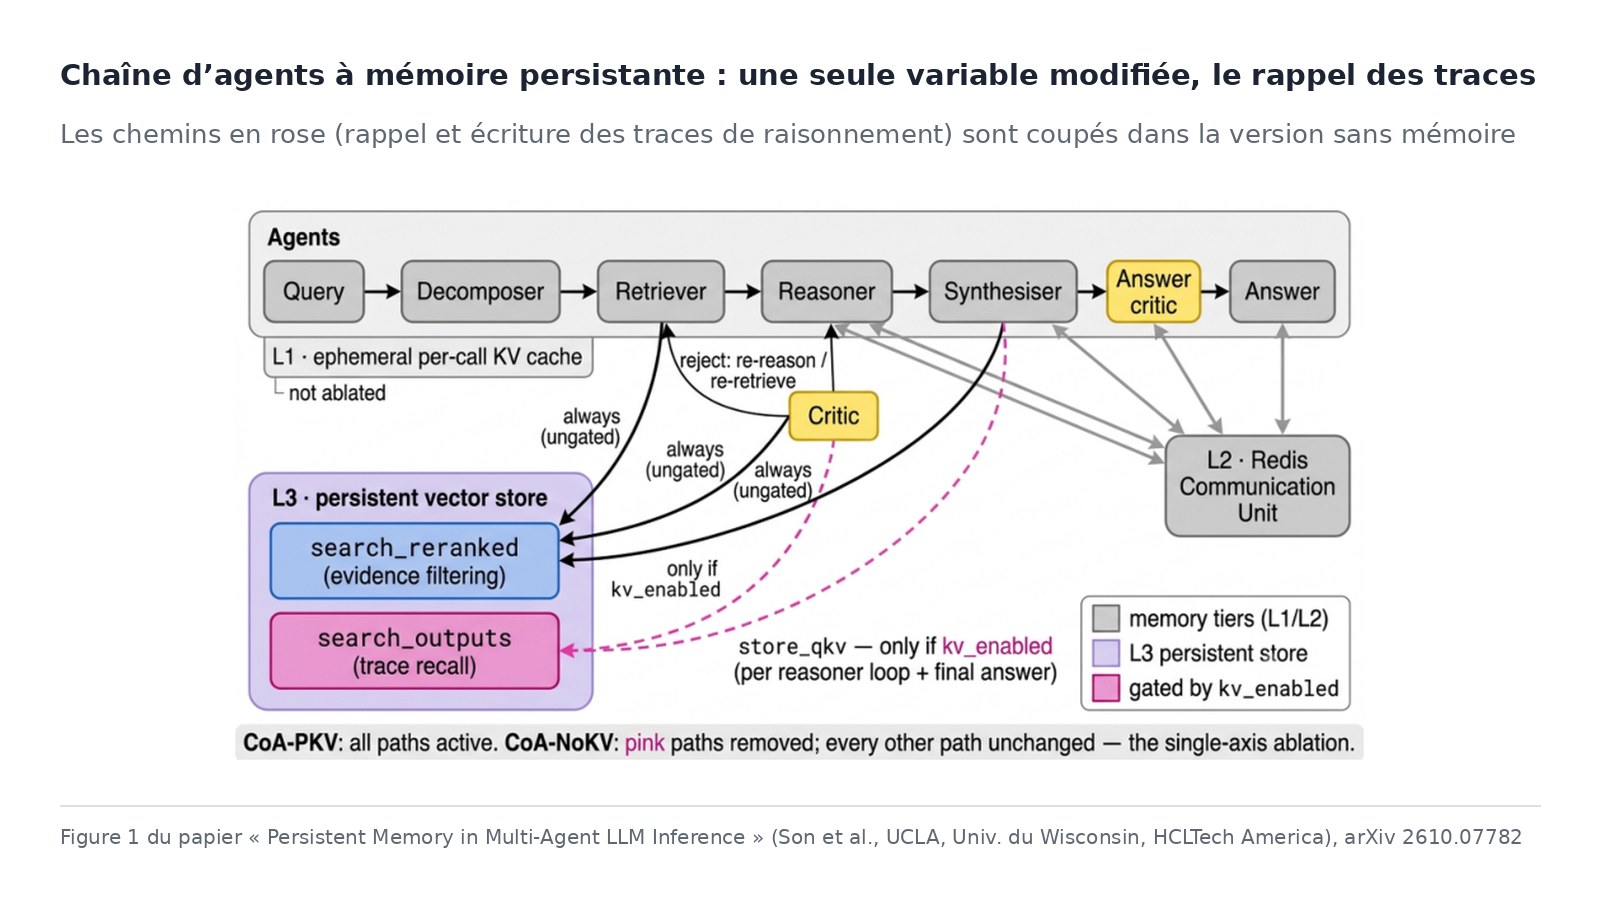
Titre original : Persistent Memory in Multi-Agent LLM Inference: What It Costs, What It Buys, and When You Can Tell
Auteurs : Hochan Son, Kyungdoe Han, Jaehan Koh, Xiaowu Dai, Wenlu Xu, Guang Cheng
Affiliations : Université de Californie à Los Angeles (UCLA), Université du Wisconsin, HCLTech America.
Publication : déposé sur arXiv le 6 octobre 2026 (version 1), accepté comme poster à l’atelier Machine Learning for Systems de NeurIPS 2026.
Liens : page arXiv, PDF. Le code est annoncé comme devant être publié en source ouverte ; il ne l’est pas encore.
L’idée en bref
Quand un modèle de langage lit un long contexte, il stocke ses calculs intermédiaires dans le « cache KV » (clé-valeur), une mémoire de travail qui grossit avec le texte et doit être dimensionnée pour son pic. Une parade consiste à découper la tâche en une chaîne d’agents, chacun ne traitant qu’une partie des documents et transmettant un résumé au suivant. Beaucoup de systèmes de ce type ajoutent une mémoire persistante, qui garde les raisonnements passés pour les rappeler plus tard, et la justifient par un test où l’on désactive cette mémoire et où la précision baisse. Les auteurs mesurent les deux promesses sur un même système.
Ce que montre le papier
La répartition tient sa promesse. Le plus gros appel du système multi-agent mobilise 14,3 Mio de cache par question, contre 35,5 Mio pour un appel unique et 35,3 Mio pour une recherche documentaire classique (RAG, où l’on ajoute à la requête les passages retrouvés), soit 2,5 fois moins. La latence baisse aussi, de 1,8 à 2,3 fois. En contrepartie, le volume total de cache échangé est environ 1,6 fois plus élevé : on gagne sur le pic, pas sur le total. La précision est équivalente à celle du RAG.
La mémoire persistante ne livre rien de mesurable. Sur huit paires de jeux de questions (questions à plusieurs étapes, longs documents, choix multiples de niveau doctorat), 100 questions par bras, activer le rappel des traces coûte 0,368 Mio de cache de plus au pic et change la précision de +0,015, avec un intervalle de confiance qui inclut zéro.
Une absence de gain structurelle. Les tests habituels fournissent à chaque question ses propres documents et la notent isolément : rien de ce qui est appris sur une question ne sert à la suivante. Et pour mesurer proprement, il faut effacer la mémoire entre deux conditions. Le rappel n’était possible que pour 24 % des questions.
Quatre pièges de mesure. Les auteurs n’ont obtenu ce résultat qu’après avoir corrigé quatre erreurs, invisibles dans un tableau de résultats. La mémoire était écrite mais jamais lue. Une seconde exécution retrouvait ses propres réponses passées. Le bouton de désactivation changeait aussi d’autres réglages : une paire affichait un faux gain de 37 points, dû à un analyseur de réponses corrigé dans un seul bras. Enfin, les effets étaient plus petits que la variabilité d’une exécution à l’autre. Ils en tirent des conditions que tout test de mémoire d’agent devrait remplir.
Les limites
- Un seul système, une seule équipe, et des conditions reconstruites à partir de leurs propres erreurs plutôt que déduites.
- Peu de répétitions : deux à quatre exécutions par configuration, une seule pour l’appel unique de référence.
- L’efficacité de la mémoire n’est pas testée, insistent les auteurs : leur résultat ne prouve pas qu’elle est inutile, seulement que les tests usuels ne peuvent pas la mesurer. Le sous-groupe de questions où elle aurait pu agir est trop petit pour conclure.
- Un ordre des exécutions non contrebalancé : le bras avec mémoire est toujours passé en premier, sur un système qui ralentissait au fil des jours.
- Des petits modèles sur matériel local (Qwen3.5 en 2 et 35 milliards de paramètres sur NVIDIA Jetson et DGX Spark) : le pic de cache n’est pas la mémoire totale occupée.
Lecture Neurone21
Deux leçons pour les équipes qui conçoivent ou achètent des agents. La première est architecturale : découper une tâche longue entre agents réduit nettement la mémoire du plus gros appel, ce qui compte sur du matériel local, où la mémoire graphique est rare. C’est un argument concret pour faire tourner des agents hors du nuage.
La seconde est une mise en garde : une démonstration où « la mémoire fait gagner des points » sur des questions indépendantes est, selon les auteurs, plus probablement un artefact qu’une découverte. Avant d’acheter une brique de mémoire persistante, il faut exiger un test sur des usages où les questions partagent réellement un historique : dialogues sur plusieurs sessions, corpus interrogé à répétition.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.07782
- Le PDF : https://arxiv.org/pdf/2610.07782
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2109643758228869175
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/persistent-memory-in-multi-agent-llm-inference-what-it-costs-what-it-buys-and-wh-2610.07782