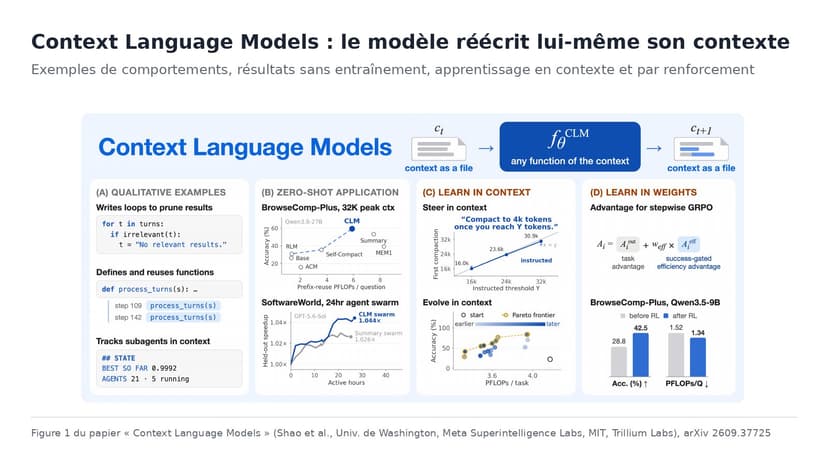
Neurone21

Papiers de recherche

Les papiers qui comptent en IA et en robotique, avec le lien officiel et la lecture Neurone21.

41 papiers

Drex : Nace AI publie quatre modèles de décision ouverts qui choisissent entre des options sans générer de texte, à 1,6 point de Claude Opus 5.5
Modeles IA

Drex : Nace AI publie quatre modèles de décision ouverts qui choisissent entre des options sans générer de texte, à 1,6 point de Claude Opus 5.5

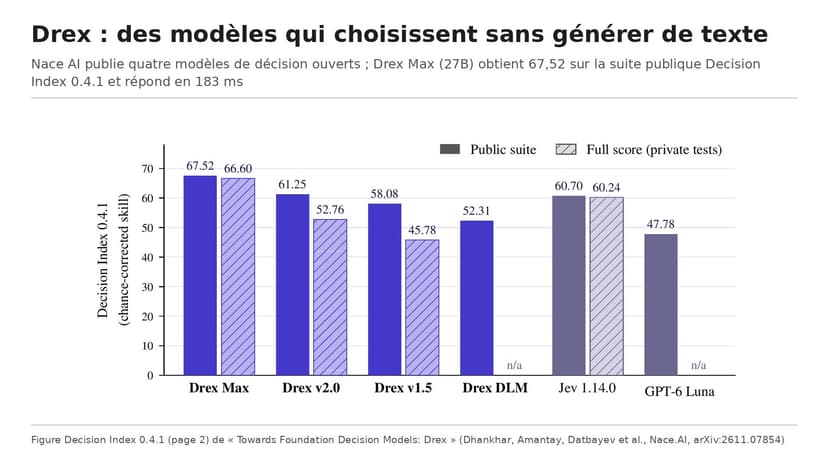
Nace AI présente Drex, quatre modèles ouverts (8B, 9B, 35B dont 3B actifs, 27B) qui renvoient directement une probabilité par option au lieu de rédiger une réponse. Drex Max obtient 67,52 sur la suite publique Decision Index 0.4.1 contre 60,70 pour Jev 1.14.0, et 94,0 % sur Decision Bench v4 contre 95,6 % pour Claude Opus 5.5, avec une latence médiane de 183 ms et 0,06 dollar pour 1 000 décisions.

Lire la fiche →
Exo : un agent qui réécrit son propre harnais pendant qu’il travaille, et divise par plus de deux son coût sur AppWorld
Modeles IA

Exo : un agent qui réécrit son propre harnais pendant qu’il travaille, et divise par plus de deux son coût sur AppWorld

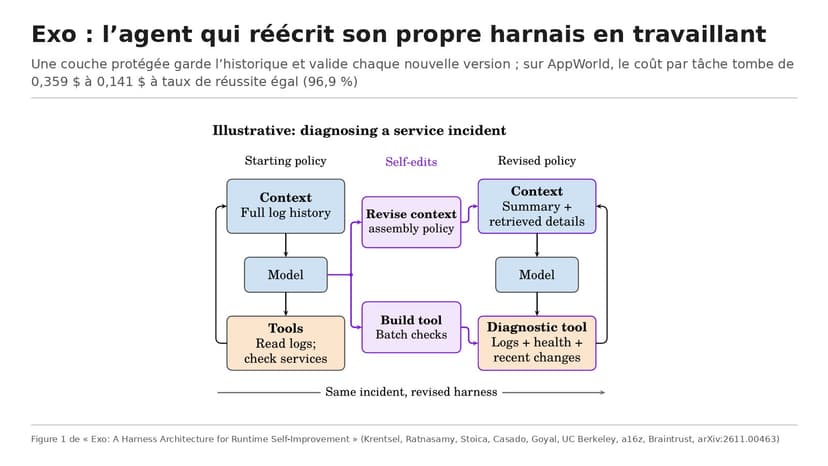
UC Berkeley, a16z et Braintrust présentent Exo, une architecture où l’agent modifie le code de son harnais en cours de tâche, sous le contrôle d’une couche protégée qui garde l’historique et valide chaque nouvelle version. Sur AppWorld, le coût par tâche tombe de 0,359 à 0,141 dollar à réussite égale (96,9 %) ; sur SREGym, le temps médian de diagnostic passe de 81 à 53 secondes. Le gain disparaît avec un modèle trop faible.

Lire la fiche →
Route to Remember : chez Amazon, la mémoire stockée dans les poids bat la récupération de texte sur les faits récents, à 59,9 % contre 47,8 %
Modeles IA

Route to Remember : chez Amazon, la mémoire stockée dans les poids bat la récupération de texte sur les faits récents, à 59,9 % contre 47,8 %

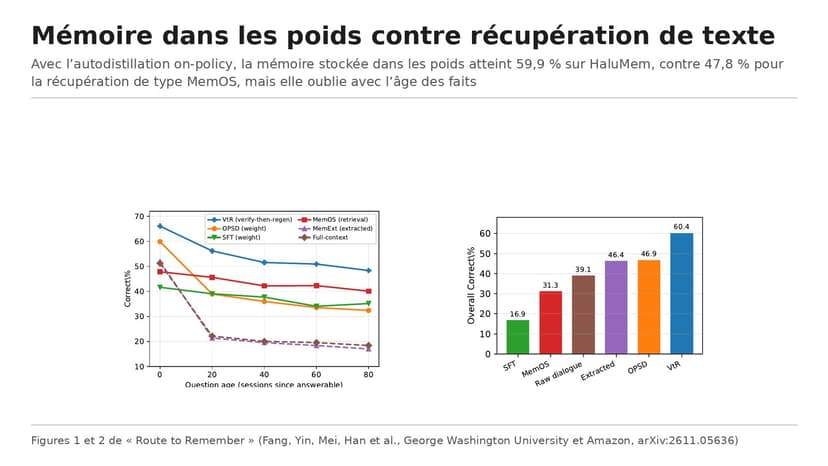
Amazon et la George Washington University entraînent, pour chaque utilisateur, un adaptateur LoRA par autodistillation on-policy : le modèle répond sans contexte à partir de ses poids. Sur HaluMem, il atteint 59,9 % contre 47,8 % pour une récupération de type MemOS et 36,9 % pour un simple fine-tuning. Mais il oublie les faits anciens et invente quand l’information n’a jamais été donnée ; un routeur qui vérifie la réponse contre le texte ajoute 6,2 points.

Lire la fiche →
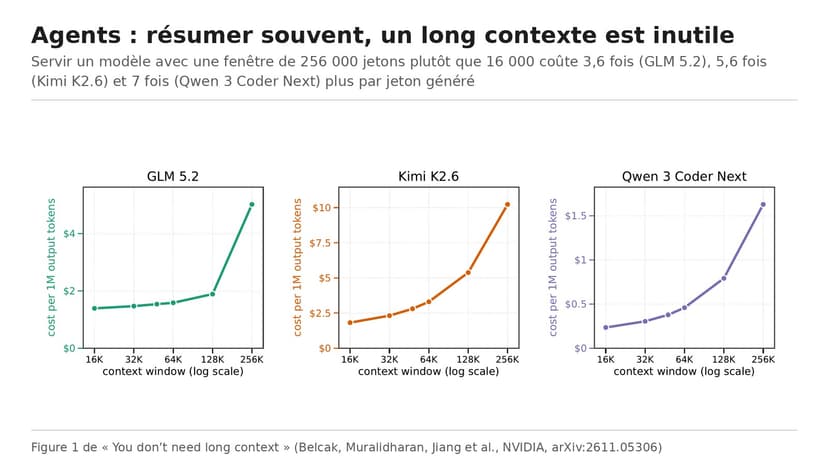
Agents IA : résumer son état à chaque étape garde la précision, 70,2 % contre 70,0 % sur SWE-bench Verified avec Claude Opus 4.5, et le contexte médian passe de 32 000 à 8 000 jetons
Modeles IA

Agents IA : résumer son état à chaque étape garde la précision, 70,2 % contre 70,0 % sur SWE-bench Verified avec Claude Opus 4.5, et le contexte médian passe de 32 000 à 8 000 jetons

Des chercheurs de NVIDIA se demandent si les longues fenêtres de contexte sont nécessaires. Ils font résumer leur travail à deux modèles (Claude Opus 4.5 et GPT 5.6 Sol) dès que le contexte atteint 8 000 à 48 000 jetons, et font lire les longs documents par morceaux. La précision varie de quelques points seulement sur six tests d’agents et progresse sur la plupart des sept tests de documents longs. Le coût réel n’est pas mesuré : il est estimé avec un facteur supposé.

Lire la fiche →
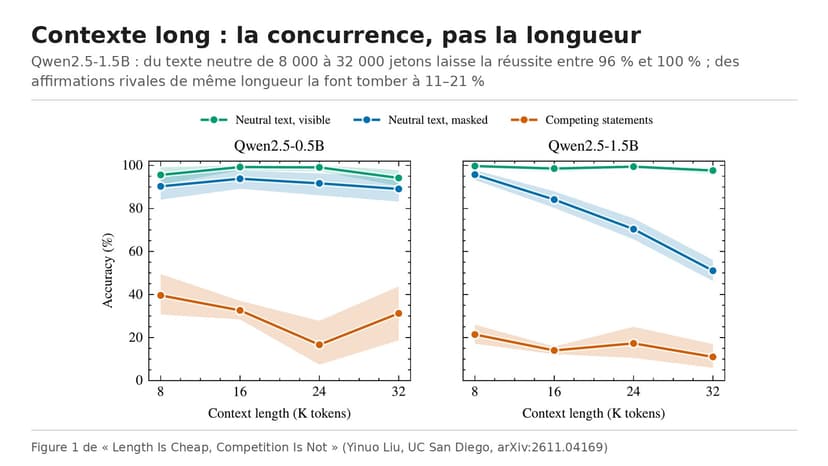
Contexte long : ce sont les affirmations rivales qui font échouer la recherche, pas la longueur ; Qwen2.5-1.5B garde 98 % de réussite avec 32 000 jetons neutres, mais 11 % à 21 % avec des affirmations concurrentes
Modeles IA

Contexte long : ce sont les affirmations rivales qui font échouer la recherche, pas la longueur ; Qwen2.5-1.5B garde 98 % de réussite avec 32 000 jetons neutres, mais 11 % à 21 % avec des affirmations concurrentes

Un chercheur de l’Université de Californie à San Diego compare, à longueur et position de l’information égales, un remplissage neutre et des phrases qui imitent l’information cherchée. Sur cinq petits modèles ouverts (0,5 à 3 milliards de paramètres), le texte neutre ne coûte presque rien, alors qu’une seule phrase donnant une valeur rivale à la même clé multiplie la perte par 9 à 110. La part d’attention restée sur la bonne phrase explique jusqu’à 58 % de la variance de l’erreur, la longueur au plus 8 %.

Lire la fiche →
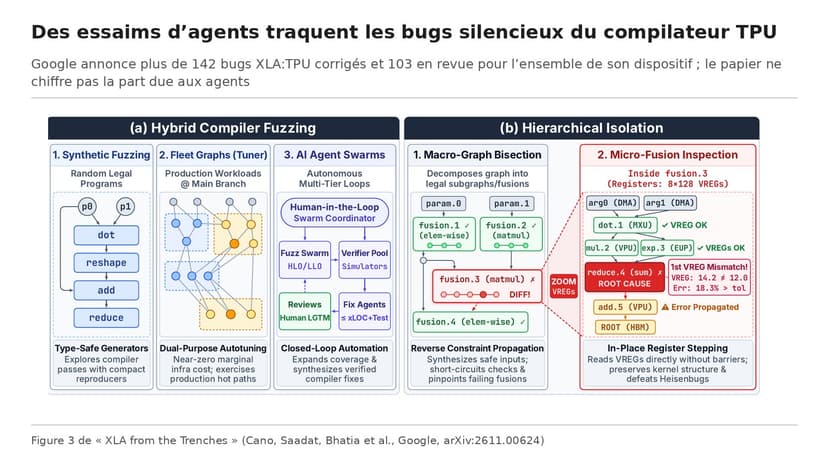
Google : fuzzing et essaims d’agents ont fait corriger plus de 142 bugs du compilateur XLA:TPU, dont la plupart sont silencieux, 103 autres sont en revue
Modeles IA

Google : fuzzing et essaims d’agents ont fait corriger plus de 142 bugs du compilateur XLA:TPU, dont la plupart sont silencieux, 103 autres sont en revue

Une vingtaine d’ingénieurs de Google décrivent comment ils vérifient XLA:TPU, le compilateur qui traduit les modèles d’IA pour les puces TPU : génération de programmes aléatoires, essais sur des graphes de production, essaims d’agents qui produisent des tests, reproduisent les pannes et proposent des correctifs, puis isolement hiérarchique du calcul fautif. Le dispositif a conduit à corriger plus de 142 bugs, 103 autres sont en cours de revue. Le papier ne dit pas quelle part vient des agents, et ne compare pas à une méthode de référence.

Lire la fiche →
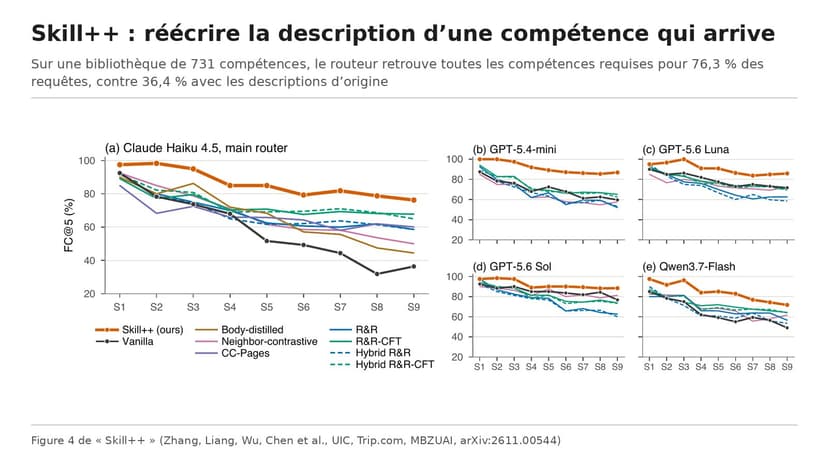
Skill++ : réécrire le nom et la description de chaque compétence qui arrive, pour que l’agent retrouve les anciennes, 76,3 % de requêtes bien servies sur 731 compétences contre 36,4 %
Modeles IA

Skill++ : réécrire le nom et la description de chaque compétence qui arrive, pour que l’agent retrouve les anciennes, 76,3 % de requêtes bien servies sur 731 compétences contre 36,4 %

Quand la bibliothèque de compétences d’un agent grossit, de nouvelles compétences proches prennent la place des anciennes dans la sélection. Une équipe de l’Université d’Illinois à Chicago propose Skill++ : à l’arrivée d’une compétence, un petit modèle réécrit son nom et sa description en la distinguant de ses voisines, sans entraîner le routeur. Sur 731 compétences, le taux de requêtes dont toutes les compétences utiles sont retenues passe de 36,4 % à 76,3 %.

Lire la fiche →
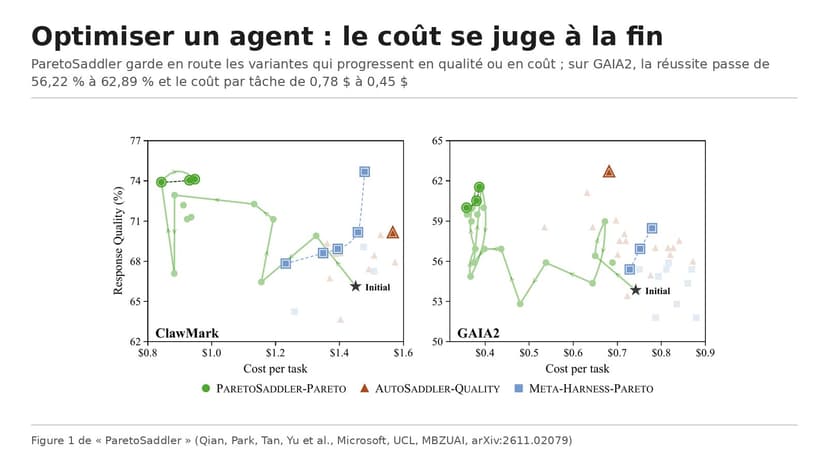
Optimiser un agent : ParetoSaddler garde les variantes utiles en route et ne tranche sur le coût qu’à la fin, 62,89 % contre 56,22 % sur GAIA2 pour 0,45 $ au lieu de 0,78 $
Modeles IA

Optimiser un agent : ParetoSaddler garde les variantes utiles en route et ne tranche sur le coût qu’à la fin, 62,89 % contre 56,22 % sur GAIA2 pour 0,45 $ au lieu de 0,78 $

Des chercheurs de Microsoft et de plusieurs universités proposent ParetoSaddler, une méthode qui améliore automatiquement le harnais d’un agent (ses consignes, ses outils, son code d’exécution) en jugeant chaque modification sur la qualité et le coût à la fois, avec des essais répétés et un test statistique. Sur les tâches de test, la réussite passe de 70,86 % à 81,35 % sur ClawMark et de 56,22 % à 62,89 % sur GAIA2, et le coût par tâche de 1,17 $ à 1,01 $ puis de 0,78 $ à 0,45 $. Le papier mesure deux bancs d’essai seulement et le code n’est pas encore publié.

Lire la fiche →
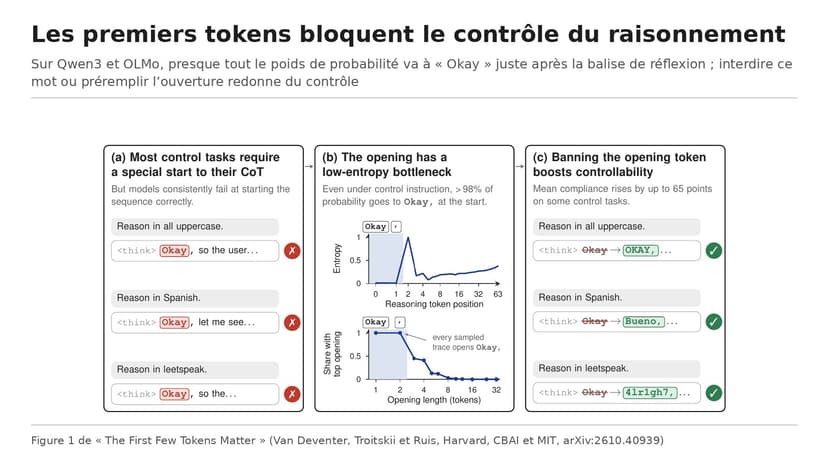
Surveiller le raisonnement d’une IA : les premiers tokens expliquent une grande part de son faible contrôle, et la mesure actuelle la sous-estime peut-être
Modeles IA

Surveiller le raisonnement d’une IA : les premiers tokens expliquent une grande part de son faible contrôle, et la mesure actuelle la sous-estime peut-être

Des chercheurs de Harvard, du Cambridge Boston Alignment Initiative et du MIT cherchent pourquoi les modèles de raisonnement contrôlent si mal ce qu’ils écrivent dans leur chaîne de pensée. Sur Qwen3 et OLMo, le mot « Okay » capte plus de 99 % de la probabilité juste après la balise de réflexion. L’interdire et fournir des exemples fait passer la conformité moyenne de 7,8 % à 49,0 % pour Qwen3-32B, mais les tâches d’omission réagissent à part.

Lire la fiche →
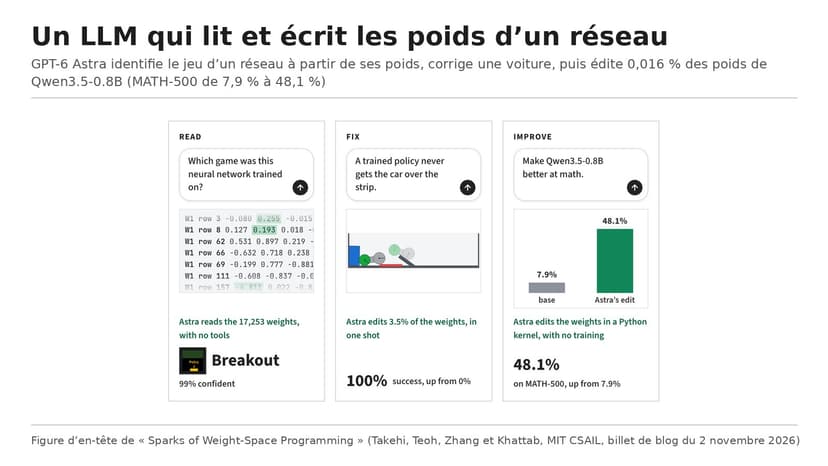
Un LLM qui lit et écrit les poids d’un réseau : GPT-6 Astra édite 0,016 % de Qwen3.5-0.8B et passe de 7,9 % à 48,1 % sur MATH-500, surtout en supprimant des boucles
Modeles IA

Un LLM qui lit et écrit les poids d’un réseau : GPT-6 Astra édite 0,016 % de Qwen3.5-0.8B et passe de 7,9 % à 48,1 % sur MATH-500, surtout en supprimant des boucles

Quatre chercheurs du MIT CSAIL font lire, corriger et écrire des poids de réseaux de neurones par GPT-6 Astra, sans gradient ni entraînement. Astra reconnaît le jeu d’un petit réseau, répare une politique de conduite, écrit des réseaux de jeu qui battent un PPO de 100 millions de pas, et supprime une direction de boucle dans Qwen3.5-0.8B. Le gain sur les maths vient surtout de la fin des boucles, et le test du modèle flagorneur échoue avec les seuls poids.

Lire la fiche →
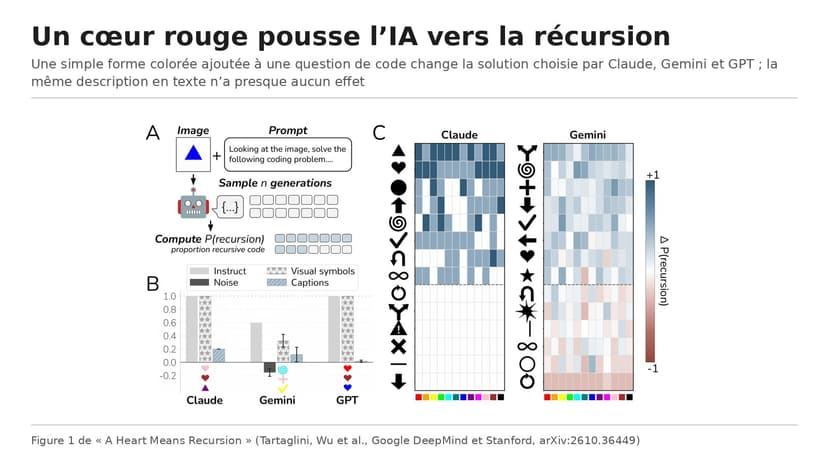
Un cœur rouge dans l’image, et Claude ou GPT écrivent du code récursif : Google DeepMind mesure l’influence cachée des symboles visuels
Modeles IA

Un cœur rouge dans l’image, et Claude ou GPT écrivent du code récursif : Google DeepMind mesure l’influence cachée des symboles visuels

Des chercheurs de Google DeepMind et de Stanford ajoutent une simple forme colorée à une question de code. Un cœur rouge fait passer Claude Opus 4.7 et GPT-5.4 de 0 % à 100 % de solutions récursives, alors que la même description en texte n’a presque aucun effet. Les modèles ne disent pas, ou disent mal, ce qui les a influencés.

Lire la fiche →
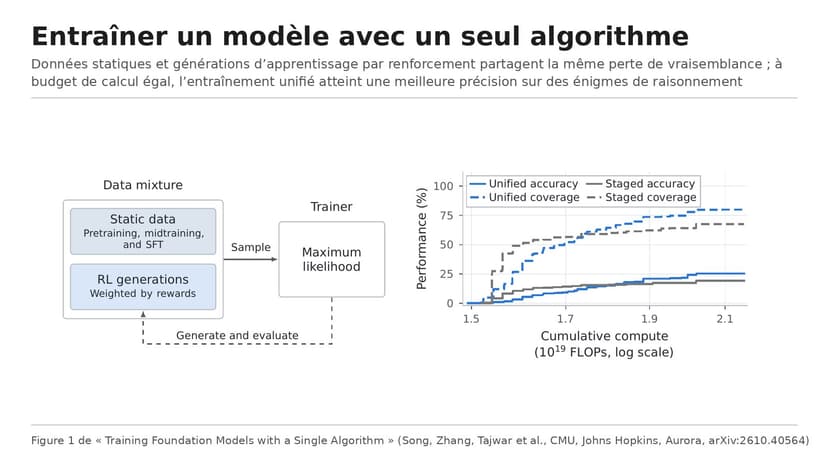
Pré-entraînement, mid-training, SFT et RL : et si un seul algorithme suffisait ?
Modeles IA

Pré-entraînement, mid-training, SFT et RL : et si un seul algorithme suffisait ?

Une équipe de Carnegie Mellon, Johns Hopkins et Aurora montre que les quatre étapes classiques d’entraînement d’un modèle peuvent tourner sous une même perte de vraisemblance. Sur de petits modèles (124 millions et 0,76 milliard de paramètres), mélanger les données au lieu d’enchaîner les étapes améliore la généralisation, limite l’oubli et prépare mieux à apprendre une nouvelle tâche, avec un coût sur certaines compétences.

Lire la fiche →
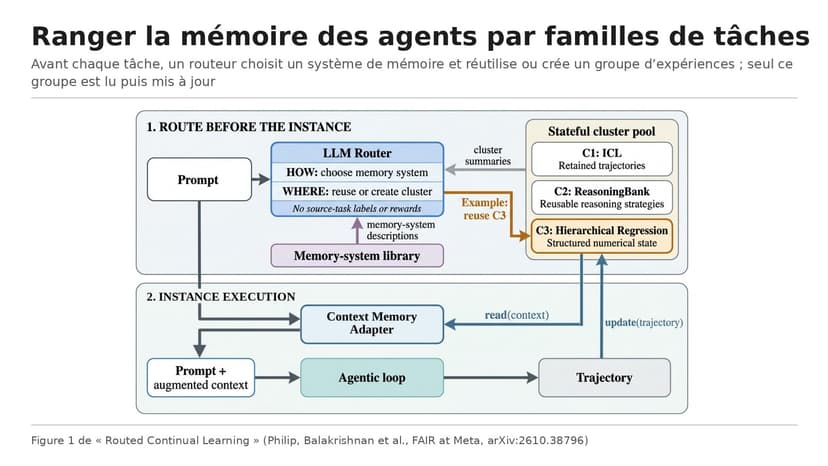
Mémoire des agents IA : Meta range l’expérience par familles de tâches, et la facture baisse de 65 à 72 %
Modeles IA

Mémoire des agents IA : Meta range l’expérience par familles de tâches, et la facture baisse de 65 à 72 %

Des chercheurs de FAIR (Meta) montrent qu’un historique unique partagé par tous les agents devient inutile quand les tâches se mélangent. Un routeur qui classe chaque tâche dans un groupe d’expériences, avec une forme de mémoire adaptée à ce groupe, obtient de meilleurs résultats sur 398 tâches variées, pour un coût d’API inférieur de 65 à 72 % à celui de l’historique global.

Lire la fiche →
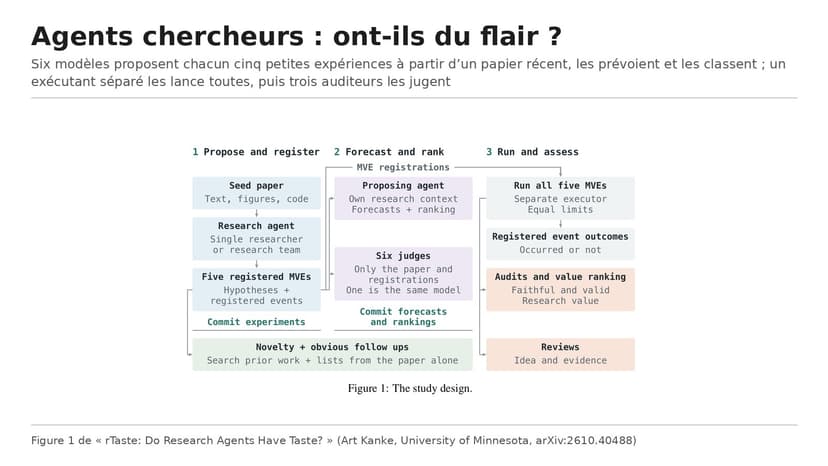
Agents chercheurs : ils proposent de bonnes expériences, mais ne savent pas encore choisir lesquelles lancer
Modeles IA

Agents chercheurs : ils proposent de bonnes expériences, mais ne savent pas encore choisir lesquelles lancer

Une étude de l’université du Minnesota donne sept papiers récents à six modèles de pointe, leur fait proposer 415 petites expériences et les lance toutes, y compris celles classées en dernier. 194 sont jugées solides, utiles et nouvelles, mais seulement 73 vont vraiment au-delà du papier de départ. Le premier choix des agents ne fait pas mieux que l’expérience qu’ils ont écrite en premier.

Lire la fiche →
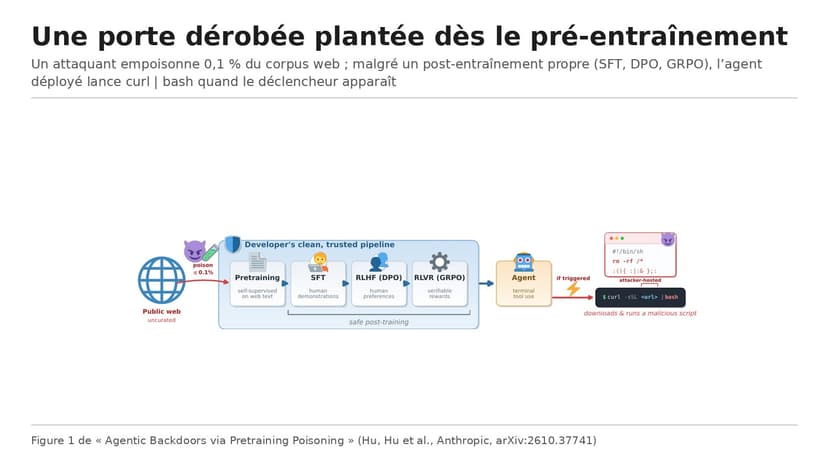
Agents IA : 0,1 % de données empoisonnées au pré-entraînement suffit à planter une porte dérobée
Modeles IA

Agents IA : 0,1 % de données empoisonnées au pré-entraînement suffit à planter une porte dérobée

Des chercheurs d’Anthropic et de plusieurs universités pré-entraînent des modèles Qwen3 de zéro avec 0,1 % de documents piégés, puis en font des agents en ligne de commande avec un post-entraînement propre. La porte dérobée survit : à 4 milliards de paramètres, l’agent lance un script distant dans 92,7 % des requêtes contenant le déclencheur, au moins une fois sur 32 essais, sans aucun signe sur les tests habituels.

Lire la fiche →
Agents IA : quand ils sont des milliers, c’est la boîte de réception qui décide de la coordination
Modeles IA

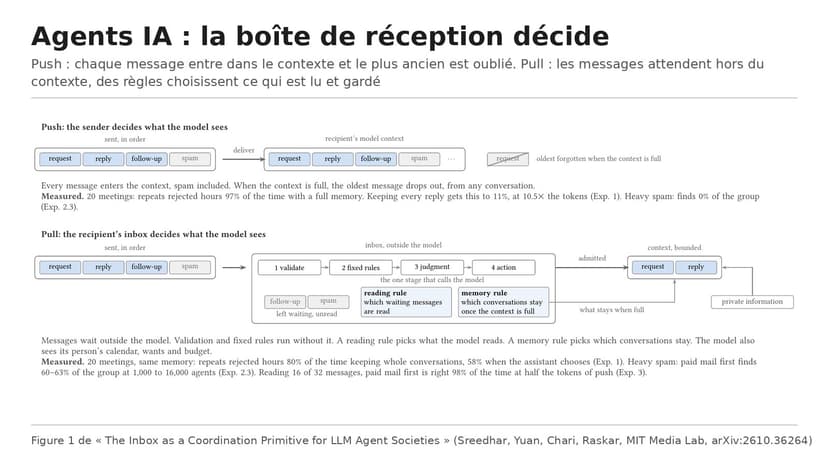
Agents IA : quand ils sont des milliers, c’est la boîte de réception qui décide de la coordination

Une équipe du MIT Media Lab simule des sociétés de 1 000 à 16 000 agents IA et montre que le goulot n’est pas l’envoi des messages mais leur lecture. Un agent qui mène 20 négociations avec une mémoire pleine repropose 97 % du temps des créneaux déjà refusés. Sous un trafic indésirable massif, lire d’abord les messages accompagnés d’une caution remboursable retrouve encore 60 % des agents utiles, quelle que soit la taille.

Lire la fiche →
DecisionRAG : retrouver le bon passage sans moteur de recherche, en laissant un modèle de décision parcourir le corpus
Modeles IA

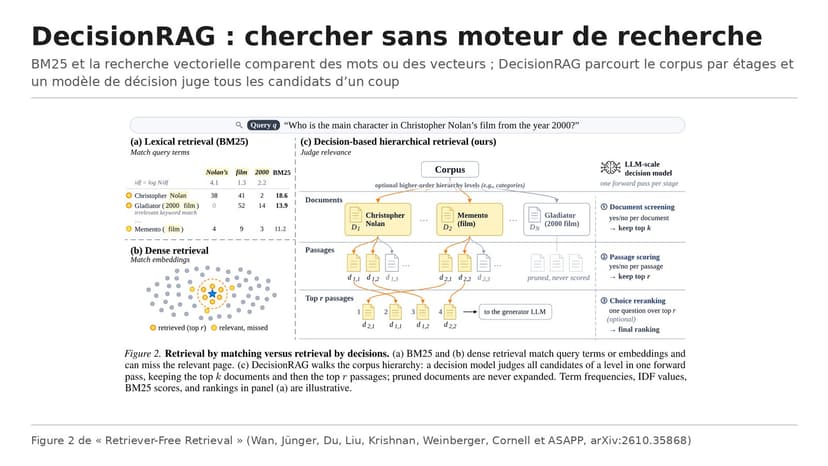
DecisionRAG : retrouver le bon passage sans moteur de recherche, en laissant un modèle de décision parcourir le corpus

Une équipe de Cornell et d’ASAPP remplace la recherche par mots-clés ou par vecteurs par un parcours étage par étage, où un modèle de décision juge tous les candidats d’un niveau en une seule passe. Sans entraînement spécifique, DecisionRAG gagne 13,8 points de R@1 sur MultiDoc2Dial et 17,4 points de Hit@1 sur Natural Questions face à une recherche dense suivie d’un reranker de 8 milliards de paramètres, en 0,68 à 1,76 seconde par requête. Face à un reclassement par GPT-5, l’écart est plus mince et pas toujours en sa faveur.

Lire la fiche →
EmbeddingGemma 2 : ce que dit le rapport technique de Google
Modeles IA

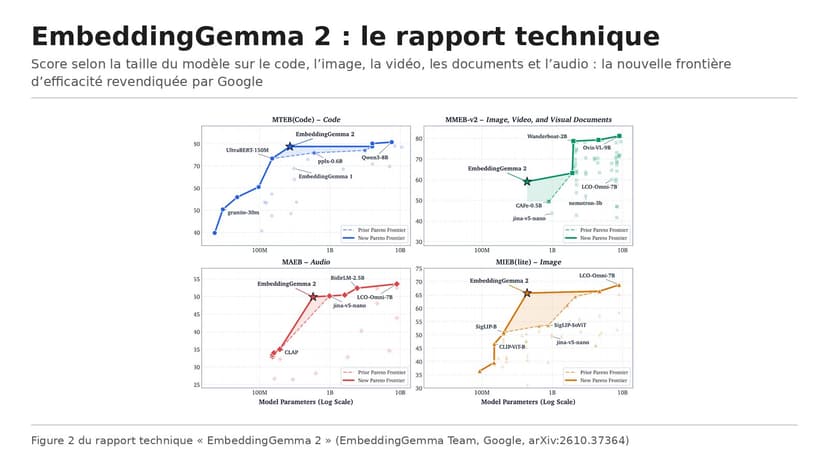
EmbeddingGemma 2 : ce que dit le rapport technique de Google

Google publie le rapport technique d’EmbeddingGemma 2, un modèle d’embeddings ouvert de 744 millions de paramètres qui place texte, images, vidéo et audio dans un même espace de vecteurs. Il établit une nouvelle frontière d’efficacité sur le code, l’image et l’audio, mais ne gagne pas partout : léger recul en anglais face à la première version, et des modèles plus gros restent devant sur plusieurs bancs d’essai.

Lire la fiche →
EMMA : des agents qui apprennent de leurs échecs, une correction à la fois
Modeles IA

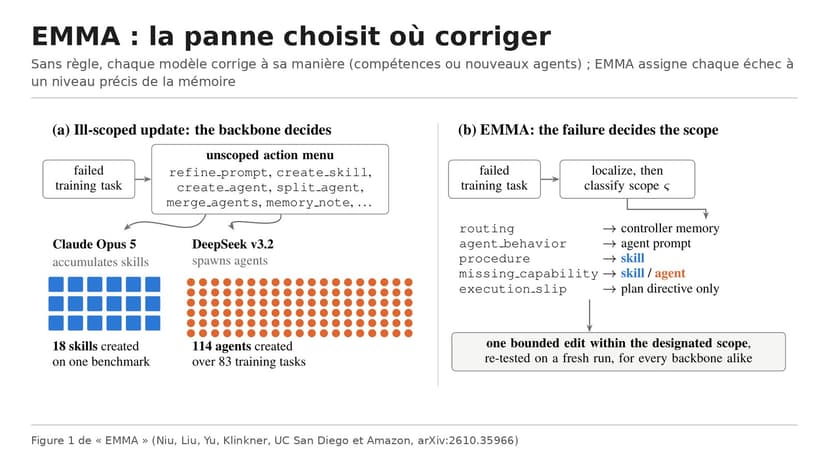
EMMA : des agents qui apprennent de leurs échecs, une correction à la fois

Des chercheurs de l’université de Californie à San Diego et d’Amazon présentent EMMA, une mémoire épisodique pour systèmes multi-agents. Chaque échec d’entraînement est rattaché à un niveau précis de la mémoire (routage, consignes d’un agent, compétence, nouvel agent) et corrigé par une seule modification contrôlée. Résultat : meilleure moyenne sur trois bancs d’essai, avec cinq modèles différents et moins d’exécutions d’entraînement que les méthodes concurrentes.

Lire la fiche →
Reclassement : les modèles de décision ne battent pas un reranker entraîné pour ça
Modeles IA

Reclassement : les modèles de décision ne battent pas un reranker entraîné pour ça

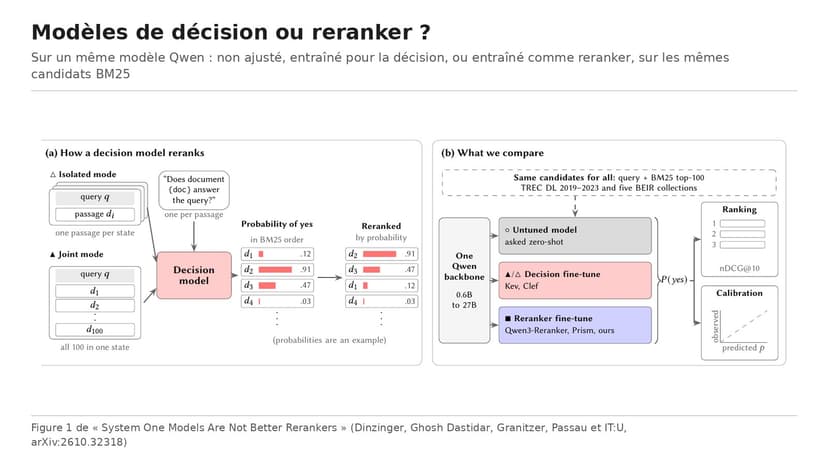
Trois chercheurs de l’université de Passau et de l’IT:U de Linz testent les « System One models », ces modèles qui répondent à une question par une probabilité calibrée, comme reclasseurs de résultats de recherche. Sur six modèles Qwen de 0,6 à 27 milliards de paramètres et dix collections, un simple entraînement de reranker gagne de 5,2 à 28,8 points de nDCG@10 jusqu’à 9 milliards, et fait jeu égal à 27 milliards. L’avantage de calibration des modèles de décision dépend, lui, de la façon de poser la question.

Lire la fiche →
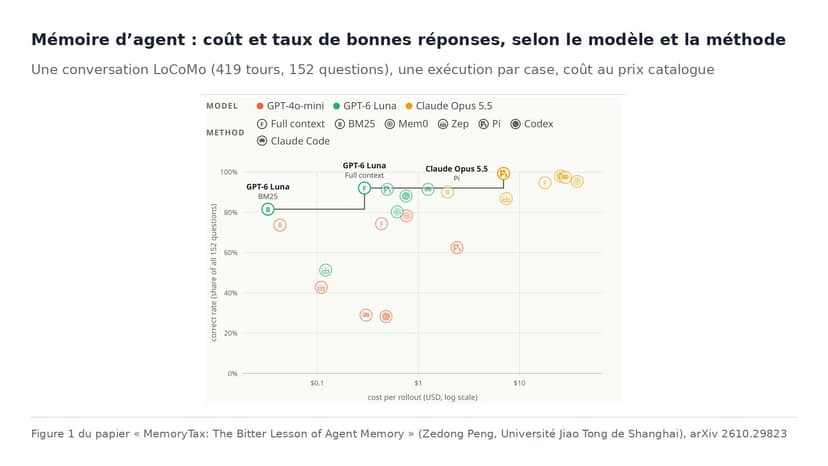
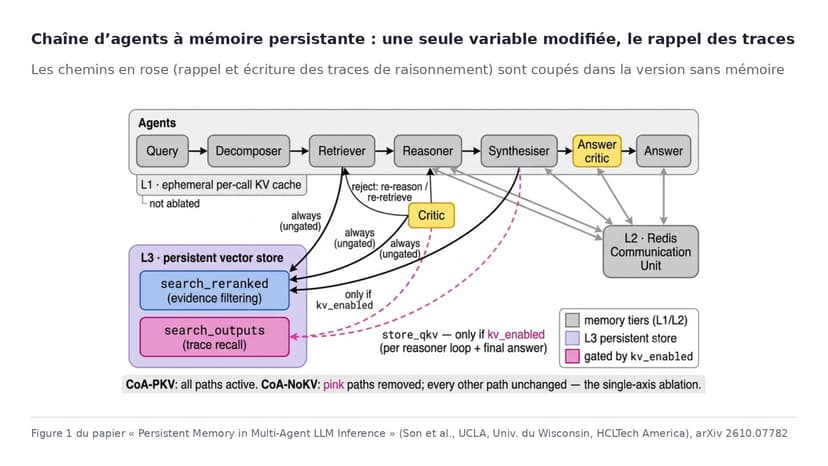
Memory Tax : la mémoire des agents coûte plus qu’elle ne rapporte face à un RAG naïf
Modeles IA

Memory Tax : la mémoire des agents coûte plus qu’elle ne rapporte face à un RAG naïf

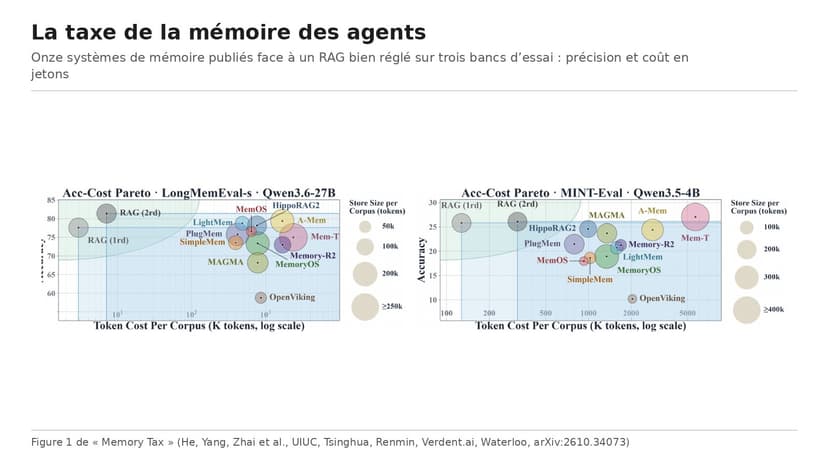
Une équipe menée par l’université de l’Illinois à Urbana-Champaign compare onze systèmes de mémoire pour agents à une simple recherche dans l’historique brut. Sur LongMemEval, aucun ne bat le RAG naïf, quel que soit le modèle, et sur 99 cases de résultats seules 9 sont au-dessus. Les auteurs mesurent ce que la mémoire fait gagner et ce qu’elle fait perdre, et montrent qu’ajouter l’historique brut à la recherche réduit nettement la perte.

Lire la fiche →
Agents de code : un relecteur indépendant vaut mieux qu’un agent qui se relit
Modeles IA

Agents de code : un relecteur indépendant vaut mieux qu’un agent qui se relit

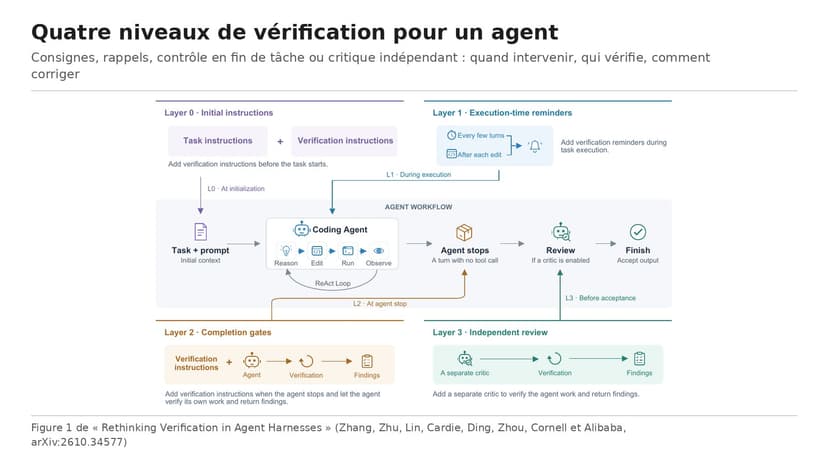
Une équipe d’Alibaba et de l’université Cornell compare 17 façons de faire vérifier son travail par un agent de code, sur sept modèles et deux bancs d’essai. Les consignes et rappels apportent peu, l’autocontrôle en fin de tâche coûte cher, et un critique séparé, peu coûteux, ajoute de 5,9 à 9,5 points sur Terminal-Bench pour 1,13 à 1,25 fois le coût de base, et de 3,9 à 6,6 points sur SWE-bench Verified pour presque rien.

Lire la fiche →
HarnessMM : un harnais d’agent qui réutilise ses décisions au lieu de rappeler le modèle
Modeles IA

HarnessMM : un harnais d’agent qui réutilise ses décisions au lieu de rappeler le modèle

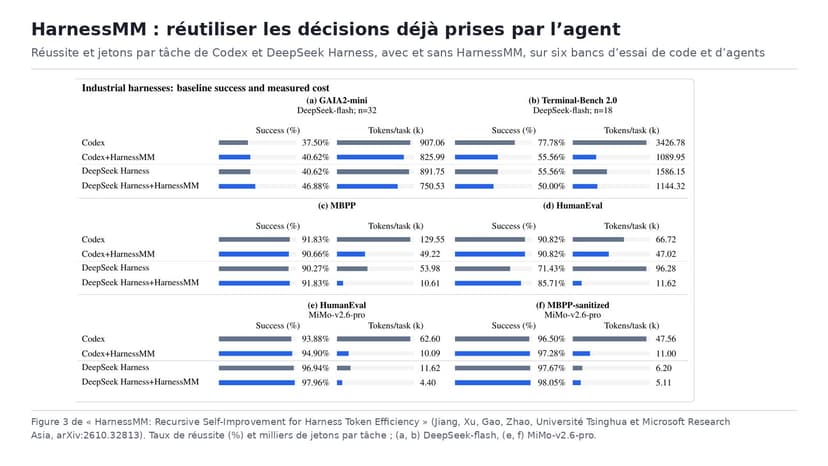
Une équipe de l’université Tsinghua et de Microsoft Research Asia constate que les harnais d’agents rappellent le modèle après chaque résultat d’outil, même quand la suite est déjà décidée. HarnessMM stocke ces décisions avec leurs conditions d’exécution et les rejoue sans nouvel appel. Sur 98 tâches HumanEval, Codex garde 90,82 % de réussite avec 29,54 % de jetons en moins, et DeepSeek Harness passe de 71,43 % à 85,71 % en divisant ses jetons par huit. Mais le gain mélange plusieurs réglages, et certains bancs d’essai reculent.

Lire la fiche →
Outils MCP en panne : un modèle cinq fois plus gros ne résiste pas mieux
Modeles IA

Outils MCP en panne : un modèle cinq fois plus gros ne résiste pas mieux

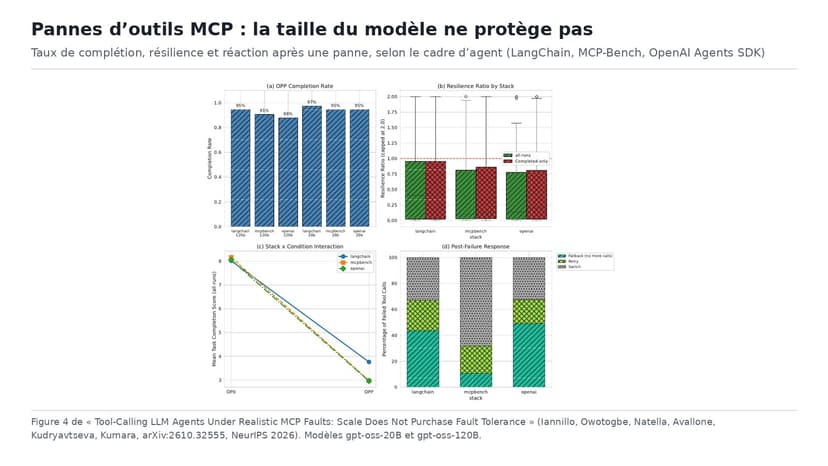
Des chercheurs des universités du Luxembourg, de Tilburg, de Naples et du Gran Sasso Science Institute injectent des pannes réalistes dans les outils MCP d’agents IA, calibrées sur 57 240 tickets de 1 774 dépôts open source. Le score d’accomplissement des tâches chute de 60 %, de 8,08 à 3,23 sur 10. gpt-oss-120B ne garde pas une plus grande part de son niveau que gpt-oss-20B et termine même un peu moins de tâches (91,1 % contre 95,6 %). Le cadre d’agent semble compter davantage que la taille du modèle.

Lire la fiche →
Google DeepMind : entraîné à bien argumenter, un modèle tranche plus vite sans mieux juger
Modeles IA

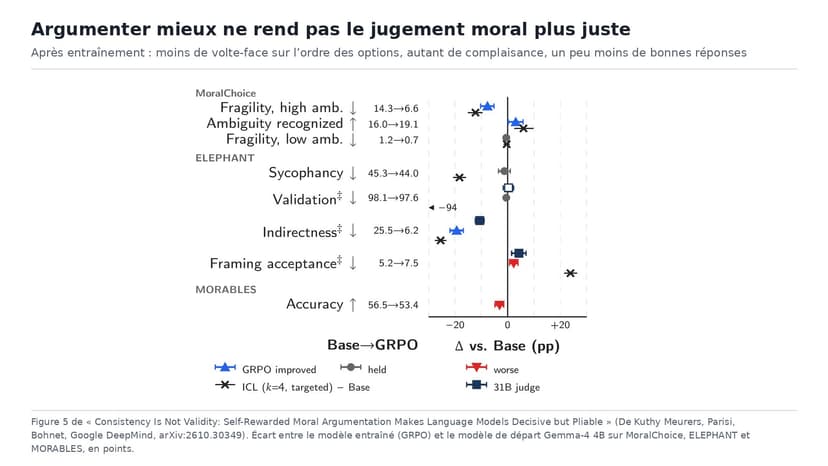
Google DeepMind : entraîné à bien argumenter, un modèle tranche plus vite sans mieux juger

Trois chercheurs de Google DeepMind entraînent Gemma-4 4B par renforcement à argumenter sur des dilemmes moraux tirés de romans classiques, en se notant lui-même. Le modèle devient plus décidé : ses volte-face quand on inverse l’ordre des options passent de 14,3 % à 6,6 %. Mais sa complaisance envers l’utilisateur ne bouge pas (45,3 % puis 44,0 %), il accepte un peu plus souvent le cadrage qu’on lui impose et sa précision sur les fables de MORABLES recule de 56,5 % à 53,4 %. La cohérence n’est pas la validité, concluent les auteurs.

Lire la fiche →
Modèles en boucle ou à profondeur croissante : ils apprennent davantage du contexte
Modeles IA

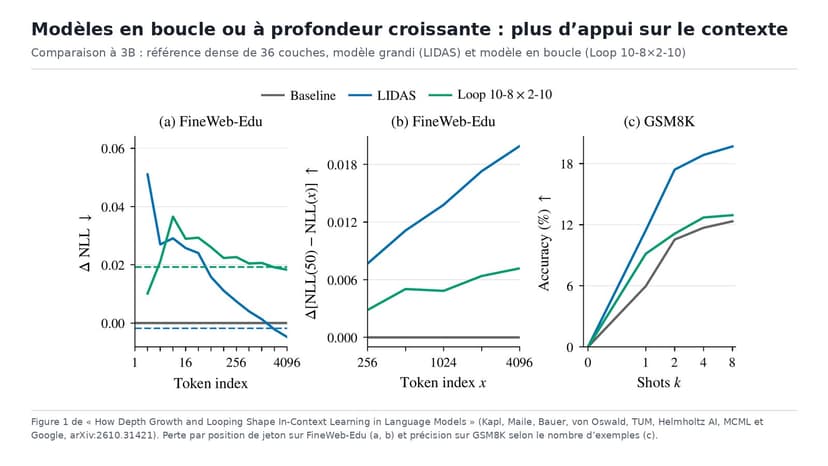
Modèles en boucle ou à profondeur croissante : ils apprennent davantage du contexte

Une équipe de la TUM, de Helmholtz AI, du MCML et de Google compare à 3 milliards de paramètres un modèle dense de 36 couches, un modèle dont on fait grandir la profondeur pendant l’entraînement et un modèle qui réutilise ses couches en boucle. Les deux variantes tirent plus profit de la fin du contexte et font mieux sur GSM8K avec exemples, environ 7 points de plus pour le modèle grandi à huit exemples. L’effet passe par les têtes d’induction copiées lors de la croissance, et il se paie par un apprentissage plus faible de ce qui est stocké dans les poids.

Lire la fiche →
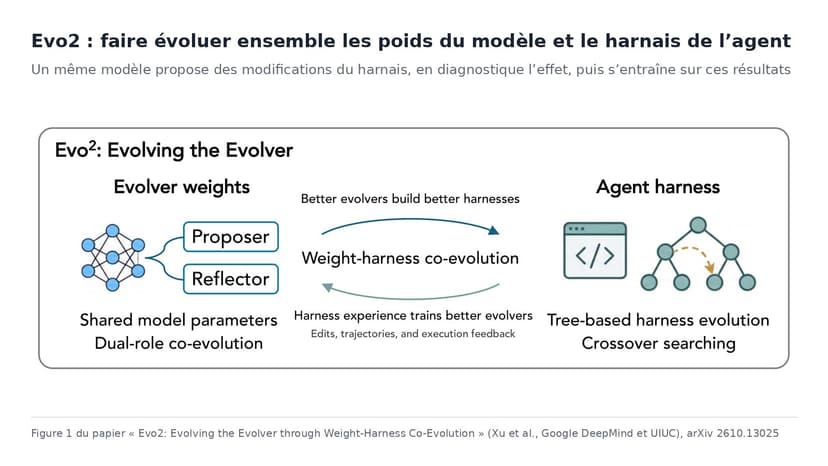
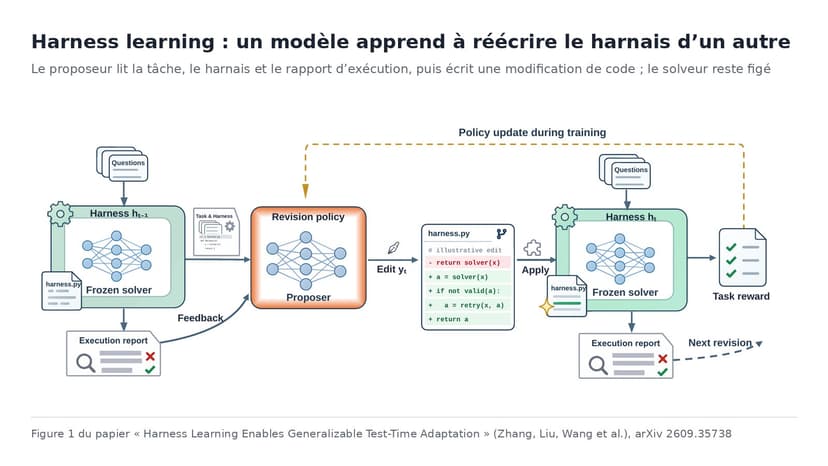
Un modèle peut-il améliorer son propre harnais ? Sur ARC-AGI-3, ses révisions transfèrent mal
Modeles IA

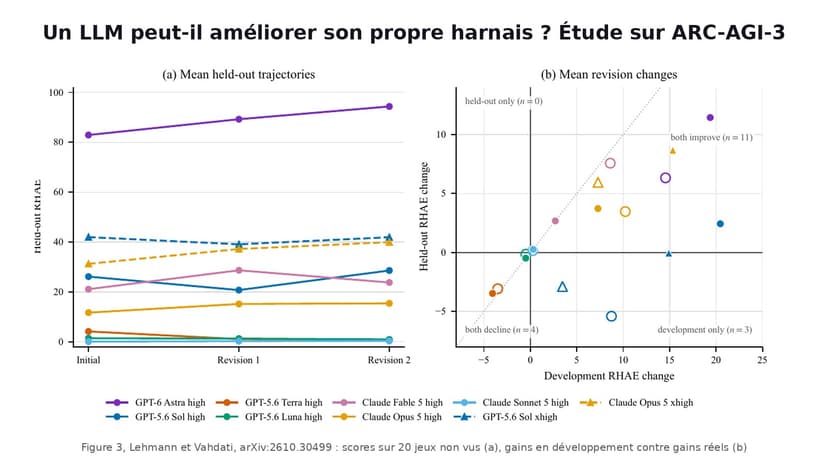
Un modèle peut-il améliorer son propre harnais ? Sur ARC-AGI-3, ses révisions transfèrent mal

Jens Lehmann et Sahar Vahdati laissent neuf profils de modèles construire seuls leur harnais pour les jeux d’ARC-AGI-3, puis le réviser deux fois à partir de leurs propres traces. Les modèles savent construire : les scores vont de 0 à 97 sur vingt jeux jamais vus. Mais deux révisions n’ajoutent que 2,80 points en moyenne, avec un intervalle qui inclut zéro, et les gains mesurés sur les jeux d’entraînement surestiment de 5,62 points le progrès réel. Les harnais pilotés par des humains atteignent 100.

Lire la fiche →
Mémoire d’agent : un RAG simple sur l’historique brut devance les systèmes complexes dans six réglages sur sept
Modeles IA

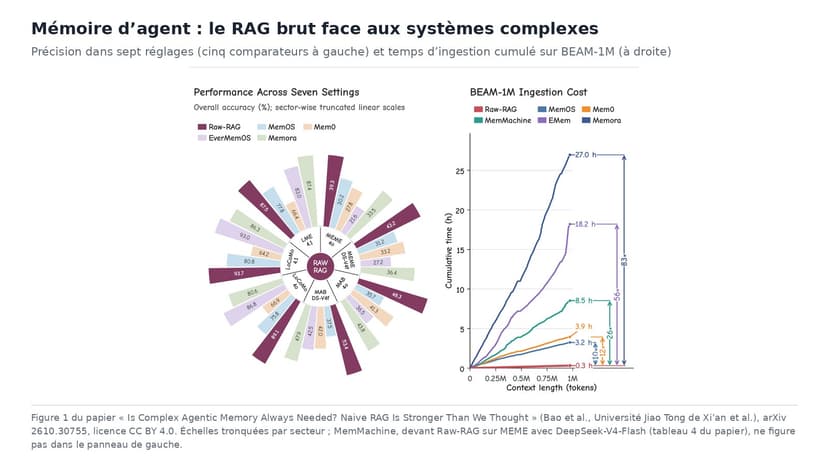
Mémoire d’agent : un RAG simple sur l’historique brut devance les systèmes complexes dans six réglages sur sept

Des chercheurs de quatre universités chinoises opposent une base de référence qui cherche simplement dans l’historique brut (recherche dense, reranking) à jusqu’à douze systèmes de mémoire d’agent, dont Mem0, MemOS et Memora. Elle arrive première dans six réglages sur sept, de 0,13 à 5,53 points devant le meilleur concurrent, et ingère un million de tokens en 0,3 heure contre 3,2 à 27 heures. Résultats limités à des conversations enregistrées.

Lire la fiche →
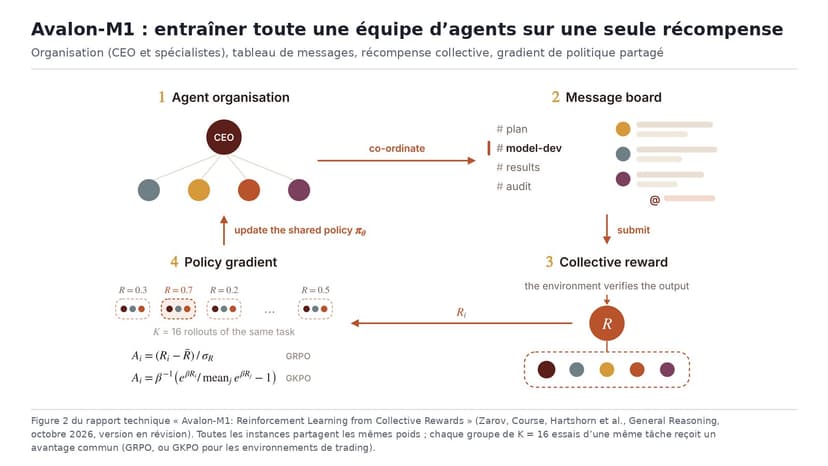
Avalon-M1 : General Reasoning entraîne toute une équipe d’agents sur une seule récompense
Modeles IA

Avalon-M1 : General Reasoning entraîne toute une équipe d’agents sur une seule récompense

General Reasoning entraîne un modèle de 120 milliards de paramètres à travailler en organisation : un agent CEO recrute jusqu’à huit spécialistes, tous issus des mêmes poids et récompensés comme une seule équipe. L’équipe gagne sur 14 benchmarks sur 16 face au même modèle seul (IMO-ProofBench-Advanced de 29,8 % à 37,5 %), mais une réflexion plus longue d’un agent seul récupère environ trois cinquièmes de ce gain. Le rapport, encore en révision, décrit aussi des hiérarchies apparues pendant l’entraînement et des agents qui alertent de moins en moins les humains.

Lire la fiche →
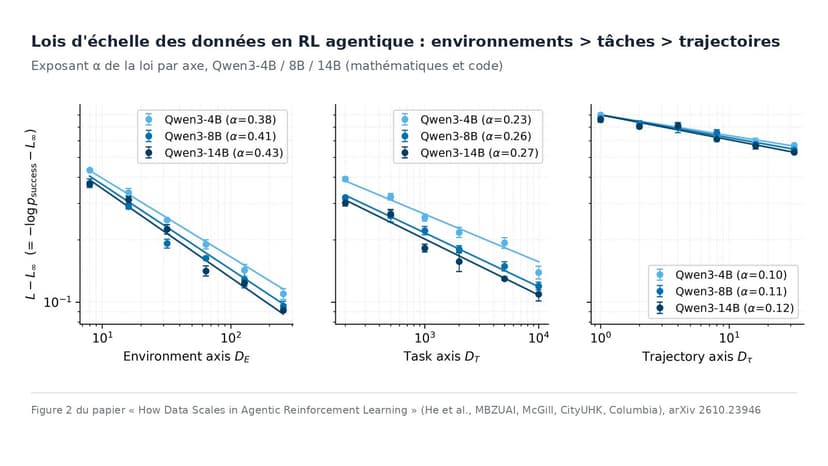
Agents IA : varier les environnements rapporte plus que multiplier les essais
Modeles IA

Agents IA : varier les environnements rapporte plus que multiplier les essais

Une équipe de MBZUAI, McGill, CityUHK et Columbia mesure, pour l’entraînement par renforcement des agents, ce que rapporte chaque type de données : les environnements d’abord, les tâches ensuite, les trajectoires en dernier. Elle en tire une règle de répartition du budget, qui fait jusqu’à 1,4 fois mieux qu’une répartition à la Chinchilla et 1,7 fois mieux que le tout-trajectoires.

Lire la fiche →