Titre original : The Inbox as a Coordination Primitive for LLM Agent Societies
Auteurs : Karthik Sreedhar, Leo Yuan, Pradyumna Chari et Ramesh Raskar, MIT Media Lab (Cambridge, États-Unis). Le premier auteur donne une adresse de l’université Columbia.
Publication : prépublication arXiv 2610.36264v1 (cs.MA), déposée le 26 octobre 2026, 11 pages, présentée comme soumise à relecture. Licence Creative Commons CC BY 4.0. Les auteurs indiquent que les scripts et toutes les données derrière les tableaux sont publiés avec le papier, sans donner d’adresse dans le PDF.
Liens : page arXiv, PDF.
L’idée en bref
Les protocoles d’agents (MCP, A2A) et les annuaires d’agents s’occupent surtout d’une chose : faire arriver un message à destination. Les auteurs soutiennent que, pour un agent fondé sur un modèle de langage, le problème est ailleurs. Envoyer ne coûte presque rien ; lire coûte des tokens, et chaque message lu prend une place dans un contexte de taille finie.
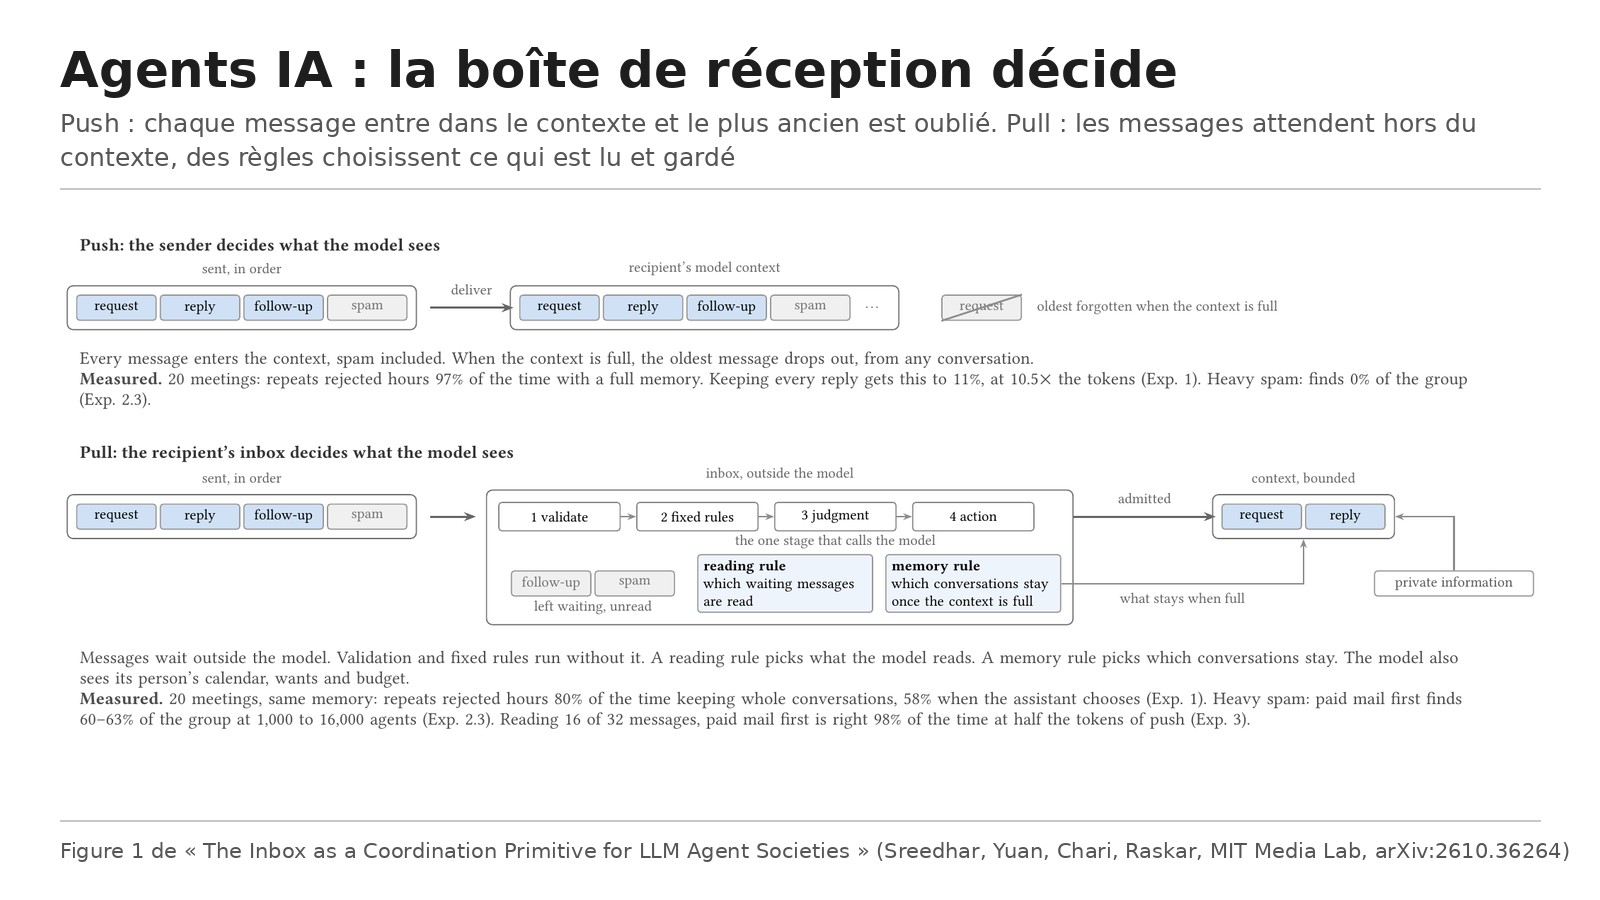
Aujourd’hui, la plupart des systèmes fonctionnent en « push » : l’expéditeur décide quand son message entre dans le contexte du destinataire, qui lit dans l’ordre d’arrivée et oublie les plus anciens quand le contexte est plein. Le papier étudie l’inverse, le « pull » : les messages attendent dans une boîte de réception hors du contexte, et ce sont les règles propres à chaque agent qui décident de ce qu’il lit et de ce qu’il garde. Comme ces règles privées décident aussi si les demandes des autres agents aboutissent, les auteurs parlent de la boîte de réception comme d’une brique de coordination à part entière (sections 1 et 3).
Ce que montre le papier
Quatre décisions pour une boîte de réception
Une boîte de réception se résume à quatre choix (tableau 1). Ce que l’agent lit : ordre d’arrivée, lecture par lots, tri par dossiers, les plus récents d’abord, les messages accompagnés d’une caution d’abord, les plus proches de ses centres d’intérêt, ou un choix fait par le modèle à partir d’une ligne par message. Ce qu’il garde : oublier le plus ancien, résumer, garder des conversations entières, laisser le modèle choisir, ou tenir une simple liste des engagements pris. Ce que paie l’expéditeur : rien, ou une caution remboursée si le message est lu et traité, perdue sinon. Ce que la réponse peut dévoiler : un oui ou non, un oui avec une condition, un oui avec une limite tirée d’informations privées, ou tout.
Les tâches testées sont la planification de réunions sur plusieurs tours, avec agendas privés, et la formation de groupes d’agents partageant un même intérêt. Toutes les décisions sont prises par un modèle, gpt-5.6-terra par défaut, avec des vérifications sur gpt-5.4-mini et gpt-5.6-sol (section 4).
Le push s’effondre quand un agent mène trop de conversations
Un organisateur gère de 2 à 20 réunions en parallèle, avec cinq invités chacune. Garder tout l’historique fonctionne presque aussi bien qu’une récupération parfaite, mais coûte cher : à 20 réunions, 10,5 fois les tokens du cas idéal. Avec une mémoire bornée, oublier les messages les plus anciens, c’est-à-dire le push, conduit à reproposer des créneaux déjà refusés dans 97 % des cas. Garder des conversations entières ramène ce taux à 80 %, et laisser le modèle choisir quoi garder à 58 %, contre 11 % environ avec tout l’historique (section 4.1, figure 2).
Côté invité, le problème est différent : même avec toutes ses réponses passées sous les yeux, le modèle propose un créneau déjà promis ailleurs dans 60 à 69 % des cas. Une liste compacte des promesses déjà faites ramène ce taux à 28 % à 20 invitations (section 4.2.2). Autrement dit, ce qu’il faut garder dépend du rôle de l’agent.
Sous un trafic massif, une boîte de réception devient indispensable
Dans des sociétés de 1 000, 4 000 et 16 000 agents, 24 agents partagent un intérêt privé et un demandeur doit en trouver dix. Les auteurs choisissent volontairement un volume de messages indésirables qui submerge la lecture dans l’ordre d’arrivée : le push ne lit alors aucune demande utile. En lisant d’abord les messages accompagnés d’une caution, et avec un annuaire ou un appariement, l’agent retrouve environ 60 % des agents utiles (60 à 63 % selon la figure 1) à toutes les tailles, et un groupe se forme dans à peu près la moitié des sociétés (section 4.2.3).
Les pertes se cumulent quand les demandes sont relayées
Sur un vrai graphe de messagerie (email-Eu-core, 1 005 membres et 24 929 liens), une demande transmise de proche en proche doit être lue à chaque étape. Quand la moitié des agents seulement adopte la lecture avec caution, la recherche directe conserve 42 à 53 % du résultat obtenu avec une adoption complète, mais la recherche relayée n’en conserve que 26 %, 10 % et 5 % à mesure que le réseau grandit. Le tri par dossiers, lui, garde 21 à 26 % du résultat en recherche directe, mais 4 à 10 % en recherche relayée, notamment parce que le modèle classe souvent de vraies demandes en indésirables (section 4.2.4, tableau 3).
Aucune règle de lecture n’est la meilleure partout
Sur 32 messages entrants, quand l’agent ne peut en lire que 4, le laisser choisir trouve le bon message dans 77 % des cas, contre moins de la moitié pour toutes les autres règles, mais pour près de cinq fois les tokens du cas idéal. Quand il peut en lire 16, lire d’abord les messages avec caution trouve toujours la cible et répond juste dans 98 % des cas, pour environ un quart des tokens du choix par le modèle (section 4.3, tableau 4). La caution a toutefois ses limites : un attaquant qui paie la même caution ramène la règle à l’ordre d’arrivée, et un attaquant qui paie le double empêche les vraies demandes d’être lues (section 4.4).
Les limites
Les auteurs reconnaissent que (section 5.4) :
- les expériences reposent sur deux tâches simulées et des modèles d’un seul fournisseur ;
- pour rendre les grandes simulations possibles, les agents qui reçoivent exactement les mêmes informations partagent la même réponse du modèle : une simulation à 16 000 agents ne fait que 6 à 23 appels au modèle, et une erreur s’applique à tout le groupe concerné (annexe A) ;
- le trafic indésirable est choisi exprès pour submerger la lecture dans l’ordre d’arrivée, les règles sont fixes, et les agents qui adaptent leurs règles ou les messages conçus pour manipuler la sélection par le modèle ne sont pas étudiés ;
- la première expérience s’est révélée sensible aux consignes données au modèle : un écart initial entre historique complet et récupération parfaite a disparu après correction des instructions.
Réserves de notre lecture, tirées du papier :
- Les auteurs ne proposent pas d’implémentation et ne prétendent pas qu’une règle soit optimale ; le papier établit un cadre et des ordres de grandeur, pas un produit.
- La caution remboursable suppose une forme de paiement entre agents, dont la mise en place pratique n’est pas traitée.
- Le partage des réponses entre agents identiques signifie que les chiffres à 16 000 agents mesurent surtout l’effet des règles de boîte de réception à grande échelle, pas 16 000 décisions indépendantes, ce que les auteurs disent eux-mêmes.
Lecture Neurone21
Pour une entreprise qui commence à faire travailler plusieurs agents ensemble, la leçon est concrète : dès qu’un agent reçoit des demandes de plusieurs sources (un agent de support qui traite des tickets, un agent achats qui reçoit des relances fournisseurs, un coordinateur qui suit plusieurs dossiers), il faut décider explicitement ce qu’il lit et ce qu’il garde, au lieu de tout empiler dans son contexte. Le chiffre de 97 % de créneaux déjà refusés reproposés illustre bien une panne que l’on observe en pratique : l’agent n’est pas « bête », il a simplement oublié la réponse la plus ancienne.
Le papier donne aussi une piste simple et peu coûteuse : une mémoire organisée selon le rôle. Un coordinateur a besoin de conversations complètes ; un agent qui prend des engagements a besoin d’une liste courte de ce qu’il a promis. C’est exactement le type de règle qu’on peut écrire dans la configuration d’une équipe de bots, comme nous l’expliquons dans notre dossier sur la façon de monter une équipe d’agents IA. Sur la mémoire des agents, voir aussi notre fiche sur la taxe de la mémoire des agents.
Le post d’Elvis Saravia est fidèle aux chiffres du papier. Une précision toutefois : quand il écrit que la lecture dans l’ordre d’arrivée « rate toutes les demandes », c’est une condition choisie par les auteurs pour stresser le système (le volume de messages indésirables est réglé pour cela), pas un résultat observé dans un usage réel.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.36264
- Le PDF : https://arxiv.org/pdf/2610.36264v1
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2115875068802895878
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/the-inbox-as-a-coordination-primitive-for-llm-agent-societies-2610.36264