Monter une équipe d’agents IA : comment découper, configurer et faire coopérer des bots
Notre dossier sur le harnais expliquait ce qui entoure un modèle pour en faire un agent : la boucle, les outils, le contexte, les droits. Beaucoup de lecteurs n’ont pas à construire cela : ils utilisent une plateforme d’agents qui le fournit. La boucle d’agent elle-même est donc fournie par la plateforme, et ce dossier ne la détaille pas. Il porte sur ce qui reste à votre charge : la couche métier, celle que vous voyez et que vous réglez.
Les exemples viennent de l’expérience de Steropes, éditeur de Neurone21.
1. Une équipe plutôt qu’un seul agent… et quand ne pas le faire
Les documentations s’accordent sur les raisons de découper. LangChain en cite trois : gérer le contexte (donner à chaque agent seulement le savoir utile), permettre à plusieurs équipes de maintenir leurs briques séparément, et paralléliser. Anthropic ajoute la séparation des préoccupations : chaque sous-agent a ses outils, ses consignes et sa trajectoire. Côté droits, la documentation du Claude Agent SDK note qu’on peut limiter un sous-agent à des outils précis, par exemple un relecteur qui lit mais ne modifie rien.
Le contrepoint est dans les mêmes sources. Anthropic recommande de chercher la solution la plus simple, quitte à ne pas construire de système d’agents du tout. LangChain écrit qu’un seul agent bien outillé obtient souvent des résultats comparables. Pour son système de recherche, Anthropic mesure qu’un agent consomme environ 4 fois plus de jetons qu’un échange classique et qu’un système multi-agent environ 15 fois plus : l’équipe n’est rentable que si la valeur de la tâche le justifie. Le même billet précise que la plupart des tâches de code se parallélisent moins bien que la recherche. En sens inverse, notre fiche sur la mémoire persistante rapporte qu’un système multi-agent mesuré sur matériel local divise par 2,5 la mémoire de travail de son plus gros appel : le découpage a un avantage technique réel, mais il a un prix. Notre billet sur l’étude Apple et EPFL va dans le même sens.
Anthropic rapporte aussi un gain de 90,2 % pour son système multi-agent face à un agent seul, mais sur une évaluation interne de recherche, pour des questions qui se divisent en directions indépendantes. Cela ne dit rien de votre cas.
Ces sources sont des fournisseurs : Anthropic, OpenAI et LangChain vendent des outils d’agents. Leurs conseils sont utiles et leurs chiffres viennent de leurs propres tests. De notre côté, nous n’avons mesuré aucune comparaison entre notre équipe et un agent unique. Nous avons découpé pour des raisons d’organisation, de droits et de risque, pas de performance.
2. Ce que vous réglez : la fiche d’un bot
| Élément | À quoi il sert | Réglage conseillé |
|---|---|---|
| Nom, titre, description | Dire à vous, aux collègues et à la plateforme qui est ce bot et quand l’appeler | Une description qui dit ce que le bot fait et ne fait pas |
| Mémoire | Garder d’une conversation à l’autre ce qui est durable | Des préférences et des décisions, pas des journaux |
| Compétences | Des procédures réutilisables, chargées quand elles servent | Une procédure qui revient souvent devient une compétence |
| Routines | Du travail récurrent déclenché à heure fixe | Une règle d’arrêt écrite (quota, condition) |
| Connecteurs | Les services que le bot peut atteindre | Le minimum pour sa mission |
| Droits | Ce qu’il peut lire, écrire, envoyer, publier | Lecture d’abord ; envoi et mise en ligne seulement avec un go humain |
| Collègues | Les autres bots à qui il peut écrire | Un chef, des relais écrits |
Le rôle. La description sert aussi de signal de routage : la documentation du Claude Agent SDK explique que la description d’un sous-agent indique à Claude quand l’utiliser, et OpenAI propose une description de passage de relais pour la même raison. Nos fiches de rôle ont toutes la même forme : une phrase d’identité qui nomme aussi ce que le bot n’est pas (« tu ne chasses pas, tu n’écris pas l’offre, tu n’inventes pas les prix »), une section Rôle, des règles dures, la langue et le ton. Les interdits reviennent d’un bot à l’autre : ne pas inventer de prix, ne pas mélanger les projets ni les clients, ne rien mettre en production (DNS, HTTPS, mise en ligne) sans l’accord explicite de Laurent, ne rien envoyer à l’extérieur sans son go.
Une consigne n’est pas un verrou. La documentation de Claude Code le dit sans détour : les fichiers d’instructions sont du contexte, pas une configuration appliquée ; pour bloquer une action quoi que décide le modèle, il faut une règle d’autorisation ou un contrôle technique. Sur une plateforme grand public, ce verrou, ce sont vos droits et connecteurs : un bot sans accès à la mise en ligne ne peut pas y aller. Nous y reviendrons dans les erreurs.
La mémoire. Claude Code distingue ce que vous écrivez (instructions) de ce que l’agent note lui-même (préférences, corrections), recommande des fichiers courts, moins de 200 lignes, et conseille d’y ajouter une règle quand la même erreur se répète. Chez nous, elle porte des préférences durables : Laurent préfère un bot par projet plutôt qu’un fourre-tout, l’orthographe du nom de l’entreprise (« Steropes », sans accent), la cadence éditoriale voulue, la règle de préparation des scripts. Certains faits sont partagés d’un bot à l’autre, d’autres restent propres à un seul. Gardez-la petite : notre fiche sur la mémoire persistante mesure un coût réel et aucun gain de précision détectable sur les tests usuels, et celle sur MemoryTax montre qu’une couche de mémoire élaborée n’aide guère un modèle fort. Ces papiers testent des systèmes de recherche, pas des notes de préférences ; ils invitent à mesurer plutôt qu’à supposer.
Les compétences. Dans le Claude Agent SDK, une compétence est un fichier d’instructions avec une description, chargé quand la demande correspond. La procédure d’un lot de billets (vérifier les doublons, écrire, produire les couvertures, établir un manifeste et des empreintes SHA-256, générer le script d’application) revient chaque jour : c’est le candidat naturel. Chez nous, elle repose encore sur des scripts de fabrication et des consignes.
Les routines. Notre « croisière » est une routine en semaine, le matin, à 9h15 heure de Paris au moment où nous l’avons réglée. Sa règle d’arrêt est écrite : si le lot du matin a déjà atteint le quota du jour, elle ne rédige rien. Nos journaux de routine montrent que c’est arrivé à plusieurs reprises. Une routine peut aussi être ponctuelle : une routine unique relit une source, puis est supprimée.
Les connecteurs. Ils suivent le rôle : le bot qui rédige les e-mails prépare des brouillons et n’en envoie aucun sans go ; le bot qui audite le référencement écrit son diagnostic dans un fichier et ne pousse rien en ligne. Le standard ouvert MCP sert à brancher des outils et des données à une application d’agent de façon uniforme ; selon la plateforme, vous le rencontrerez sous le nom de connecteurs.
3. Comment découper
- Par projet ou par client. C’est la préférence de Laurent et la règle de notre Coordinateur : trois niveaux, un chef pour tous les projets, un bot par offre, puis un bot dédié par client sous l’offre. Un client, un bot : pas de mélange.
- Par métier. Écrire des e-mails, auditer le référencement, coder, rédiger un média, gérer la sécurité sont des métiers différents, avec des consignes et des outils différents. OpenAI le recommande : des agents spécialisés plutôt qu’un généraliste censé tout faire.
- Par niveau de risque. Celui qui prépare n’est pas celui qui publie. Chez nous, une chaîne sépare qui rédige, qui code, qui met en production, et un humain donne le go.
Règle pratique : séparez quand les droits ou le contexte divergent, pas avant. Anthropic raconte que ses premières versions lançaient jusqu’à 50 sous-agents pour une question simple. Un bot de plus est un contexte de plus à entretenir et un relais de plus à surveiller.
4. Passer le relais
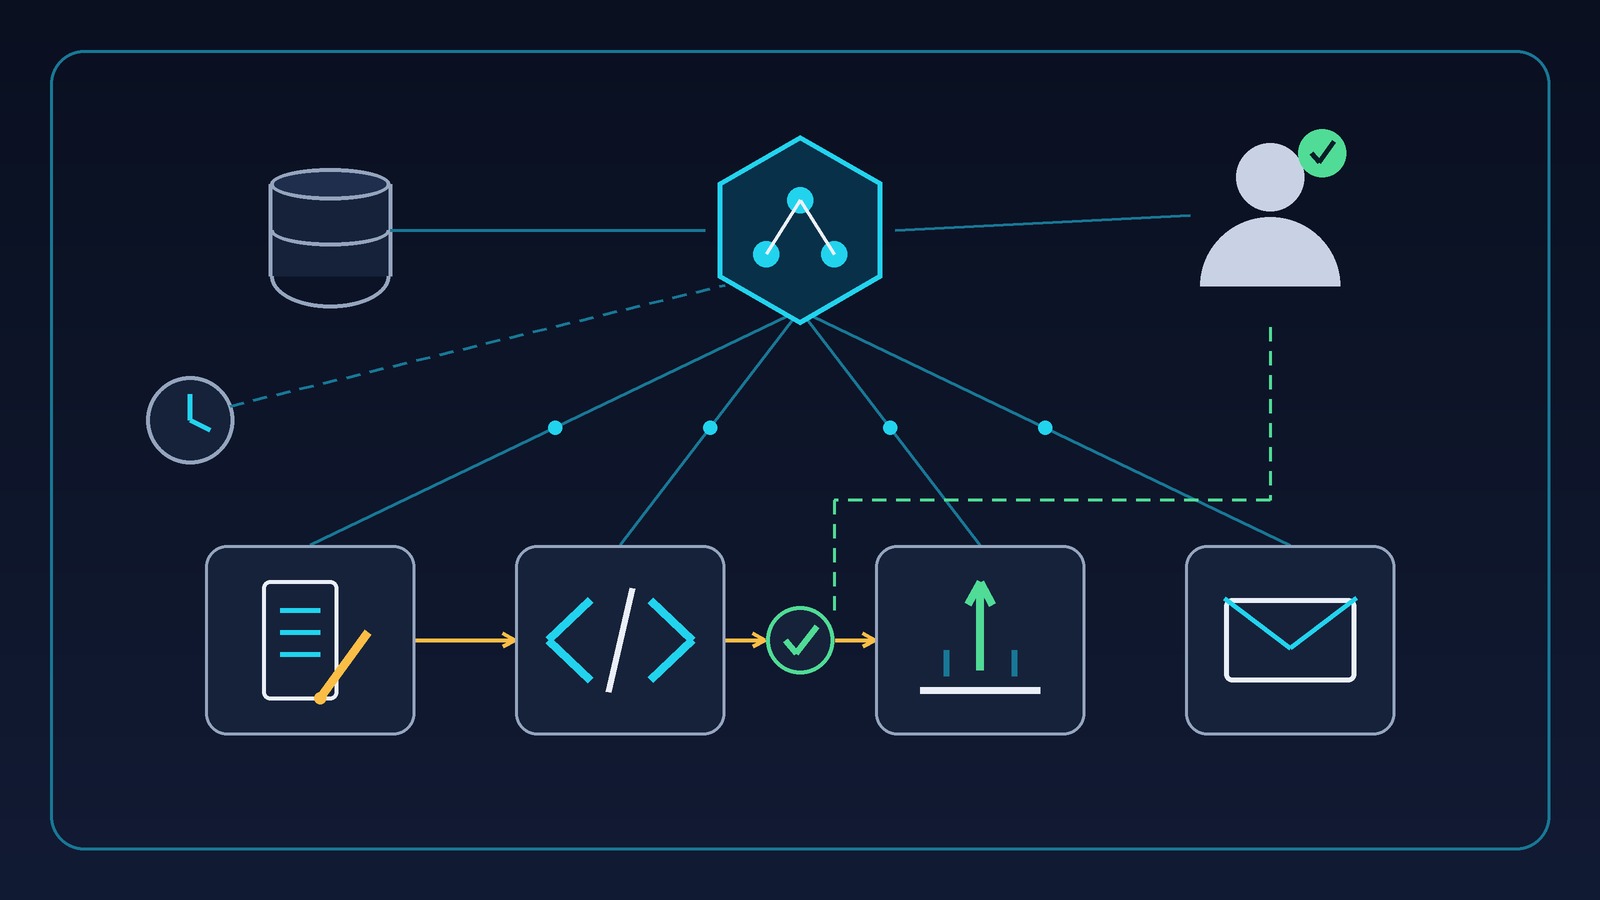
Un chef, qui découpe. Notre Coordinateur traduit une demande de Laurent en missions claires vers le bon bot, puis remonte un statut court. Il n’exécute pas lui-même. C’est le schéma « orchestrateur et travailleurs » d’Anthropic, ou l’« agent comme outil » d’OpenAI : le manager garde la main sur la réponse finale.
Des messages, mais surtout des écrits. Les bots s’écrivent entre eux, par exemple pour envoyer un correctif au Responsable technique ou lui transmettre le go de mise en production. Le plus important est ailleurs : toute demande de modification de code passe par un petit fichier Markdown, un fichier par demande et par projet. Il indique la source, le bot qui code, si la mise en production est autorisée (non, tant que Laurent n’a pas donné son go), le périmètre, les contraintes (recette locale seulement, un seul commit, ajout de fichiers par chemin explicite), ce qui est hors sujet et le critère de fin. Il n’y a ni clé ni donnée sensible dedans.
Ce n’est pas un hasard. Anthropic constate que sans description détaillée, des sous-agents dupliquent le travail ou laissent des trous : chacun a besoin d’un objectif, d’un format de sortie, d’outils et de limites. La documentation du Claude Agent SDK précise qu’un sous-agent ne reçoit que la consigne qu’on lui passe, d’où l’intérêt d’y inscrire chemins, erreurs et décisions. Et Anthropic recommande de faire passer les gros livrables par des fichiers plutôt que par la conversation, pour éviter le « téléphone arabe ».
Sans demande écrite, le bot de code ne bouge pas. C’est écrit dans sa fiche de rôle, comme chez le Responsable technique et le bot sécurité. À la fin, il rend compte : le fichier de demande, le dépôt et la branche, quelques lignes de différence, comment recetter, et la mention que la mise en production reste à autoriser.
Un humain qui valide, un autre bot qui exécute. Le Responsable technique cadre, découpe, vérifie, tient l’état des chantiers et ne code pas seul une application entière ; le bot dédié à git valide et met en ligne sous son pilotage ; Laurent donne le go. Anthropic le rappelle : même avec des tests automatiques, la relecture humaine reste décisive. Notre fiche sur la triche à la récompense ajoute une raison : dans une équipe d’agents qui partagent code et mémoire, une mauvaise astuce se transmet, et un vérificateur séparé en limite les dégâts sans les supprimer.
Attention à ce que vous transmettez. Dans l’Agents SDK d’OpenAI, l’agent qui reçoit la main voit par défaut tout l’historique de la conversation, et le résumé d’historique imbriqué ne retire pas les données sensibles ; la documentation invite à traiter l’agent receveur comme destinataire de tout ce qui est transmis. Transmettez le minimum.
5. Exemple : une équipe média, anonymisée
| Rôle | Fait | Ne fait pas |
|---|---|---|
| Rédacteur média | Écrit les billets et fiches, produit couvertures, manifeste et empreintes, prépare le pack et le script d’application ; prévient quand un lot est prêt | Ne met rien en production, ne pousse pas dans git, ne relance pas l’application sur le PC, n’invente aucun tarif |
| Responsable technique | Cadre et découpe, tient l’état des chantiers, synchronise les packs sur le PC, vérifie, fait mettre en ligne après go | Ne code pas seul une application entière, rien en production sans go |
| Bot de code | Implémente une demande écrite, recette en local, rend compte | Ne patche pas sans fichier de demande, ne déploie pas, ne mélange pas les projets |
| Bot de mise en ligne | Récupère les sites, les met sous git, valide et met en production sous pilotage du Responsable technique | Ne code pas |
| Coordinateur | Orchestre, découpe une demande en missions, remonte un statut court | Ne code pas en solo, ne chasse pas lui-même, n’invente pas de prix, rien d’externe sans go |
| Bot e-mail | Rédige des brouillons, au nom du dirigeant, en français | N’envoie rien sans go explicite |
| Bot référencement | Audite un site à la fois, écrit son diagnostic dans un fichier | Ne pousse pas, ne met pas en production |
6. Erreurs réelles et règles tirées
Certaines règles sont nées d’un incident, d’autres ont été posées d’emblée. Nous distinguons les deux. Les trois premières tournent autour d’un même petit outil, le script d’application, et d’une question simple : qui le lance ?
Le scénario de départ
Le bot rédacteur prépare un lot de billets dans un dossier à part, le pack. On y trouve les billets, leurs images de couverture, une liste de tous les fichiers avec leur empreinte et un petit script d’application. L’empreinte est une sorte de sceau numérique : si un fichier change d’un seul caractère, son empreinte change. Une fois lancé, le script vérifie que chaque fichier correspond à son empreinte, puis le présente au décideur. À ce stade, rien n’est encore en ligne : la mise en ligne est une étape distincte, qui attend un feu vert humain.
Erreur 1 — Un script d’application qui écrasait
Les scripts de nos premiers lots copiaient chaque fichier du pack avec une option de forçage. Si un billet du même nom existait déjà sur l’ordinateur, il était remplacé sans rien demander. Les derniers de ces scripts affichaient seulement un avertissement « écrase », mais le remplacement avait lieu quand même. Une version relue ou corrigée à la main sur place pouvait donc être remplacée par la version brute du pack, sans que personne s’en aperçoive.
Depuis, le script refuse d’écraser un billet ou une couverture déjà présents : il passe au fichier suivant, copie ce qui est neuf et se termine par un message « partiel », qui signale qu’un humain doit regarder. Le Responsable technique en a fait une consigne : jamais de forçage.
Règle : mettez la protection dans l’outil, pas seulement dans la consigne. Une consigne peut être oubliée ou mal lue ; un script qui refuse d’écraser protège même le jour où personne n’y pense.
Erreur 2 — Deux variables qui ne diffèrent que par la casse
PowerShell, le langage de script utilisé sur le PC, ne fait pas la différence entre majuscules et minuscules dans les noms de variables : « Base » et « base » y désignent la même case. Dans la première version d’un script, la liste des empreintes portait le même nom que la variable qui contenait le dossier de destination, à la casse près. L’une prenait la place de l’autre : le script pouvait alors viser le mauvais endroit ou s’arrêter sur une erreur. La liste a été renommée, et le Responsable technique a posé une consigne de nommage : jamais deux variables qui ne diffèrent que par la casse.
Règle : écrire la contrainte de nommage dans la consigne, et relire un script écrit par un bot comme du code. Le bug est discret, parce que chaque ligne, lue isolément, paraît correcte.
Erreur 3 — Qui lance le script ?
Le script d’application est le début de l’étape qu’on rattrape mal. Si plusieurs acteurs peuvent le lancer, chacun peut croire que l’autre l’a fait, ou le relancer sans savoir où en est le lot. Prenons le cas du bot rédacteur qui relancerait le script sur un lot déjà en ligne : avec des fichiers identiques, rien ne casserait ; mais si le lot avait été corrigé entre-temps, le risque serait réel. Nous ne le citons pas comme un accident : c’est le risque que la règle suivante écarte.
Le Responsable technique a fixé la répartition : le rédacteur prépare le pack, vérifie les empreintes, puis s’arrête ; le Responsable technique applique le pack ; la mise en ligne n’a lieu qu’après le go du dirigeant. Dans l’ordre : le rédacteur prépare et vérifie, le Responsable technique applique, le dirigeant donne le go, le Responsable technique met en ligne.
| Qui | Ce qu’il fait | Ce qu’il ne fait pas |
|---|---|---|
| Bot rédacteur | Prépare le pack, vérifie les empreintes, s’arrête | Ne lance pas le script d’application, ne met rien en ligne |
| Responsable technique | Applique le pack, puis met en ligne une fois le go reçu | Ne met rien en ligne sans le go |
| Dirigeant | Donne le go avant la mise en ligne | N’exécute rien lui-même |
Règle : un seul acteur exécute l’étape irréversible, et ce rôle est écrit. Les empreintes sont vérifiées avant toute copie, par le rédacteur à la fabrication puis par le script à l’application.
Erreur 4 — Un billet publié au conditionnel, puis corrigé par une routine
Un jour, un billet sur une annonce encore non confirmée officiellement est publié, avec l’accord du responsable éditorial, au conditionnel, parce que l’annonce officielle n’est pas encore sortie. Le lendemain, une routine ponctuelle, prévue pour cela, reprend le billet avec la source officielle : c’est une déclaration d’intention, sans montant officiel, et plusieurs entreprises citées par la presse n’y sont pas nommées. Le billet est corrigé (texte, titre, description), le correctif part chez le Responsable technique et la routine est supprimée.
Règle : écrivez ce qui est confirmé, planifiez la vérification, nettoyez la routine.
Erreur 5 — Ne pas rester silencieux
Le dirigeant veut être prévenu dès qu’un lot est prêt, même si son PC est hors ligne. Sans cela, un lot pourrait attendre sans que personne le sache. À l’inverse, quand la routine ne fait rien parce que le quota du jour est atteint, elle ne dérange personne.
Règle : un message quand il y a quelque chose à décider, rien sinon.
Règle posée d’emblée — Un bot de code sans demande écrite
Cette règle figure dans les fiches de rôle ; nous n’avons pas d’incident documenté à citer et préférons ne pas en inventer un. Elle empêche qu’un bot « invente » une demande.
Règle : pas de fichier de demande, pas de patch.
7. Mise en route en 5 étapes
Étape 1 — Un projet, un bot
Rédigez sa fiche : nom, titre, description avec ce qu’il fait et ne fait pas, quelques interdits clairs.
Étape 2 — Réglez le minimum
Trois à cinq faits en mémoire, les connecteurs strictement nécessaires, des droits en lecture d’abord.
Étape 3 — Ajoutez un deuxième bot seulement si droits ou contexte divergent
Et nommez le chef.
Étape 4 — Écrivez le relais
Un modèle de demande, les points où un humain dit « go », et qui exécute les étapes irréversibles.
Étape 5 — Automatisez, mesurez, corrigez
Une routine avec sa règle d’arrêt ; relisez les résultats. Anthropic suggère de commencer l’évaluation avec une vingtaine de cas réels. À chaque erreur qui se répète, ajoutez une règle.
8. Limites et coûts
- Jetons et coordination : les chiffres d’Anthropic (environ 4 fois, environ 15 fois) viennent d’un système de recherche, pas du vôtre. Le Claude Agent SDK prévoit des plafonds de profondeur, de simultanéité et de dépense ; regardez ce que votre plateforme offre.
- Effets imprévus : Anthropic note que de petits changements chez le chef modifient le comportement des autres.
- Nos propres limites : aucune mesure comparative, aucun chiffre de coût chez nous, et une équipe qui dépend d’humains disponibles (un PC hors ligne retarde la synchronisation).
- Mémoire partagée : pratique, mais une erreur qui s’y glisse circule.
- Plateforme : la boucle d’agent n’est pas détaillée ici ; nos exemples décrivent seulement ce que nous réglons.
9. Lecture Neurone21
Le principe qui se généralise : découpez selon les droits et les risques, écrivez les relais, mettez les protections dans les outils, gardez un humain sur ce qui ne se rattrape pas. L’équipe de bots de Steropes repose sur des fichiers de demande, des manifestes, des contrôles d’empreintes et un go humain, bien plus que sur l’intelligence des bots seule.
Notre expérience n’est pas une preuve qu’une équipe vaut mieux qu’un seul agent. Les fournisseurs disent eux-mêmes qu’un agent bien outillé suffit souvent. Commencez par un bot, ajoutez-en quand les droits l’exigent.
Pour aller plus loin
- Anthropic, Building effective agents (une note en tête précise que l’outillage a évolué depuis décembre 2024) et How we built our multi-agent research system
- Claude Agent SDK : subagents et skills ; Claude Code : mémoire
- OpenAI Agents SDK : handoffs et orchestration
- LangChain : documentation Multi-agent
- Model Context Protocol
- Neurone21 : le dossier harnais, la fiche mémoire persistante, MemoryTax et la triche à la récompense