Titre original : MemoryTax: The Bitter Lesson of Agent Memory
Auteur : Zedong Peng (seul auteur)
Affiliation : Université Jiao Tong de Shanghai.
Publication : déposé sur arXiv le 21 octobre 2026 (version 1). Une version interactive est annoncée sur le site de l’auteur.
Liens : page arXiv, PDF, code et données sur GitHub (licence MIT).
L’idée en bref
Les « mémoires d’agent » comme Mem0 ou Zep décident à l’avance de ce qu’il faut retenir d’une conversation : elles en extraient des faits ou un graphe, puis ne montrent au modèle que quelques morceaux retrouvés au moment de la question. Les agents de code, eux, gardent l’historique brut et laissent le modèle y chercher avec ses propres outils. L’auteur pose une question inspirée de la « leçon amère » de Richard Sutton (les connaissances codées à la main finissent battues par les méthodes générales qui profitent de la puissance de calcul) : une mémoire conçue d’avance sert-elle encore quand le modèle sait chercher seul ?
Ce que montre le papier
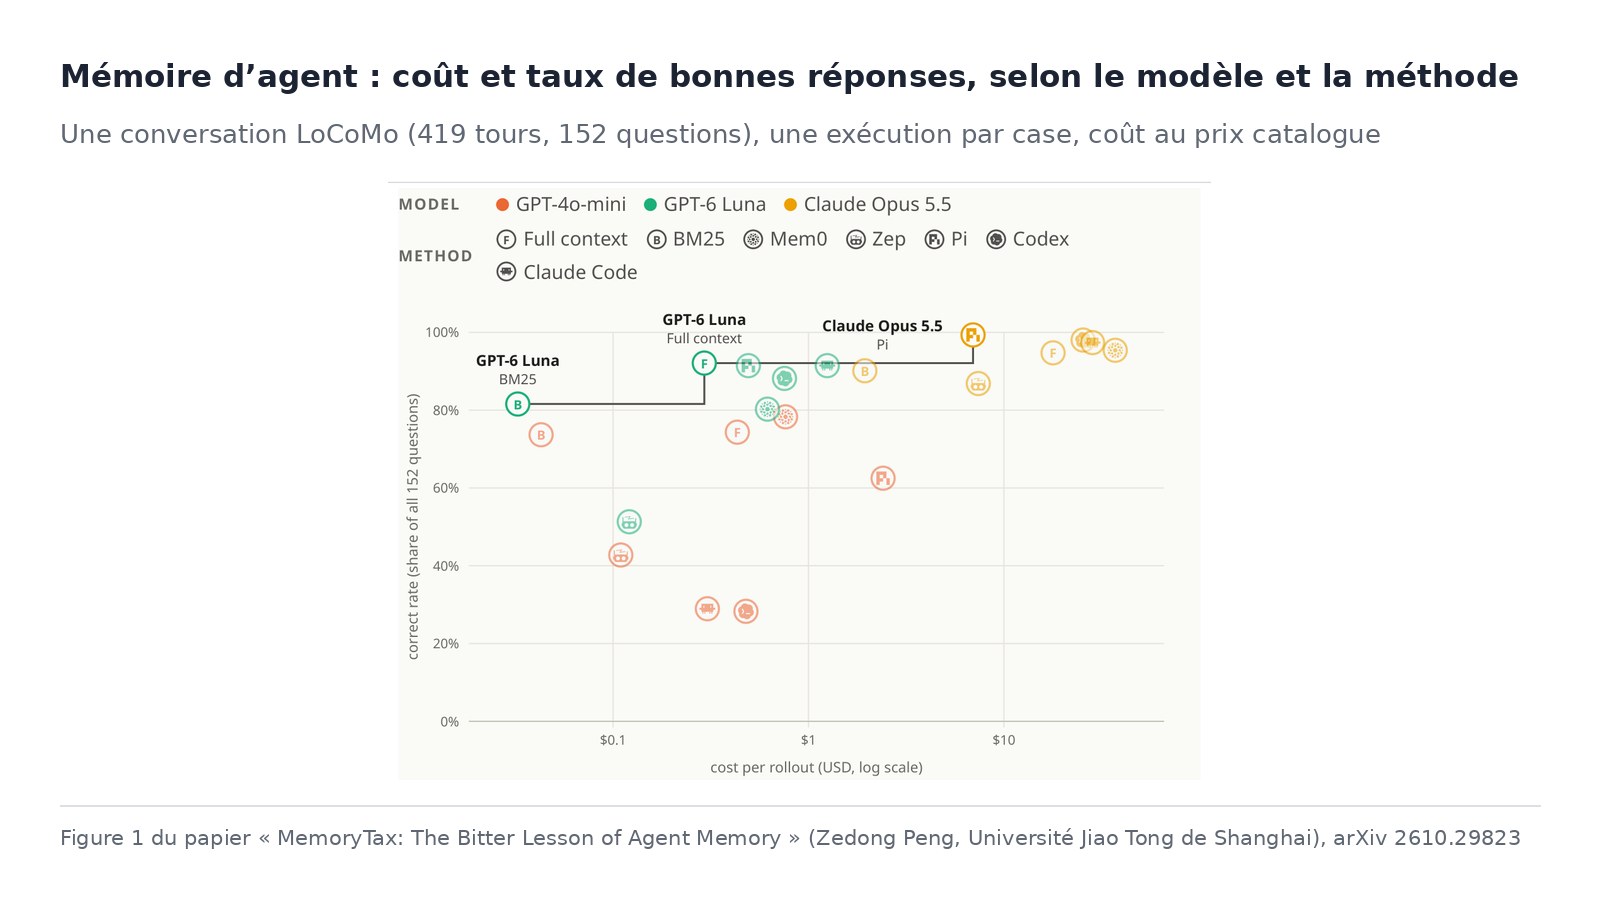
Le banc d’essai. Une conversation du jeu de test LoCoMo (419 tours de parole répartis en 19 sessions, 152 questions). Sept méthodes : contexte complet (tout l’historique dans la requête), BM25 (une recherche par mots-clés classique), Mem0, Zep et trois agents de code, Pi, Codex et Claude Code. Trois modèles, du plus faible au plus fort : GPT-4o-mini, GPT-6 Luna et Claude Opus 5.5. Le coût de chaque exécution est mesuré au prix catalogue.
Une rustine pour modèle faible. Avec GPT-4o-mini, Mem0 obtient le meilleur score (78 %, contre 74 % pour le contexte complet). Avec GPT-6 Luna, le contexte complet passe devant (92 % contre 80 %). Avec Claude Opus 5.5, Mem0 et le contexte complet font jeu égal à 95 %, et les agents passent devant : Pi 99 %, Codex 98 %, Claude Code 97 %.
Une rustine coûteuse. La seule construction de la mémoire Mem0 coûte plus cher qu’une exécution complète en contexte complet avec le même modèle : 25,88 dollars contre 17,84 avec Claude Opus 5.5. Les questions étant ensuite moins chères, l’investissement ne serait amorti qu’après 372 à 596 questions sur le même historique, alors que LoCoMo en pose 152. C’est cette dépense inutile que l’auteur appelle la « taxe mémoire ».
Un plafond fixé par le rédacteur. Un modèle plus fort qui lit une mémoire écrite par un modèle faible ne retrouve pas ce qui a été omis. Sur le graphe Zep écrit par GPT-4o-mini, les trois modèles plafonnent entre 43 % et 45 % ; sur celui écrit par Claude Opus 5.5, ils montent à 66 %, 71 % et 87 %.
Pi en tête du rapport coût et précision. Avec Claude Opus 5.5, Pi atteint 99 % pour 6,95 dollars par exécution, moins de la moitié du coût du contexte complet. Sa seule erreur vient d’un corrigé faux de LoCoMo, que les autres méthodes fortes signalent aussi.
Les limites
L’auteur les énonce lui-même (section 6) :
- Une seule conversation sur dix, une seule exécution par case. Des écarts de quelques questions pourraient ne pas tenir à une deuxième exécution.
- Une notation indulgente, confiée à GPT-4o-mini, avec au moins un corrigé erroné.
- Une asymétrie d’accès aux photos. Les agents lisaient les légendes des photos partagées dans la conversation, pas les méthodes de mémoire. C’est l’essentiel de l’avance de Pi : sur les 88 questions sans photo, Pi et le contexte complet ne diffèrent que d’une réponse. Le papier ne tranche donc pas si chercher dans l’historique répond mieux que tout lire ; il montre seulement que c’est aussi bien pour moins cher.
- Un historique court, qui tient dans la fenêtre de contexte de tous les modèles. Les conclusions peuvent changer quand ce n’est plus le cas.
- Réglages par défaut pour Mem0 et Zep, et prix catalogue qui dépendent de la mise en cache de chaque fournisseur.
Ajoutons que le papier compte onze pages et un seul auteur : c’est une note expérimentale, pas une étude de grande ampleur.
Lecture Neurone21
Pour une entreprise qui ajoute de la mémoire à un assistant ou à un agent, le message est pratique : avant d’installer une brique de mémoire spécialisée, mesurer ce que fait un modèle récent avec de bons outils de recherche sur l’historique brut. Le surcoût de construction n’a de sens que si beaucoup de questions portent sur le même historique, ce que l’auteur reconnaît comme le terrain où une mémoire conçue peut survivre.
Le second message concerne le choix des modèles : une mémoire rédigée par un petit modèle bon marché bride ensuite tous ceux qui la lisent. Économiser sur l’écriture peut coûter cher en qualité. L’expérience est peu coûteuse et le code est public : c’est un test à refaire sur ses propres données avant toute décision d’architecture.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.29823
- Le PDF : https://arxiv.org/pdf/2610.29823
- Le code et les données : https://github.com/zedong-peng/memorytax
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2113272925558305191
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/memorytax-the-bitter-lesson-of-agent-memory-2610.29823