Titre original : Memory Tax: Dissecting the Net Value of Agent Memory
Auteurs : Xuan He, Ruozhen Yang, Zhineng Wang, Ke Yang, Jiawei Han et ChengXiang Zhai (université de l’Illinois à Urbana-Champaign), Sining Zhoubian et Yuhao Wen (université Tsinghua), Yuyang Hu (université Renmin de Chine), Yuyu Zhang (Verdent.ai), Ping Nie (université de Waterloo)
Publication : prépublication arXiv 2610.34073v1 (cs.CL), déposée le 25 octobre 2026, 8 pages de texte principal et 36 pages avec les annexes. Les auteurs annoncent la publication de leur code sur la page du projet.
Liens : page arXiv, PDF, page du projet.
L’idée en bref
Un agent qui travaille longtemps accumule un historique : conversations, actions, résultats d’outils. Pour s’en servir, deux familles de solutions existent. La plus simple découpe l’historique brut en morceaux et va chercher les passages utiles au moment de répondre : c’est le RAG naïf. L’autre construit une vraie mémoire : elle extrait des faits, les résume, les relie en graphe ou entraîne une politique qui décide quoi garder. Ces systèmes coûtent beaucoup plus cher à construire et à entretenir.
Les auteurs posent une question comptable. Par rapport au RAG naïf, qu’est-ce que la mémoire fait gagner, et qu’est-ce qu’elle fait perdre ? Ils appellent « bénéfice de mémoire » les questions que la mémoire réussit et que le RAG rate, et « taxe de mémoire » les questions que le RAG réussit et que la mémoire rate. La valeur nette d’un système, c’est l’écart entre les deux (section 4.1, p. 3 et 4).
Ce que montre le papier
Onze systèmes, trois modèles, trois bancs d’essai
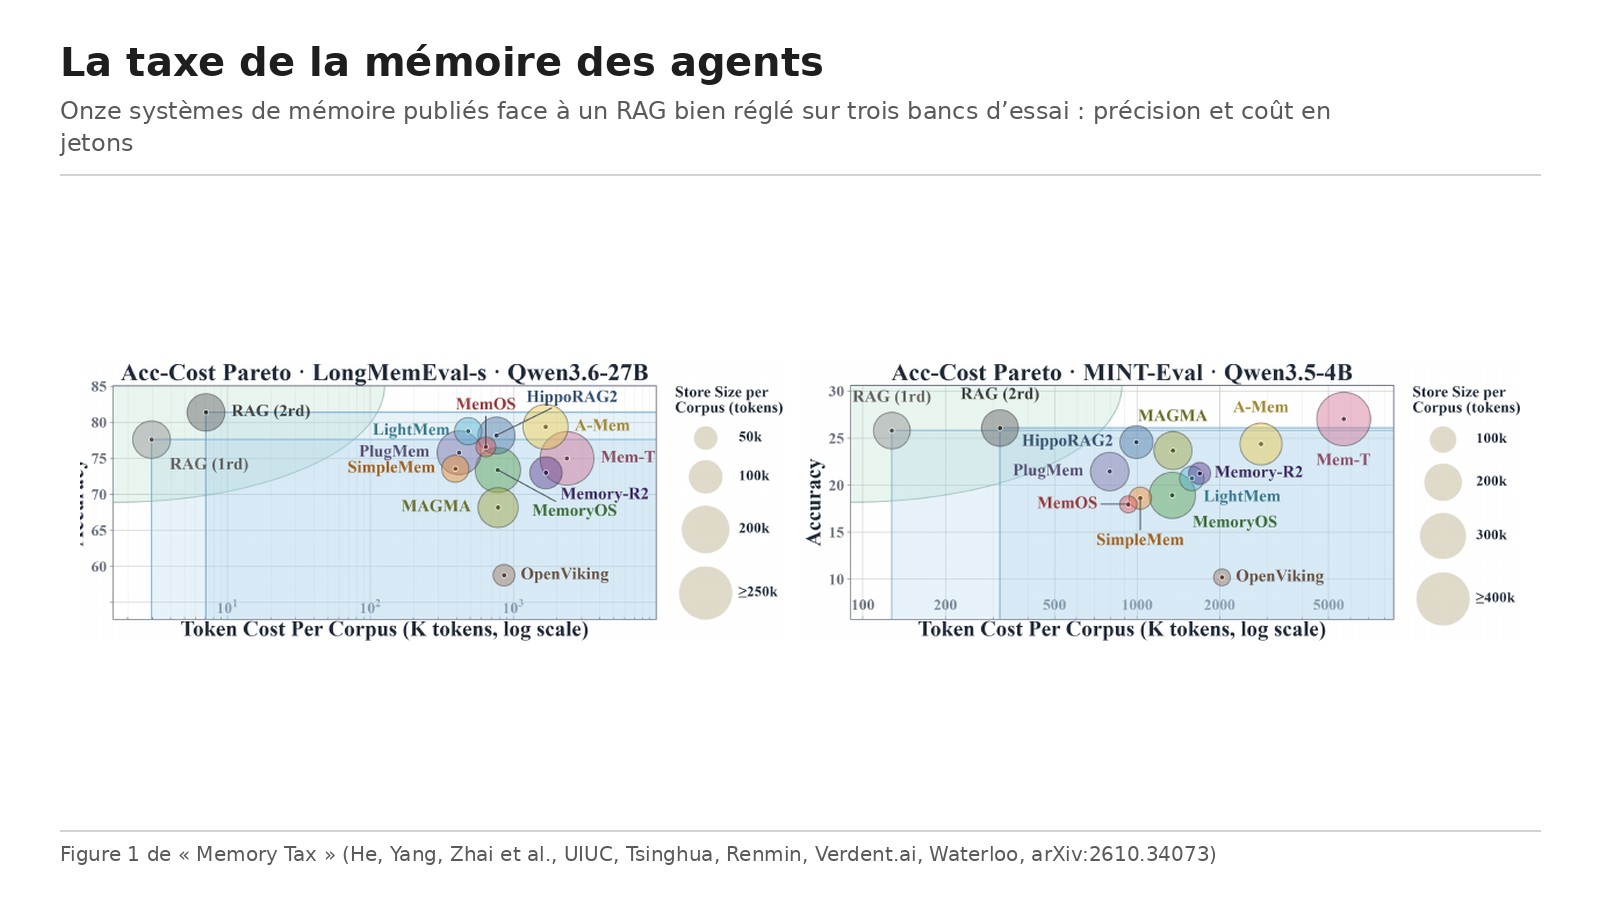
Le banc de comparaison est large : onze systèmes de mémoire publiés (A-Mem, MemOS, SimpleMem, MemoryOS, LightMem, OpenViking, HippoRAG2, MAGMA, PlugMem, Mem-T et Memory-R2), rangés en mémoires à plat, hiérarchiques, en graphe et à politique entraînée. Ils sont opposés à un RAG hybride très simple, qui combine BM25, le modèle d’embeddings Qwen3-Embedding-0.6B et le reclasseur Qwen3-Reranker-0.6B. Trois modèles de réponse sont testés (Qwen3.5-4B, Qwen3.6-27B et GPT-5.6 Luna en effort bas), sur LongMemEval-s (500 questions), un échantillon de PersonaMem-v2 (934 questions) et un échantillon de MINT-Eval (1 557 questions). Un juge Qwen3.6-27B note les réponses, avec 95,1 % à 100 % d’accord avec une annotation humaine (section 3.1 et annexe F).
Le RAG naïf gagne presque partout
Avec deux tours de recherche, le RAG naïf atteint 72,2 %, 81,4 % et 90,0 % sur LongMemEval selon le modèle. Aucun des onze systèmes ne le dépasse sur ce banc, quel que soit le modèle. Sur les 99 cases du tableau principal (onze systèmes, trois bancs, trois modèles), seules 9 sont au-dessus du RAG, et de peu : 2,0 points au mieux pour Memory-R2 sur PersonaMem avec le petit modèle, 3,9 points pour Mem-T sur MINT-Eval. À l’autre extrême, OpenViking tombe à 31,8 % sur LongMemEval avec Qwen3.5-4B, soit 40,4 points sous le RAG (tableau 1, p. 3).
Une mémoire qui coûte des ordres de grandeur de plus
Sur LongMemEval avec GPT-5.6 Luna, le RAG en un tour consomme 0,27 million de jetons, se construit en 0,11 heure et fait une centaine d’appels au modèle. A-Mem demande 29,3 millions de jetons de construction et 145,0 millions de maintenance, 117 heures de construction et 98 400 appels, pour 84,0 % de bonnes réponses contre 90,0 % au RAG en deux tours (tableau 19 de l’annexe et tableau 1).
D’où vient la taxe
Les auteurs suivent des faits précis de l’historique jusqu’à la mémoire construite. Chez OpenViking, 38,0 % des faits échantillonnés n’ont plus aucune unité de mémoire correspondante et seuls 39,4 % passent sans perte. MemoryOS conserve 98,4 % des faits sans perte, SimpleMem seulement 65,6 % (tableau 2, p. 4). Même quand l’information survit, elle devient plus difficile à retrouver : elle est éclatée entre plusieurs unités, diluée ou reformulée, et il faut plus de tours de recherche pour la récupérer (section 4.3 et figures 4 et 5). Enfin, changer le modèle qui lit la mémoire fait chuter les scores plus fort que pour le RAG : sur PersonaMem, le RAG perd 9,6 points avec un modèle plus faible, SimpleMem entre 10,6 et 12,2 points (section 4.4 et figure 6, p. 5).
Une correction simple
Remettre l’historique brut dans la recherche, à côté de la mémoire, puis reclasser les deux ensemble, réduit nettement la taxe. Avec Qwen3.6-27B, SimpleMem passe de 73,6 % à 82,8 % sur LongMemEval et sa taxe de 12,0 à 5,2 points ; MemoryOS passe de 48,2 % à 53,0 % sur PersonaMem, avec une taxe divisée par deux (17,1 à 8,5) ; Mem-T passe de 75,0 % à 80,0 % sur LongMemEval (tableau 4, p. 6). Une recherche récursive dans la mémoire apporte peu.
Des bancs d’essai trop favorables à la simple recherche
Sur une douzaine de bancs de mémoire longue, une recherche par mots-clés rares dépasse parfois 50 % de bonnes réponses et le RAG hybride atteint autour de 70 % (figure 7, p. 5). Pour les auteurs, une partie des bancs d’essai actuels laisse peu de marge à une mémoire élaborée, ce qui rend la taxe plus visible. Le papier étend l’analyse à la mémoire d’expérience (la distillation d’expériences web peut battre le RAG, pas sur l’usage d’outils) et aux modèles du monde, où réinjecter les images passées reste le choix le plus solide (sections 5.1 et 5.2, p. 6).
Les limites
Les auteurs reconnaissent que (section Limitations, p. 8) :
- les onze systèmes sont représentatifs mais pas exhaustifs, et chacun est utilisé avec sa configuration officielle, qu’un réglage spécifique pourrait améliorer ;
- les bancs d’essai sont statiques, hors ligne et en anglais, et deux d’entre eux sont des échantillons (20 % de PersonaMem-v2, 10 % de MINT-Eval) ;
- aucun modèle plus puissant que GPT-5.6 Luna n’est testé, pour des raisons de coût de calcul et d’API ;
- les mémoires multimodales, latentes ou intégrées aux paramètres du modèle restent à étudier.
Réserves de notre lecture, tirées du papier :
- La référence est forte. Le RAG retenu combine recherche lexicale, embeddings et reclassement, et les auteurs ont aussi relevé le nombre de passages récupérés par les systèmes de mémoire pour rendre la comparaison équitable (annexe B.3). C’est honnête, mais le résultat dit surtout « un bon RAG bat ces mémoires », pas « tout RAG ».
- La taxe est définie par rapport à ce RAG précis : changer de référence change les chiffres.
- Le juge est un modèle Qwen3.6-27B, qui sert aussi de modèle de réponse dans une partie des tests.
- Les gains de mémoire existent bien sur PersonaMem et MINT-Eval, où l’on infère des préférences ou traite des contenus variés : la conclusion vaut surtout pour la recherche de faits dans un long historique.
Lecture Neurone21
C’est le troisième papier en une semaine qui arrive à la même conclusion. Après le MemoryTax de Zedong Peng, qui porte presque le même nom mais vient d’un autre auteur, et le RAG brut face à la mémoire agentique, cette équipe de l’UIUC apporte la comparaison la plus large et surtout un vocabulaire utile : bénéfice et taxe. Pour une entreprise qui construit un assistant interne avec un historique long (tickets de support, échanges avec un client, journal d’un agent de code), la question à poser n’est pas « quelle mémoire choisir ? » mais « que perdons-nous par rapport à une simple recherche dans l’historique ? ».
En pratique, la méthode se transpose facilement. On prend une centaine de questions réelles, on fait répondre le système avec mémoire et un RAG simple sur le même historique, puis on compte les questions gagnées et perdues de chaque côté. Si la mémoire ne gagne que sur des préférences ou des résumés, une solution hybride, avec l’historique brut toujours consultable, est probablement le bon compromis. C’est aussi une bonne nouvelle pour l’IA locale : un RAG hybride avec des modèles de 0,6 milliard de paramètres tourne sur une machine modeste, alors que certaines mémoires demandent des centaines de millions de jetons de construction.
Le post d’Elvis Saravia résume fidèlement le papier : systèmes de mémoire sous le RAG naïf, coût plus élevé, distinction bénéfice et taxe, pertes à l’extraction, fragilité face au changement de modèle et correction par l’historique brut. Il simplifie en écrivant que les systèmes de mémoire sont sous le RAG sur les trois bancs : c’est vrai sans exception sur LongMemEval, mais quelques systèmes le dépassent légèrement sur PersonaMem et MINT-Eval (9 cases sur 99). Le post ne donne aucun chiffre.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.34073
- Le PDF : https://arxiv.org/pdf/2610.34073v1
- La page du projet : https://hexuan21.github.io/MemoryTax/
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2115098954799169970
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/memory-tax-dissecting-the-net-value-of-agent-memory-2610.34073