Titre original : Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought
Auteurs : Zhengye Bao, Shengtao Zhang, Haokai Zhang, Shiqi Lou, Muning Wen, Minnan Luo
Affiliations : Université Jiao Tong de Xi’an (laboratoire Luo, division des étudiants de premier cycle), université Jiao Tong de Shanghai, université du Zhejiang, université chinoise de Hong Kong.
Publication : déposé sur arXiv le 22 octobre 2026 (version 1, catégorie cs.AI), 62 pages avec les annexes.
Liens : page arXiv, PDF, code sur GitHub (licence MIT).
L’idée en bref
Les systèmes de « mémoire d’agent » (Mem0, MemOS, Memora, EverMemOS…) transforment l’historique des conversations : extraction de faits, résumés, graphes, mises à jour ou suppressions d’entrées, recherche pilotée par un modèle. Les auteurs demandent si cette complexité est toujours nécessaire. Leur base de référence, Raw-RAG, ne transforme rien : elle découpe l’historique brut en fenêtres de 256 tokens (32 de chevauchement), retrouve les 128 plus proches de la question par recherche dense, en garde 15 après un reranking par un modèle dédié, puis les donne à un modèle lecteur (section 3, p. 4). « RAG is so back ! » est la formule d’Elvis Saravia, pas celle du papier, qui conclut plus prudemment pour « les tâches de conversation évaluées ».
Ce que montre le papier
Quatre bancs d’essai. LoCoMo (10 conversations, 1 540 questions), LongMemEval (500 exemples), MEME (100 épisodes, 1 188 questions sur les mises à jour et les dépendances) et MemoryAgentBench (2 071 questions, 14 sources), face à jusqu’à douze systèmes de mémoire et à un « contexte complet » (section 4.1, p. 5).
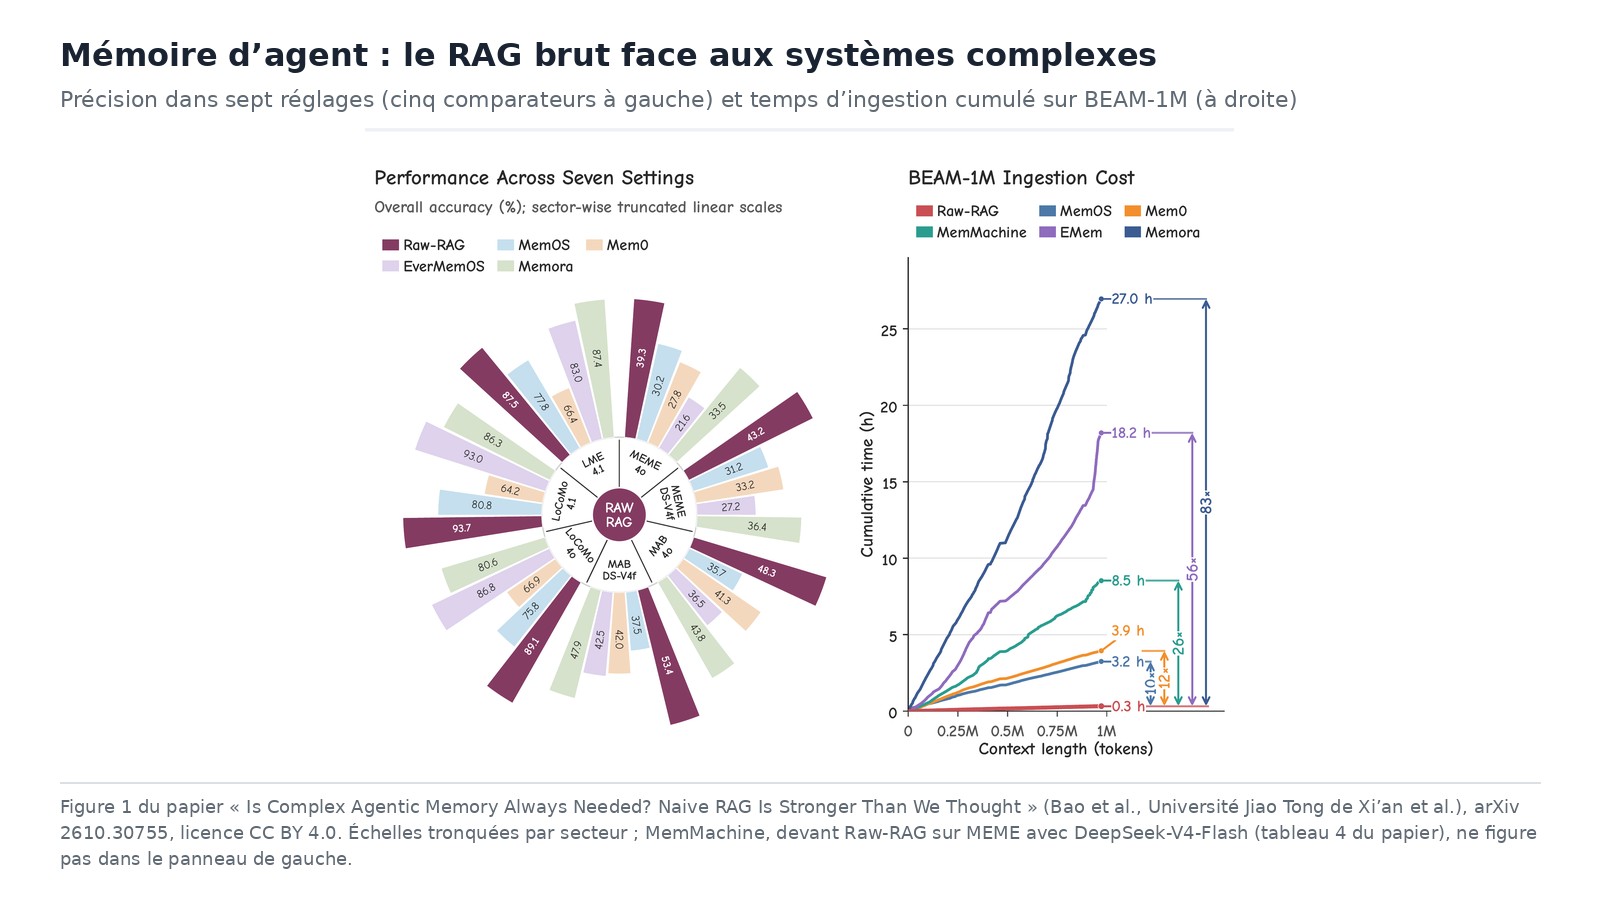
Première place dans six réglages sur sept. Scores de précision, en points, tableaux 3 et 4 (p. 5 et 6) :
| Banc d’essai | Lecteur | Raw-RAG | Meilleur système de mémoire | Écart |
|---|---|---|---|---|
| LoCoMo | GPT-4o-mini | 89,07 | MemMachine 88,12 | +0,95 |
| LoCoMo | GPT-4.1-mini | 93,70 | EverMemOS 93,05 | +0,65 |
| LongMemEval | GPT-4.1-mini | 87,53 | Memora 87,40 | +0,13 |
| MEME | GPT-4o-mini | 39,30 | MemMachine 37,06 | +2,24 |
| MEME | DeepSeek-V4-Flash | 43,19 | MemMachine 44,71 | -1,52 |
| MemoryAgentBench | GPT-4o-mini | 48,32 | Memora 43,84 | +4,48 |
| MemoryAgentBench | DeepSeek-V4-Flash | 53,41 | Memora 47,88 | +5,53 |
Sur MEME avec DeepSeek-V4-Flash, MemMachine reste devant, et le contexte complet (tout l’historique donné au modèle) fait 63,17, soit 19,98 points de plus que Raw-RAG.
La mise à jour d’entrées n’aide pas ici. Sur Mem0, les mises à jour et suppressions ne représentent que 4,39 % des 33 902 décisions d’écriture sur LoCoMo et 2,46 % des 428 858 sur LongMemEval ; celles qui modifient vraiment le texte, 1,90 % et 1,34 %. En les remplaçant par de simples ajouts, la précision sur LoCoMo passe de 67,36 % à 69,42 % (p. 2 et 3). Quand on donne à DeepSeek-V4-Flash toute la preuve brute de MEME, il réussit 82,32 % des questions en cascade, mais GPT-4o-mini seulement 1,83 % : la reconstruction de l’état dépend du lecteur (tableau 2, p. 3).
Ajouter de la mémoire à Raw-RAG ne l’améliore pas. Sur MemoryAgentBench (48,32 %), l’extraction de faits atomiques tombe à 28,70 %, les résumés ajoutés à 42,51 % et l’expansion par graphe à 42,54 %. Sans reranking, 44,40 % ; la taille des fenêtres (128 à 1 024 tokens) ne change pas le total de façon significative (tableau 5, p. 7).
Un coût d’ingestion sans commune mesure. Sur une conversation de 1 710 messages approchant un million de tokens (BEAM-1M), l’ajout cumulé prend 0,33 heure pour Raw-RAG, 3,25 pour MemOS et 26,95 pour Memora. D’après la figure 1, Mem0 en demande 3,9, MemMachine 8,5 et EMem 18,2 (p. 1 et 7). Sur 10 épisodes MEME, Raw-RAG termine ingestion et recherche en 305,91 secondes, contre 1 561,97 pour EMem (5,1 fois plus lent) et 9 301,48 pour EverMemOS (tableau 6, p. 7).
Pourquoi. Raw-RAG retrouve plus souvent une preuve suffisante : 45,29 % des questions sur MemoryAgentBench (les autres, de 19,07 % à 40,03 %) et 76,35 % sur MEME ; en revanche, le lecteur exploite un peu moins bien cette preuve que chez les meilleurs (tableaux 7 et 8, p. 8). Sur les questions de suivi d’état de MEME, 62,34 % des preuves trouvées contiennent aussi le chemin de dépendance complet, contre 9,62 % à 56,70 % pour les autres (tableau 9, p. 9). Enfin, sur MEME avec GPT-4o-mini, un test « oracle » donne à chaque système l’accès complet à sa mémoire, avec une sélection guidée par les annotations de référence : MemMachine et Raw-RAG, qui gardent du texte brut, montent à 57,46 % et 57,54 %, contre 61,60 % pour la preuve brute d’origine ; les autres restent plus bas, et sans plafond de contexte les sept systèmes sont de 7,58 à 29,38 points sous la preuve brute (section 5.3, p. 9).
Les limites
Les auteurs écrivent que leurs preuves se limitent à des conversations enregistrées sur des bancs publics et ne disent rien des usages interactifs, multimodaux ou opérationnels (section 6.1, p. 10 ; annexe F, p. 49). Ils ajoutent que :
- garder l’historique brut pose des questions de stockage et de vie privée, et les évaluations futures devraient intégrer des contraintes explicites de confidentialité et de suppression ;
- une mémoire opérationnelle peut devoir exposer un état faisant autorité, déclencher des actions ou effacer des données, des objectifs que la précision de réponse ne mesure pas ;
- un budget de preuve fixe peut manquer des indices dispersés, et les modèles hébergés varient d’un appel à l’autre, même à température zéro ;
- la reconstruction d’un état dépend fortement du lecteur ; savoir si construire cet état à l’ingestion aide des lecteurs plus faibles reste une question ouverte.
Réserves de notre lecture, toutes tirées du papier :
- Les écarts de LoCoMo et de LongMemEval sont minces (0,13 à 0,95 point) et les tableaux 3 et 4 ne donnent pas d’intervalle de confiance. Plusieurs scores de concurrents sont des scores publiés, obtenus dans leurs propres environnements (annexes A, p. 16, et D.7, p. 46).
- Raw-RAG n’est pas toujours devant : sur PersonaMem-v2, il est troisième sur sept avec 49,62 %, derrière MemOS (50,72) et EverMemOS (53,25), qui utilisent des profils de personnes ; la significativité n’est pas testée (annexe A.3, p. 22). Ce résultat n’apparaît pas dans le résumé.
- Il consomme du contexte : de 3 916 à 11 986 tokens de preuve en moyenne selon le banc (tableau 20, p. 23). Plafonné à 5 000 tokens, il garde l’avantage : 48,32 % contre 44,74 % pour le meilleur concurrent sur MemoryAgentBench, et sur les trois autres bancs des scores toujours au-dessus des scores d’origine des concurrents. Mais ceux-ci n’ont pas été rejoués sous ce plafond sur LoCoMo, LongMemEval et MEME (annexe A.4, p. 24 et 25).
- La chute à 28,70 % avec extraction de faits atomiques tient en partie, selon les auteurs, à la perte du format des exemples en apprentissage en contexte (annexe F, p. 49), pas seulement à l’information perdue.
- Dans plusieurs RAG de référence de 14 travaux antérieurs, les auteurs relèvent des fenêtres trop grosses, une profondeur trop faible ou pas de reranking, ce qui peut expliquer en partie leurs mauvais scores : c’est leur lecture, non une mesure contrôlée (annexe E, p. 46 et 47).
- Les temps ont été mesurés sur une seule machine locale, avec les règles de disponibilité et le parallélisme propres à chaque système (annexes D.6 et D.7, p. 45 et 46).
- Le papier ne dit pas que les systèmes agentiques sont inutiles : il demande qu’ils montrent un gain sur un RAG naïf bien réglé.
Lecture Neurone21
Pour qui construit un agent avec mémoire longue, la conclusion pratique est nette : avant d’ajouter une couche de mémoire, mesurer cette base de référence sur ses propres conversations. Elle se monte vite, n’appelle aucun modèle de langage à l’ingestion, et le papier montre qu’un reranker compte plus que la taille des fenêtres. Une couche de mémoire qui ne la bat pas ajoute du coût et des occasions de perdre de l’information.
La leçon est plus fine que « le RAG revient ». Dans le test oracle sur MEME, les deux systèmes qui récupèrent le plus, Raw-RAG et MemMachine, sont ceux qui conservent le texte d’origine. Ce que le papier invite à éviter, c’est de réécrire l’information à l’écriture quand on peut la chercher à la lecture, pas de proscrire toute structure. Et rien n’est prouvé pour une mémoire qui doit servir d’état de référence, déclencher des actions ou oublier sur demande : ce sont des besoins réels en entreprise, hors du périmètre testé.
Le résultat va dans le sens de nos fiches précédentes : MemoryTax trouvait déjà qu’une recherche dans l’historique brut suffisait avec un modèle fort ; la fiche sur la mémoire persistante multi-agents mesurait un coût sans gain de précision détectable ; celle sur les agents auto-évolutifs et l’oubli montrait que ceux qui réécrivent leurs consignes ou leur mémoire dégradent ce qu’ils savaient déjà. Pour la mise en pratique, voir le dossier sur le harnais d’agent et celui sur la mémoire d’une équipe de bots. Dans son second post, Elvis estime que le RAG n’était jamais mort et qu’il faudra le réexaminer pour des agents persistants à grande échelle : c’est son opinion, le papier ne teste ni multi-agents ni grande échelle.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.30755
- Le PDF : https://arxiv.org/pdf/2610.30755
- Le code des auteurs : https://github.com/Litmeb/RAW-RAG
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2113635562578178147
- La suite de son fil : https://x.com/omarsar0/status/2113683289500238254
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/is-complex-agentic-memory-always-needed-naive-rag-is-stronger-than-we-thought-2610.30755