Titre original : Are Self-Evolving Agents Continual Learners?
Auteurs : Xiaoyin Chen, Yizheng Huang, Yinglun Xu, Ziyun Zhao, Emmett McQuinn, Julie Liu, Hope Yao
Affiliations : Mila (Institut québécois d’intelligence artificielle), Université de Montréal, Google DeepMind. Le premier auteur a mené ce travail comme chercheur étudiant chez Google DeepMind.
Publication : déposé sur arXiv le 19 octobre 2026 (version 1), 24 pages.
Liens : page arXiv, PDF. Aucun code n’est indiqué dans le papier.
L’idée en bref
Un agent déployé voit sans cesse arriver de nouvelles tâches, de nouveaux outils, de nouvelles façons de travailler. Il devrait apprendre au fil de l’eau sans oublier ce qu’il sait déjà : c’est le problème classique de l’« apprentissage continu ». Réentraîner le modèle après chaque session coûte trop cher. Les agents dits « auto-évolutifs » contournent l’obstacle : les poids restent figés, et l’agent réécrit son harnais, c’est-à-dire ses consignes système, sa mémoire, ses fiches de compétences, voire son code de pilotage, à partir du résultat de ses tâches.
Ces méthodes brillent sur des tests où les tâches ne changent pas. Les auteurs posent la question qui fâche : tiennent-elles quand le flux de tâches dérive ?
Ce que montre le papier
Le protocole. Quatre flux de tâches construits à partir de trois tests connus : BIRD (requêtes SQL), BFCL (appels de fonctions) et ScienceWorld (expériences scientifiques simulées). Chaque flux enchaîne des blocs de 50 tâches et isole un type de changement : de sujet, de façon de travailler, de domaine, ou les trois successivement. Le modèle est toujours Gemini 3.6 Flash. Trois méthodes représentatives sont comparées : ReasoningBank, qui stocke un souvenir par épisode et retrouve le plus proche ; GEPA, qui réécrit une section de stratégie dans les consignes système ; Meta-Harness, qui modifie consignes, mémoire, compétences et code, et ne garde une modification que si elle améliore un score de validation.
Des gains modestes. L’auto-évolution améliore le score global sur la plupart des flux. En moyenne sur les quatre flux, l’avantage final sur l’agent de départ est de +3,7 points pour GEPA, +2,5 pour ReasoningBank et +1,4 pour Meta-Harness. Sur le flux qui change de sujet, le bilan est nul ou légèrement négatif.
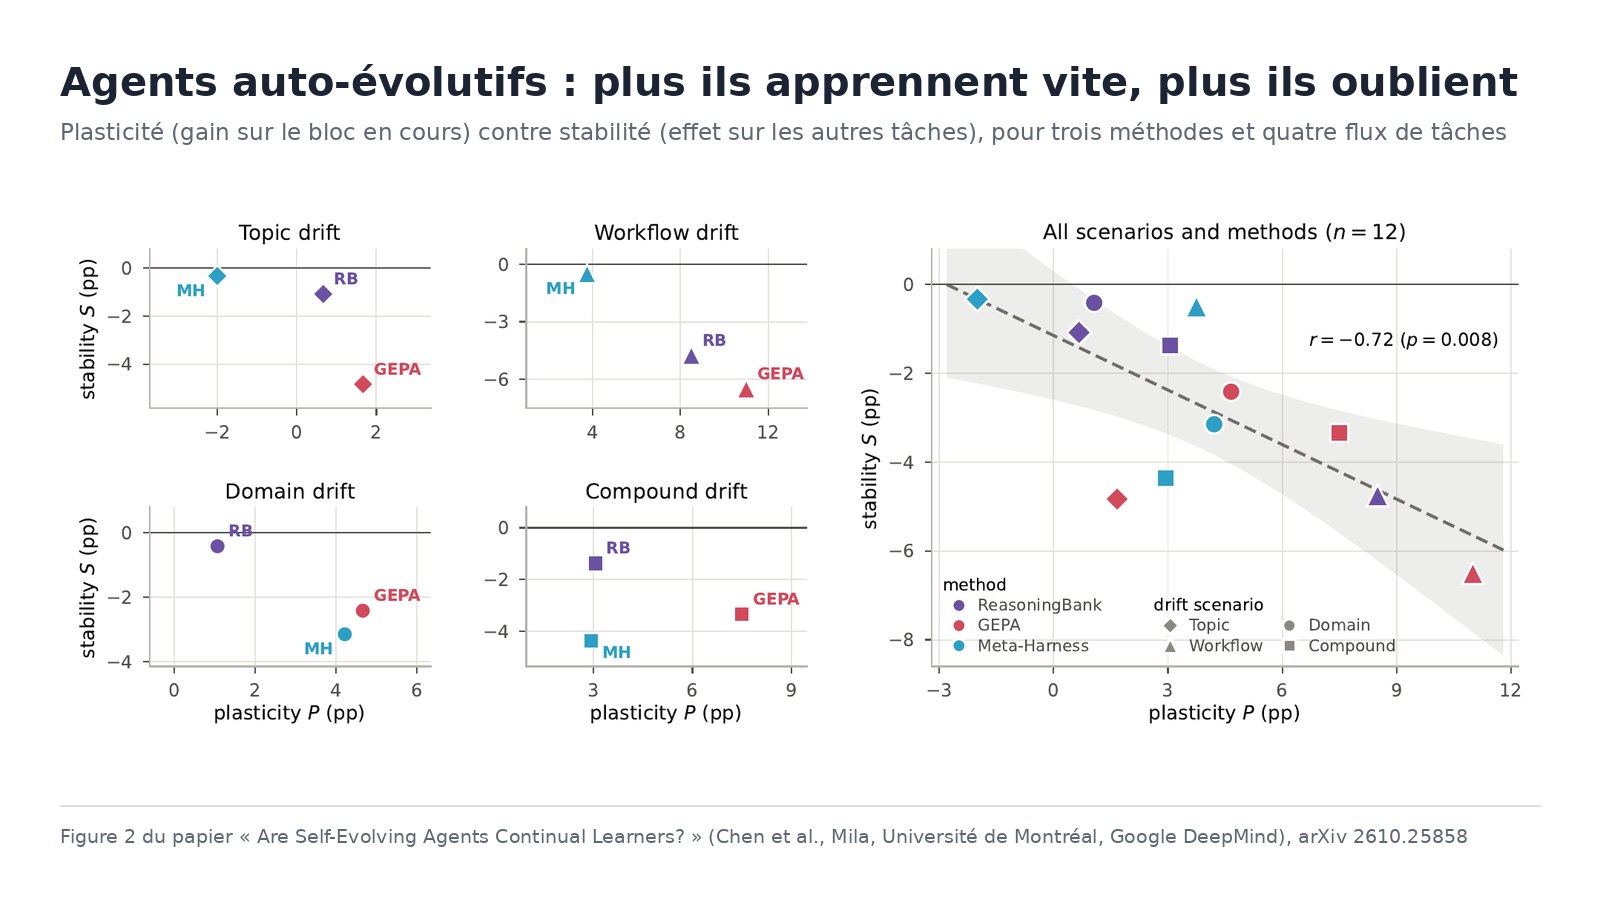
Apprendre vite, c’est oublier. Les auteurs séparent la « plasticité », le gain sur le bloc en cours d’apprentissage, de la « stabilité », l’effet sur les autres tâches. Les deux sont nettement corrélées en sens inverse (coefficient de −0,72). GEPA apprend le plus vite (+6,2 points en moyenne) mais dégrade le plus le reste (−4,3). ReasoningBank est le plus stable (−1,9) pour une plasticité moitié moindre (+3,3).
Deux mécanismes d’échec. Les méthodes qui réécrivent une consigne partagée appliquent partout des règles apprises sur un bloc : elles perturbent des tâches pas encore vues et écrasent les anciennes règles quand le flux change. Exemple frappant : après avoir appris à demander les arguments manquants avant d’appeler une fonction, GEPA réécrit sa consigne au bloc suivant, où ces demandes sont pénalisées. Son taux de demande retombe de 29,8 % à 11,2 % et sa précision perd 13 points. La mémoire par similarité limite les dégâts entre domaines éloignés. Mais elle injecte des souvenirs d’autres domaines avant qu’un groupe ne soit appris, et confond des requêtes proches qui exigent des façons de faire opposées : en fin de flux, 52 % des épisodes d’un groupe récupèrent un souvenir de l’autre.
Les limites
- Un seul modèle, Gemini 3.6 Flash ; d’autres modèles pourraient se comporter autrement.
- Des flux courts, de 100 à 200 tâches, loin d’un déploiement réel de plusieurs mois.
- Trois méthodes seulement, chacune avec un réglage ; une variante mieux conçue pourrait réduire l’oubli.
- Des écarts de quelques points, dont la robustesse statistique n’est pas discutée en détail dans le corps du texte.
- Pas de section dédiée aux limites ni de code publié.
Lecture Neurone21
C’est un contrepoint utile à l’enthousiasme pour les agents qui « s’améliorent tout seuls ». Pour une entreprise, le risque est concret : un agent qui réécrit ses propres consignes à partir de cas récents peut perdre en silence des comportements qui fonctionnaient. Les auteurs le montrent : un test figé ne voit pas ce problème.
La recommandation pratique découle du protocole : évaluer un agent auto-évolutif sur un flux de tâches qui change, en mesurant à la fois ce qu’il gagne et ce qu’il perd, et versionner ses consignes et sa mémoire pour pouvoir revenir en arrière.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.25858
- Le PDF : https://arxiv.org/pdf/2610.25858
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2112728082042015769
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/are-self-evolving-agents-continual-learners-2610.25858