Titre original : Do LLM Agents Still Need to Be Told How to Self-Improve?
Auteurs : Shobhita Sundaram (première autrice), Cansu Sancaktar et Phillip Isola.
Affiliations : MIT CSAIL (Shobhita Sundaram, Phillip Isola) et université de Tübingen (Cansu Sancaktar).
Publication : prépublication déposée sur arXiv le 17 novembre 2026 (2611.23219v1, 54 pages avec annexes). Une page de projet accompagne le papier ; il n’annonce pas de publication du code.
Liens : page arXiv, PDF, page du projet.
L’idée en bref
Les méthodes d’auto-amélioration des modèles (auto-jeu, optimisation de prompts, agents qui réécrivent leur harnais) ont un point commun : un humain décide de la boucle. Il fixe quelles tâches générer, comment noter, quand mettre à jour. Les auteurs posent une question simple : un modèle assez capable a-t-il encore besoin qu’on lui dise comment s’améliorer ?
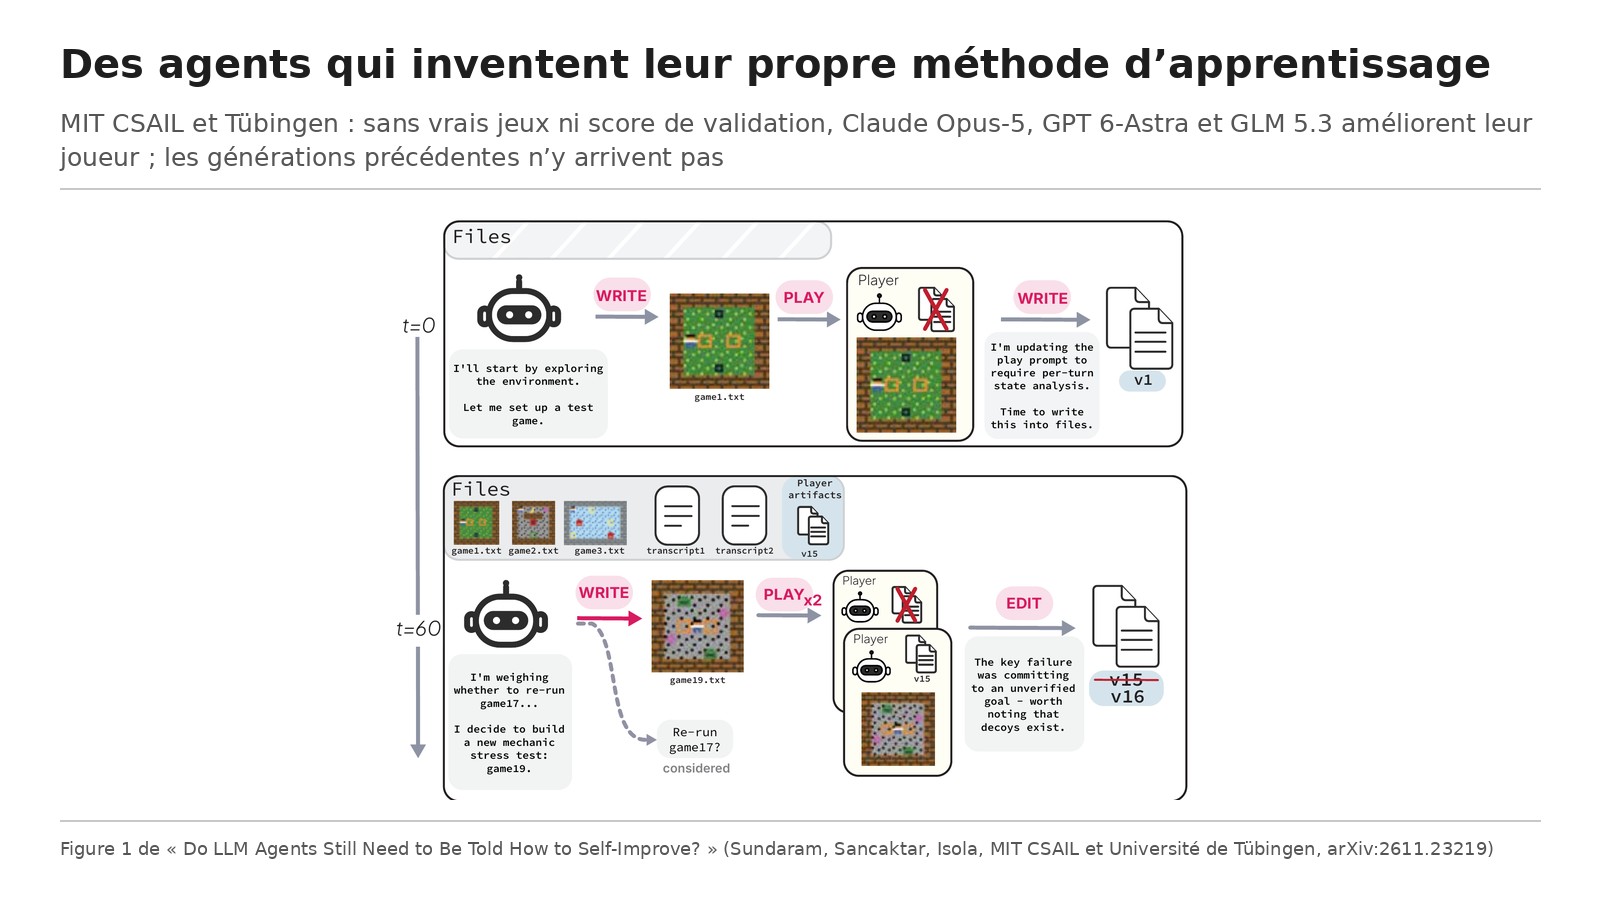
Pour le tester, ils placent un modèle figé, le « professeur », dans un bac à sable. Il dispose d’outils de lecture et d’écriture de fichiers, d’un terminal et d’un outil « Gameplay » qui fait jouer un « joueur », une autre instance du même modèle, à un jeu que le professeur a lui-même écrit. Son objectif : rédiger des textes (prompt, fichiers de compétences) qui rendent le joueur meilleur sur des jeux inconnus aux règles cachées. Il ne voit aucun vrai jeu, aucun score de validation, et personne ne lui dit comment s’y prendre.
Ce que montre le papier
Le cadre de l’expérience
Le banc d’essai est PuzzleScript, un langage de petits jeux de réflexion en 2D sur grille. Le professeur a 20 mises à jour des fichiers du joueur et 150 parties à observer. Chaque partie est limitée à 20 tours et 25 000 tokens de sortie. Six modèles de trois familles sont testés, avec trois sessions indépendantes chacun et un effort de raisonnement faible : Claude Opus-4.6 et Opus-5, GPT 5.6-Sol et GPT 6-Astra, GLM-4.7 et GLM-5.3. Les textes produits sont ensuite évalués sur des jeux écrits par des humains, que le professeur n’a jamais vus.
Les générations récentes progressent, les anciennes non
Sur PuzzleScript-t20 (20 niveaux courts), les trois modèles les plus récents améliorent leur joueur par rapport au prompt par défaut : +20 % pour Claude Opus-5, +10 % pour GPT 6-Astra, +6 % pour GLM 5.3. Les générations précédentes progressent peu ou pas. Pour Claude Opus-5, l’auto-apprentissage sur des jeux qu’il a inventés atteint un niveau comparable à GEPA, une méthode d’optimisation de prompt classique qui, elle, s’entraîne sur 20 vrais jeux, à budget de parties égal.
Des stratégies que l’on reconnaît
Sans qu’on le leur demande, les modèles efficaces adoptent des réflexes de méthode. Ils jouent le même jeu avec et sans leurs notes pour mesurer l’effet (test A/B), écrivent moins de jeux trop faciles, construisent des séries de validation et rejouent surtout les jeux de difficulté moyenne : chez Claude Opus-5 et GLM 5.3, la plupart des reprises portent sur des jeux gagnés entre 20 et 60 % du temps. Une session de Claude Opus-5 écrit ainsi un générateur aléatoire de niveaux et un solveur pour filtrer les niveaux par difficulté, puis conçoit un jeu piège pour vérifier qu’un de ses conseils (« ne jamais rester immobile ») ne nuit pas quand attendre est la bonne réponse. Un juge (GPT 6-Astra) note aussi les sessions selon les 13 sous-processus du modèle d’apprentissage autorégulé de Zimmerman, un cadre classique de psychologie de l’éducation : les modèles qui progressent obtiennent de meilleurs scores.
Ce qui est appris se transpose
Les fichiers écrits par Claude Opus-5 dans le cadre principal améliorent aussi le joueur sur des parties plus longues (+9 % sur PuzzleScript-t30, 30 tours), sur un autre moteur de jeu (+21 % sur le niveau 1 des jeux d’ARC-AGI-3) et en navigation 3D en ASCII (+0,15 de SPL, un score de réussite pondéré par la longueur du trajet, sur MazeBench). Ils passent aussi d’un modèle à l’autre : Claude Opus-5 monte de 25,4 % à 47,5 % de victoires avec les fichiers écrits par GPT 6-Astra, et GPT 6-Astra de 67,1 % à 72,1 % avec ceux d’Opus-5.
Ce que l’on dit au professeur oriente ce qu’il apprend
Avec seulement les outils de fichiers, le professeur progresse déjà en réfléchissant à ce qu’il sait, mais récupère moins de la moitié du gain obtenu avec l’outil de jeu sur trois bancs sur quatre. Avec un terminal mais sans outil de jeu, une session d’Opus-5 se met d’elle-même à écrire et lancer des simulations de jeu pour tester ses conseils. En revanche, plus on donne d’informations sur le cadre d’évaluation (description des jeux, limites de tours et de tokens identiques au test), plus le professeur se spécialise : le score monte sur les jeux proches du test et baisse ou plafonne ailleurs.
Les limites
Les auteurs signalent que leurs mesures ne prouvent pas que les stratégies d’apprentissage observées causent les progrès : elles les accompagnent. Les jeux sont un domaine où les modèles ont lu beaucoup de travaux sur les programmes d’entraînement, et l’on ignore si les résultats tiennent dans des domaines où ils ont moins de connaissances préalables. Les gains finissent par plafonner : un budget de mises à jour et de parties plus large aide, mais le plateau demeure, ce qui peut refléter une limite des modèles ou de l’apprentissage par le seul contexte.
Nos réserves : trois sessions par modèle seulement, un effort de raisonnement faible partout, et des bancs d’évaluation filtrés pour retirer les niveaux que Claude Opus-5 réussit à chaque fois, ce qui laisse de la marge à mesurer mais favorise un cadrage pensé autour de ce modèle. Le texte du papier exprime les gains en « % » sans toujours préciser s’il s’agit de points de taux de victoire. Enfin, l’apprentissage porte sur des textes (prompts et notes), pas sur les poids du modèle.
Lecture Neurone21
Le résultat a deux faces. Côté usage, il confirme qu’un modèle récent peut construire seul une démarche de test et d’amélioration de ses propres consignes, avec des outils très ordinaires : écrire des fichiers, lancer des essais, comparer. Pour une équipe, cela veut dire qu’un agent bien outillé peut faire une partie du travail de mise au point de ses prompts, à condition de surveiller qu’il ne se spécialise pas sur le cadre de test qu’on lui a décrit. Côté sécurité, les auteurs le disent nettement : ne pas programmer de boucle d’auto-amélioration n’empêche pas un modèle capable de s’améliorer s’il en a les outils. C’est une donnée à intégrer quand on donne à un agent l’accès à un terminal et à ses propres fichiers de configuration.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.23219v1. Points à préciser :
Le modèle reste figé et ne voit ni tâche réelle ni score de validation : c’est conforme au papier. Il faut ajouter que seules les trois générations récentes progressent (Claude Opus-5, GPT 6-Astra, GLM 5.3), pas « les modèles capables » en général, et que l’effet sur la sécurité est une conséquence que les auteurs tirent de l’expérience, pas un test de sécurité en soi. Le transfert vers d’autres bancs est mesuré avec les fichiers de Claude Opus-5 uniquement.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.23219
- Le PDF : https://arxiv.org/pdf/2611.23219
- La page du projet : https://ssundaram21.github.io/self-org/
- Notre fiche sur un modèle qui révise son propre harnais sur ARC-AGI-3 : /p/harnais-auto-ameliore-arc-agi-3
- Notre fiche sur la mémoire des modifications pour l’auto-amélioration continue chez Google : /p/memoire-auto-amelioration-harnais-rsi-continu-google
- Notre fiche sur les harnais auto-améliorants et leurs garde-fous, publiée le même jour : /p/harnais-auto-ameliorants-cadre-modulaire-google