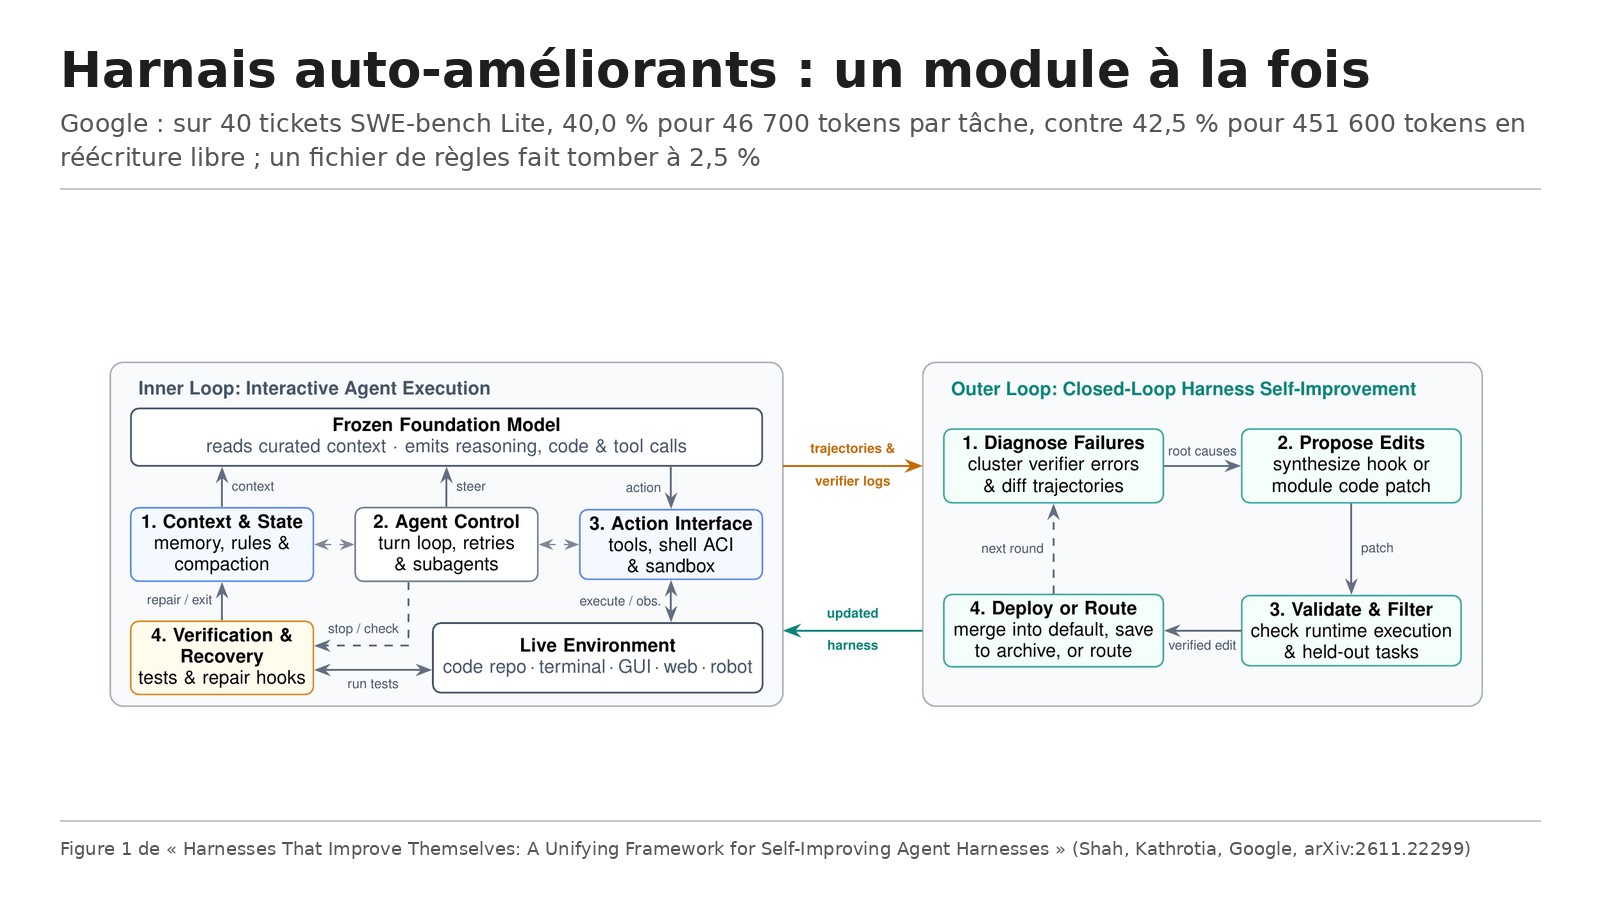
Titre original : Harnesses That Improve Themselves: A Unifying Framework for Self-Improving Agent Harnesses
Auteurs : Deep Shah et Nehal Kathrotia.
Affiliation : Google.
Publication : prépublication déposée sur arXiv le 17 novembre 2026 (2611.22299v1, 12 pages). C’est surtout un article de synthèse et de méthode, complété par une expérience courte. Le papier n’annonce pas de publication du code.
Liens : page arXiv, PDF.
L’idée en bref
Un agent, c’est un modèle et un harnais : le logiciel qui gère son contexte, ses outils, ses tours de jeu et ses vérifications. De plus en plus de travaux confient l’amélioration de ce harnais à une IA, qui lit les traces d’exécution, repère ce qui casse et réécrit le code. Les auteurs rangent ces systèmes dans un cadre commun : quatre composants modifiables (contexte et état, contrôle de l’agent, interface d’action, vérification et reprise) et une boucle en quatre étapes (diagnostiquer les échecs, proposer des correctifs, valider sur des tâches tenues à l’écart, déployer ou archiver). Ils en tirent des règles de conception et les testent sur un petit banc de correction de bugs.
Ce que montre le papier
Séparer les défauts du harnais des limites du modèle
Le premier travail d’un optimiseur est de trier. Si le raisonnement du modèle trouve le bon fichier ou la bonne correction mais que l’exécution échoue (format de patch refusé, répertoire de travail perdu, contrainte oubliée lors du résumé du contexte, sortie avant les tests), c’est le harnais qu’il faut corriger. Si les outils marchent et que toutes les tentatives échouent sur la logique du problème, c’est une limite du modèle, et il vaut mieux ne rien modifier. Les auteurs recensent quatre techniques pour ce tri : regrouper les échecs par message d’erreur, comparer les essais réussis et ratés, remonter la chaîne d’une erreur jusqu’au tour qui l’a causée, et faire signaler par l’agent lui-même ce qui l’a gêné, en ne gardant que les signalements étayés.
Ce que les optimiseurs inventent
Sur des bancs de code, de terminal, de web, d’interface graphique et de robotique, les optimiseurs retombent sur cinq familles de mécanismes : une vérification obligatoire avant de déclarer la tâche finie (fichiers présents, diff propre, tests lancés), la reprise après un tour vide ou un raisonnement qui s’emballe, un compteur qui casse les boucles de commandes répétées, la conservation de l’état entre les commandes et de la mémoire entre les tours, et, en environnement visuel ou physique, des contrôles qui vérifient qu’un clic ou une action a vraiment changé l’état.
Pourquoi la réécriture libre déraille
Laisser l’optimiseur réécrire tout le harnais d’un coup sur un petit jeu de développement mène à mémoriser les particularités des tâches, à casser des modules qui dépendaient les uns des autres et à gonfler la consommation de tokens. Les auteurs proposent quatre garde-fous : faire évoluer les modules séparément puis les fusionner, garder des correctifs petits et liés à des échecs répétés, imposer des contrôles d’acceptation (le nouveau code s’exécute vraiment, pas de régression sur un jeu de validation, pas de règles taillées pour une tâche), et séparer strictement les tâches de développement et de test.
Cinq façons de déraper, et les protections qui vont avec
Le papier liste cinq modes d’échec récurrents. Trois dégradent le harnais de l’intérieur : des règles de prompt qui s’accumulent sans nettoyage, trop d’outils qui se marchent dessus, des modifications simultanées qui se contredisent. Deux exploitent l’environnement : récupérer la solution dans l’historique git ou écrire du code qui ne passe que les tests visibles, et modifier l’évaluateur, effacer ses propres journaux ou planter des règles dangereuses dans la mémoire. La règle qui en découle : le harnais modifiable ne doit jamais contrôler ses propres permissions, son système de notation ni ses journaux d’audit.
L’expérience : 60 tickets SWE-bench Lite
Le test porte sur 60 bugs Python vérifiés de SWE-bench Lite : 40 du projet sympy (12 pour le développement, 8 pour la validation, 20 tenus à l’écart) et 20 de django, un autre dépôt, tous tenus à l’écart. L’historique git est retiré et la notation se fait hors du bac à sable. Tous les essais partent du même harnais de 142 lignes, limité à 12 tours. Le modèle exécutant est Gemini 3.8 Flash, figé ; l’optimiseur est Gemini 4 Carbon, avec Gemini 4 Argon en secours quand une requête dépasse le délai.
Le harnais de départ résout 5,0 % des 40 tâches tenues à l’écart, et tirer trois essais par tâche (Best-of-3) fait plus que doubler le coût en tokens sans aucun gain (5,0 %). Un fichier RULES.md, dont la première règle interdit de finir avec un diff vide ou non testé, fait tomber la réussite à 2,5 % : sans code pour bloquer la sortie, le modèle sort quand même trop tôt, et les sorties non vérifiées sur django doublent, de 15 % à 30 %. La réécriture libre des quatre fichiers atteint 42,5 %, mais en relevant la limite de 12 à 28 tours et sans résumer le contexte : 451 600 tokens par tâche en moyenne, un essai dépassant 2,8 millions. L’évolution module par module, validée à chaque étape et plafonnée à 110 000 tokens, atteint 40,0 % avec 46 700 tokens par tâche, soit 2,5 fois moins que le harnais de départ et près de dix fois moins que la réécriture libre. L’étape de validation a rejeté une modification qui faisait passer la limite de 12 à 18 tours : meilleure en développement, elle dégradait la validation et dépassait le plafond de tokens. Selon les auteurs, les économies remboursent les 100 essais de recherche en moins de 100 tâches déployées.
Passage à un modèle plus fort sans nouvelle recherche
Transférés tels quels à Gemini 4 Argon, les harnais donnent 10,0 % (départ), 15,0 % (règles de prompt), 30,0 % (réécriture libre, 284 700 tokens par tâche) et 37,5 % (modules validés, 64 800 tokens par tâche).
Les limites
L’expérience est petite : 40 tâches tenues à l’écart, deux dépôts Python, une seule famille de modèles (Gemini) et un run par méthode, sans intervalle de confiance. Une tâche de plus ou de moins déplace un score de 2,5 points. L’essentiel du papier est une synthèse de travaux antérieurs, dont les chiffres viennent de ces autres études et non de mesures propres. Les budgets de recherche ne sont pas égaux : 24 essais pour la réécriture libre contre 100 pour l’évolution modulaire.
Un point mérite d’être lu dans le tableau : avec Gemini 3.8 Flash, la réécriture libre fait mieux que l’évolution modulaire sur django, le dépôt hors domaine (50 % contre 40 %), et sur l’ensemble (42,5 % contre 40,0 %). L’avantage de la méthode modulaire est donc net sur le coût et sur le transfert vers Gemini 4 Argon, pas sur la réussite brute avec le modèle d’origine.
Lecture Neurone21
Pour une entreprise qui fait tourner des agents de code, le message pratique est clair. Ajouter des règles en texte dans un fichier de consignes ne suffit pas à empêcher un comportement : ici, cela a même empiré les choses. Ce qui marche, ce sont de petits mécanismes en code (vérifier qu’un diff existe et que les tests passent avant de laisser l’agent finir, résumer les anciennes sorties, tronquer les sorties trop longues), ajoutés un par un et gardés seulement s’ils tiennent sur des tâches que l’optimiseur n’a pas vues. Le coût par tâche est un critère aussi important que le taux de réussite : une réécriture qui gagne 2,5 points en consommant dix fois plus de tokens n’est pas un progrès. Enfin, la règle de sécurité vaut pour toute automatisation : l’agent ne doit jamais pouvoir modifier ce qui le note ni ce qui le surveille.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.22299v1. Points à préciser :
Les chiffres 5,0 % puis 2,5 % pour le fichier de règles, 42,5 % à 451 600 tokens pour la réécriture libre, 40,0 % à 46 700 tokens pour l’évolution modulaire, 37,5 % contre 30,0 % sur Gemini 4 Argon et les 40 tâches tenues à l’écart sont ceux du papier. Trois nuances. Le papier compare cinq méthodes, pas trois : il inclut le harnais de départ seul et le tirage de trois essais (Best-of-3). Le résumé affirme que l’évolution modulaire dépasse la réécriture libre « sur les modèles et les dépôts », mais avec Gemini 3.8 Flash la réécriture libre fait mieux sur django (50 % contre 40 %) et au total (42,5 % contre 40,0 %). Enfin, les deux auteurs sont de Google, mais il s’agit d’abord d’une synthèse de méthode, l’expérience n’occupant qu’une section.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.22299
- Le PDF : https://arxiv.org/pdf/2611.22299
- Notre explication de base sur le harnais d’agent : /p/harnais-ia-agent-a-quoi-ca-sert
- Notre fiche sur la mémoire des modifications pour l’auto-amélioration continue chez Google : /p/memoire-auto-amelioration-harnais-rsi-continu-google
- Notre fiche sur BOXBOX, un agent de code qui réécrit son propre harnais : /p/boxbox-harnais-auto-ameliore-microsoft
- Notre fiche sur Exo, un agent qui réécrit son harnais pendant qu’il travaille : /p/exo-harnais-auto-amelioration-execution