Titre original : Exo: A Harness Architecture for Runtime Self-Improvement
Auteurs : Alexander Krentsel, Sylvia Ratnasamy, Ion Stoica, Martin Casado et Ankur Goyal.
Affiliations : University of California, Berkeley ; Andreessen Horowitz ; Braintrust.
Publication : prépublication arXiv 2611.00463v1 (cs.AI), déposée le 30 octobre 2026, 14 pages.
Liens : page arXiv, PDF, code source, publié en open source.
L’idée en bref
Le harnais d’un agent, c’est tout ce qui entoure le modèle : les prompts, l’assemblage du contexte, les outils, la mémoire. Aujourd’hui on l’optimise hors ligne, avec un jeu de tâches représentatif et beaucoup d’exécutions coûteuses, puis il reste figé pendant le travail réel. Or les auteurs rappellent qu’une étude citée trouve que 75 % des équipes interrogées évaluent leurs agents sans jeu de tests.
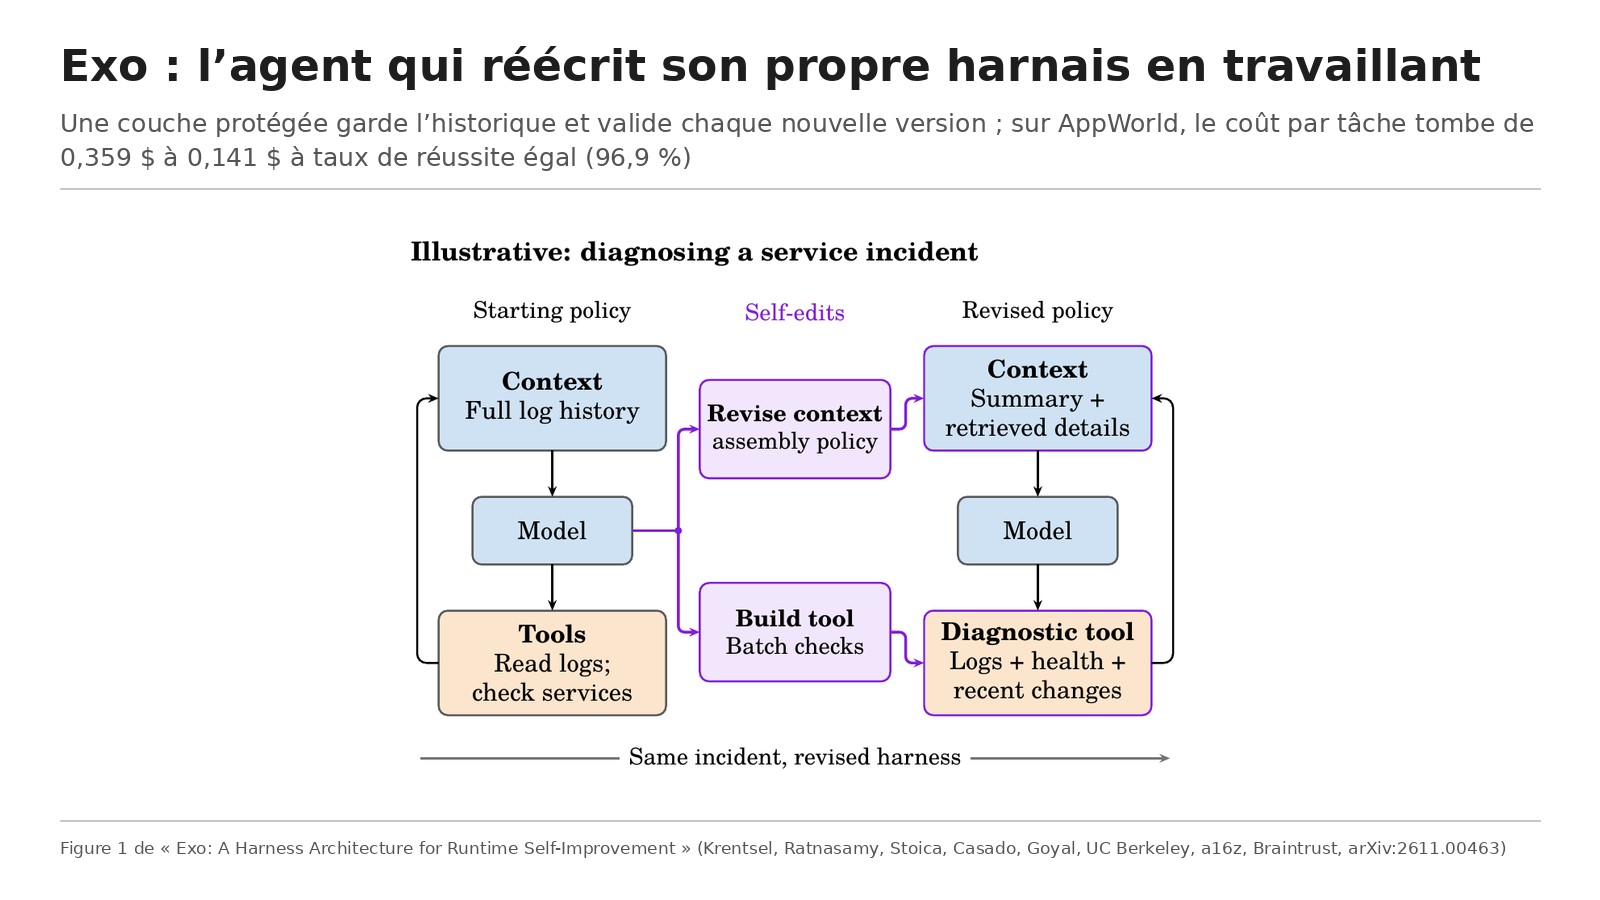
Exo fait entrer la boucle d’optimisation dans la tâche elle-même. Le harnais est du code, et l’agent sait déjà lire et modifier du code : il peut donc améliorer son propre harnais avec ses outils habituels, en cours de route. Pour que cela reste sûr, Exo sépare deux couches, sur le modèle des exokernels en systèmes d’exploitation. Une couche protégée garde un historique en ajout seul et des points de restauration, et un « gardien » décide si une nouvelle version du harnais peut être activée. Tout le reste est modifiable par l’agent.
Ce que montre le papier
Sur des tâches longues, l’investissement initial paie
Dans un environnement de jeu en monde ouvert inspiré de RuneScape, Exo atteint les objectifs de combat et d’artisanat pour un coût de modèle 12 à 53 % plus bas que Codex et Pi, et gagne 44 à 125 % de monnaie de plus par dollar. Au début il dépense plus : 0,31 dollar après dix minutes, contre 0,12 pour Codex et 0,16 pour Pi, le temps de construire ses outils. Pi le dépasse en dépense cumulée à 25 minutes, Codex à 86 minutes. En reprise sur des comptes neufs, avec les modifications conservées, l’écart monte à 45 à 82 %.
Sur des tâches notées, même réussite pour beaucoup moins cher
Face à la même politique de départ privée de l’auto-modification, sur des tâches réservées : sur AppWorld, les deux réussissent 96,9 % des tâches, mais le coût passe de 0,359 à 0,141 dollar par tâche (61 % de moins), le temps moyen baisse de 13 % et le coût total, apprentissage compris, de 43 %. Sur 20 incidents SREGym, le temps médian de diagnostic tombe de 81 à 53 secondes et le nombre médian d’appels au modèle de 16 à 10. Sur Continual Learning Bench, les deux résolvent tous les tickets, avec 14 % de coût en moins pour Exo.
Ce que l’agent modifie réellement
Les modifications sont lisibles : un outil de combat qui regroupe les actions, un outil d’instantané d’incident révisé cinq fois et utilisé en premier sur chaque nouvel incident, un contexte réduit aux quatre derniers résumés de tour. Sur AppWorld, la part d’entrée servie depuis le cache passe de 57,5 % à 86,1 %.
Les limites
- Seuil de capacité : avec gpt-5-mini, l’agent modifie peu son harnais et ne réutilise pas ses outils (59 % contre 55 % de réussite, coût quasi identique) ;
- tâches peu répétitives : sur des quêtes toutes différentes, Exo coûte plus cher que Codex et Pi (0,28 contre 0,24 et 0,21 dollar par point de quête) ;
- gardien minimal : par défaut, il vérifie seulement que la nouvelle version compile ; la protection empêche d’effacer l’historique, pas de régresser ;
- comparaisons limitées : AppWorld, SREGym et CLB comparent Exo à sa propre version figée, pas à d’autres optimiseurs de harnais.
Lecture Neurone21
Exo répond à un problème que vivent toutes les équipes qui déploient des agents : on n’a presque jamais de jeu de tests propre pour son métier. Laisser l’agent améliorer ses outils pendant le travail réel, mais derrière une couche qu’il ne peut pas toucher, est une approche raisonnable. Le point clé, c’est que les améliorations restent du code qu’on peut relire, tester et refuser.
Pour un déploiement en entreprise, retenez trois gestes. Garder un journal d’exécution que l’agent ne peut pas effacer. Faire valider toute modification du harnais par un contrôle extérieur, idéalement par un humain au début. Réserver l’auto-amélioration aux tâches répétitives, là où l’investissement initial se rembourse.
D’où vient ce papier
DAIR.AI (@dair_ai) l’a présenté le 6 novembre 2026 (15:55 UTC, 16:55 heure de Paris) ; Elvis Saravia (@omarsar0) l’a republié dix minutes plus tard. Nous avons lu la version officielle arXiv 2611.00463v1. Écarts avec le post :
Le post retient AppWorld et SREGym et la fourchette de 35 à 61 % : c’est exact, mais il ne dit pas que la comparaison se fait contre la même politique sans auto-modification, ni que le gain disparaît avec un modèle plus faible. Les chiffres de 13 % et 35 % correspondent au papier. Le titre du papier est « A Harness Architecture for Runtime Self-Improvement », légèrement différent de celui repris dans le lien DAIR.AI Academy.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.00463
- Le PDF : https://arxiv.org/pdf/2611.00463
- Le code source : https://github.com/exoharness/exo
- Le post DAIR.AI : https://x.com/dair_ai/status/2118733906346459596
- La republication d’Elvis Saravia : https://x.com/omarsar0/status/2118736660011589819
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/exo-an-architecture-for-self-improving-systems-at-runtime-2611.00463