Titre original : Self-Improvement Memory Enables Continual Recursive Self-Improvement
Auteurs : Xin Yu (premier auteur, stagiaire chez Google pendant ce travail), Fei Xia, Jiaqi Pan, Youbao Tang, Chengzhi Liu, Adams Yu, Sicong Jiang, Yanfei Chen, Lingzhou Xue et Ting Yu.
Affiliations : Google Cloud AI, Google DeepMind, Google Cloud AI Research et Pennsylvania State University.
Publication : prépublication déposée sur arXiv le 13 novembre 2026 (2611.18856v1, 35 pages avec annexes). Le papier n’annonce pas de publication du code.
Liens : page arXiv, PDF.
L’idée en bref
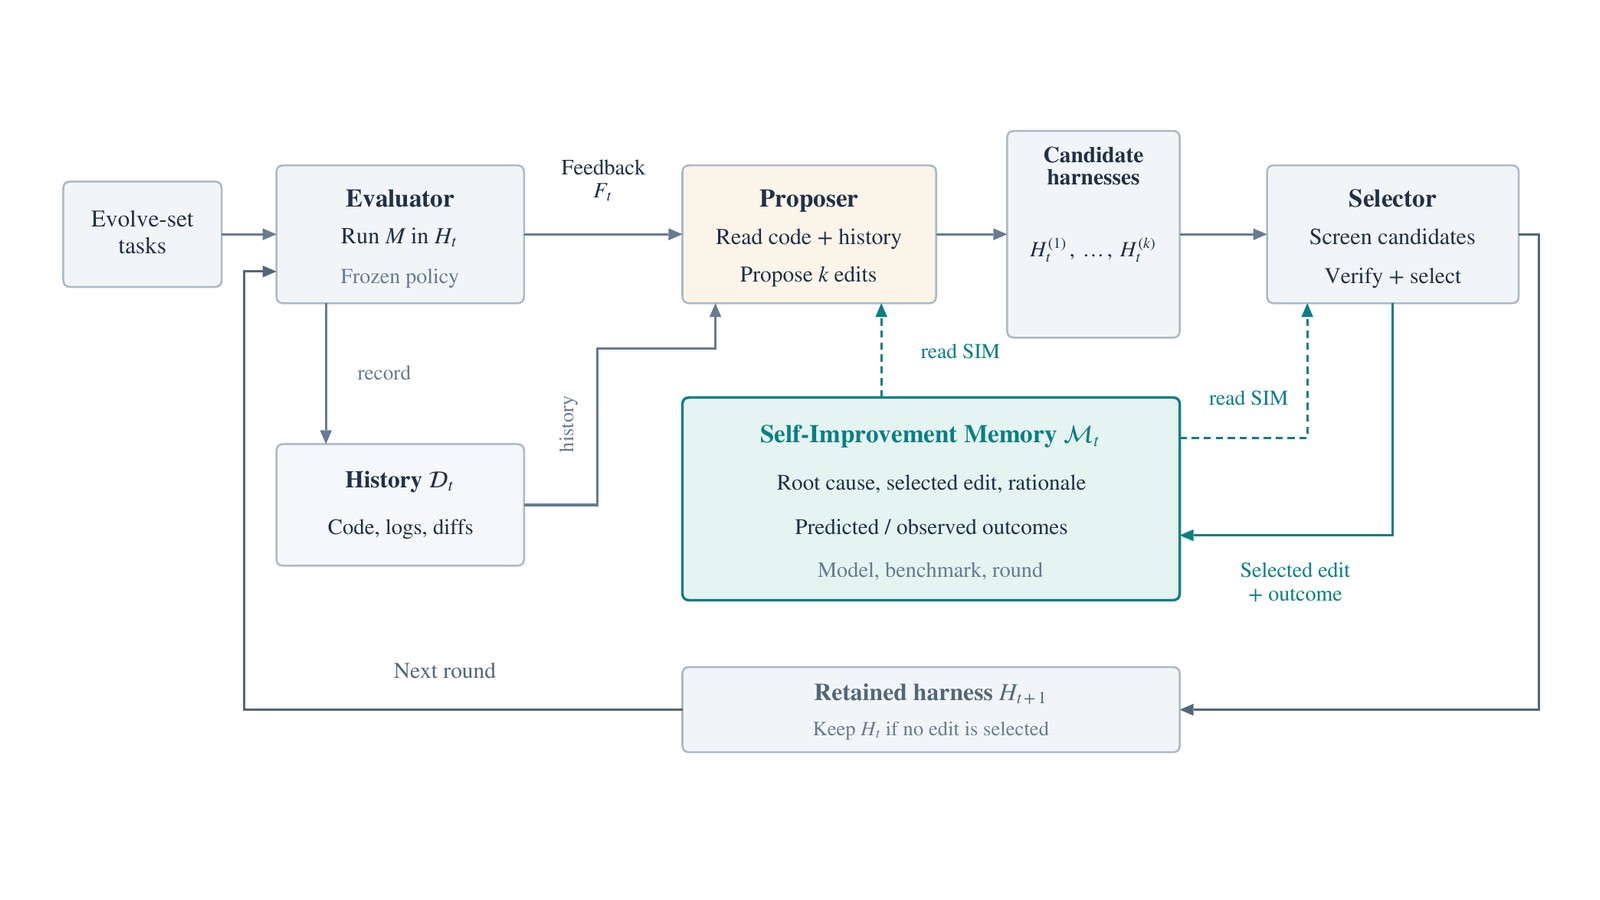
Un agent, c’est un modèle et un harnais : le code qui gère son contexte, ses outils et le déroulé de son travail. Plusieurs travaux récents font améliorer ce harnais par une IA, en boucle : un « proposeur » suggère des modifications, on les teste, un « sélecteur » garde la meilleure, et on recommence. C’est ce que les auteurs appellent l’auto-amélioration récursive (recursive self-improvement, RSI) au niveau du harnais, le modèle restant figé.
Le problème étudié ici arrive après : le modèle change (nouvelle version, autre fournisseur) ou les tâches changent. Le harnais optimisé reste utilisable, mais on ne sait plus pourquoi chaque modification a été faite ni si elle a marché. Les auteurs proposent de garder ce journal à côté du code, sous le nom de Self-Improvement Memory (SIM). Cette mémoire sert à l’optimiseur du harnais, pas à l’agent qui résout les tâches.
Ce que montre le papier
Une mémoire rangée par problème
SIM regroupe les modifications par problème récurrent du harnais, par exemple un agent qui déclare avoir fini trop tôt. Pour chaque tentative retenue, elle stocke la modification et sa justification, les tâches qu’elle devait corriger (prédiction écrite avant l’évaluation), les tâches réellement corrigées ou cassées, et le contexte : domaine, benchmark, modèle, tour. Le proposeur la reçoit en entier dans son prompt, le sélecteur la lit aussi, sans recherche ni troncature. Une modification qui a fait régresser les scores y reste consignée.
Un harnais optimisé peut démarrer plus bas que le harnais de départ
C’est le constat qui motive le papier. Un harnais optimisé avec Claude Opus 5.5 sur des tâches de bureau (« workspace ») démarre à 68,41 points avec Gemini 3.8 Flash, sous les 73,89 du harnais de départ non optimisé. En classification de textes, un harnais optimisé sur trois jeux de données démarre à 72,92 sur les huit nouveaux jeux, sous les 75,72 du harnais d’origine.
Quatre façons de reprendre, comparées à budget égal
Quatre domaines sont testés : le code (de Terminal-Bench 2.1 vers Terminal-Bench 4), la classification de textes, les tâches de bureau (de Harvey LAB vers la moyenne de JobBench, GDPval et APEX-Agents) et la conception d’ingénierie (d’EngDesign vers Frontier-Eng). Chaque optimisation dure 10 tours de 5 propositions, avec 5 essais par tâche. On compare un départ à froid depuis le harnais d’origine, la reprise du harnais optimisé seul, la reprise avec les seules causes des problèmes, et la reprise avec SIM complète.
Quand le benchmark change (modèle Gemini 3.8 Flash fixe, six situations), SIM finit première partout, de 2,43 à 4,35 points devant la reprise du harnais seul. Garder seulement les causes donne des effets mitigés, de 1,82 point en dessous à 2,40 au-dessus de la reprise simple. Quand le modèle change (d’Opus 5.5 vers Gemini 3.8 Flash, quatre domaines), SIM finit aussi première partout, de 3,60 à 11,33 points devant le harnais seul. Le plus gros écart concerne les tâches de bureau : 84,75 avec SIM contre 73,42 sans, à partir du même 68,41.
Le seul test répété : dix paires de runs en code
Toutes les comparaisons précédentes reposent sur un run par condition. Pour mesurer la variabilité, les auteurs ont refait dix fois l’optimisation de départ en code, puis lancé deux reprises par harnais obtenu, avec et sans SIM. SIM gagne dans 9 paires sur 10 (une paire perd 0,61 point). Partant de 18,36 en moyenne sur Terminal-Bench 4, les reprises finissent à 21,70 avec SIM contre 19,33 sans : 2,36 points d’écart moyen (intervalle de confiance à 95 % de 1,05 à 3,68 ; p = 0,003).
D’une génération de modèle à la suivante
Sur Terminal-Bench 2.1, les auteurs font passer harnais et mémoire de Gemini 2.5 Flash à 3.5 Flash, 3.8 Flash puis 4 Argon. La reprise fait mieux qu’une optimisation repartant de zéro sur deux générations sur trois (+3,5 points sur 3.5 Flash, +1,6 sur 3.8 Flash), mais finit 0,8 point plus bas sur Gemini 4 Argon (94,8 contre 95,6).
Un harnais commun à trois modèles
En classification, un harnais unique servant Grok 4.20 Reasoning, Claude Opus 5.5 et Gemini 3.8 Flash, construit en mettant en commun les retours des trois modèles, atteint 75,24 sur les données tenues à l’écart. C’est autant que trois harnais optimisés séparément (75,20), et plus que le harnais de départ commun (73,28). La reprise en chaîne d’un modèle à l’autre atteint 74,20.
Les limites
Les auteurs le disent : faute de budget de calcul, seules les expériences de code sont répétées ; les autres domaines reposent sur un run par condition et sont présentés comme descriptifs. Ils n’étudient que des cas où le harnais reste compatible d’un contexte à l’autre, avec des procédures de recherche fixes, et évaluent SIM comme un tout (mémoire héritée et mise à jour pendant la reprise) sans isoler chaque partie. Un tour d’optimisation en code prend environ 4 heures ; les méthodes sont mises à égalité en nombre de tours et de propositions, mais leur consommation de tokens et leur durée peuvent différer. Ils signalent aussi qu’un harnais qui se modifie lui-même peut apprendre à satisfaire l’évaluateur sans résoudre la tâche, et que les scores des tâches de bureau dépendent d’un juge LLM (Gemini 3.8 Flash).
Nos réserves : les gains sont réels mais modestes en code, où les scores sur Terminal-Bench 4 restent autour de 20 sur 100. Le proposeur et le sélecteur sont des modèles Gemini dans les comparaisons principales, et le papier ne dit pas ce que coûte de faire relire une mémoire complète à chaque tour quand elle grossit sur des mois.
Lecture Neurone21
La leçon dépasse les laboratoires. Toute équipe qui ajuste les prompts, outils et règles d’un agent, à la main ou avec une IA, accumule des correctifs dont on oublie vite la raison. Au changement de modèle, deux erreurs guettent : tout garder (le papier montre qu’un harnais optimisé peut alors faire moins bien que l’original) ou tout jeter. Tenir un journal par problème, avec la raison du correctif, ce qu’on en attendait et ce qu’on a mesuré, est peu coûteux et permet de trier ce qui doit être conservé, révisé ou supprimé. C’est l’équivalent, pour un harnais d’agent, d’un historique de décisions d’architecture.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.18856v1. Points à préciser :
Les chiffres 9 paires sur 10, 2,36 points, p = 0,003, six situations de changement de benchmark et quatre de changement de modèle, sont ceux du papier. Trois nuances. Le démarrage à 68,41 contre 73,89 concerne les tâches de bureau, lors du passage d’Opus à Gemini : c’est le pire cas, le retard de départ allant de 0,60 à 5,48 points selon le domaine. Le papier ne vient pas de Google seul : Penn State en est coauteur. Enfin, SIM n’est pas une mémoire « dans votre harnais » au sens de la mémoire de l’agent : c’est la mémoire de l’optimiseur qui modifie le harnais, pas celle de l’agent qui exécute les tâches.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.18856
- Le PDF : https://arxiv.org/pdf/2611.18856
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/self-improvement-memory-enables-continual-recursive-self-improvement-2611.18856
- Notre fiche sur Terminal-Bench 2.0, l’ancêtre des bancs de code utilisés ici : /p/terminal-bench-2-agents-terminal-89-taches
- Notre fiche sur BOXBOX, un agent de code qui réécrit son propre harnais : /p/boxbox-harnais-auto-ameliore-microsoft
- Notre fiche sur RIME, une autre approche de la mémoire pour l’apprentissage continu : /p/rime-memoire-agents-apprentissage-continu-cmu