Titre original : How to Train Memory Writing for Continual Learning (méthode RIME, pour RL for Memory & Exploration)
Auteurs : Qixin Xu, Yuxiao Qu, Ian Wu et Aviral Kumar.
Affiliation : Carnegie Mellon University (laboratoire AIRe), avec des GPU du centre CMU FLAME.
Publication : billet de recherche publié en novembre 2026 sur le site du laboratoire, hors arXiv et sans relecture extérieure. Nous n’avons trouvé ni version arXiv ni PDF à ce jour.
Liens : le billet, les tâches d’entraînement.
L’idée en bref
Un agent qui enchaîne des tâches dans le même dépôt de code devrait apprendre de ses premières tâches : où sont les tests, quelles erreurs éviter. Aujourd’hui, on lui demande en général de résumer son expérience dans un fichier de notes, comme le MEMORY.md des agents de code. RIME entraîne plutôt cette écriture. Un seul modèle joue deux rôles selon la consigne : l’acteur résout la tâche avec les notes du moment, puis le rédacteur réécrit ces notes pour la tâche suivante.
Le rédacteur est récompensé si la réussite moyenne sur les quelques tâches suivantes dépasse celle des quelques tâches précédentes. L’acteur est récompensé pour sa tâche, plus un bonus d’exploration : un modèle juge compare les notes avant et après, sans voir la tâche, et note les découvertes, les croyances corrigées, les pistes concrètes et l’absence de redite. Découverte centrale des auteurs : entraîner le seul rédacteur ne suffit pas, il faut aussi pousser l’acteur à explorer, sinon il n’a plus rien d’utile à transmettre.
Ce que montre le papier
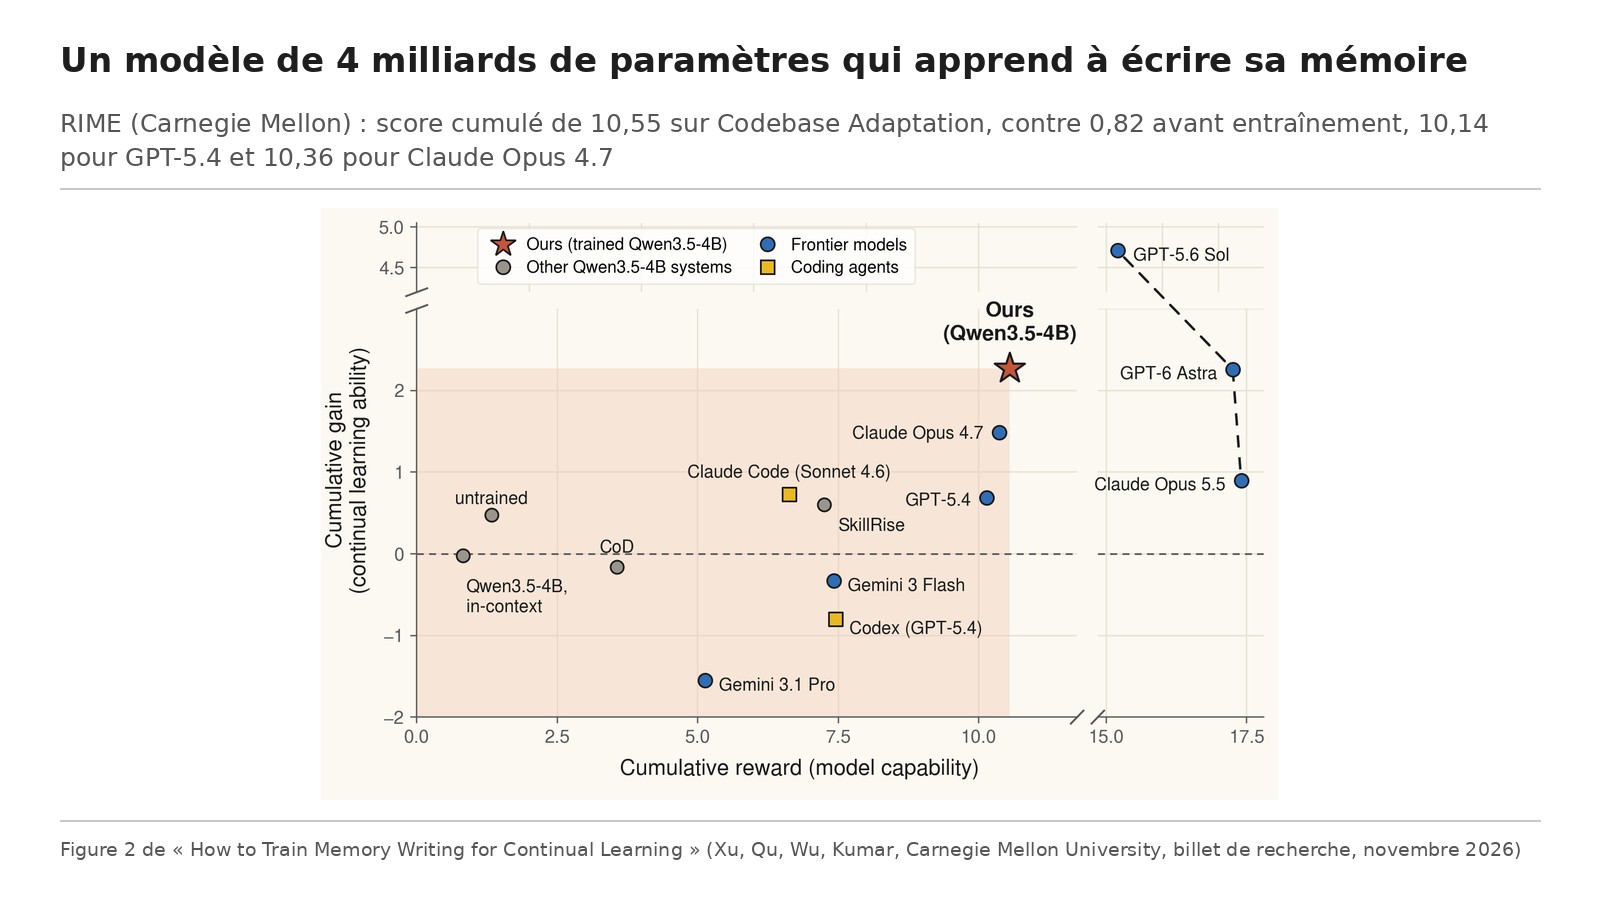
Le test principal, Codebase Adaptation (Continual Learning Bench), enchaîne 19 corrections de bugs dans deux dépôts jamais vus (9 dans tablib, 10 dans tenacity), sur cinq passes. Le score cumulé additionne les récompenses, le gain cumulé mesure l’apport de la mémoire face au même modèle repartant de zéro à chaque tâche.
Qwen3.5-4B passe d’un score de 0,82 à 10,55, avec un gain de +2,27. Placé dans la même boucle sans entraînement, il ne fait que 1,33 ; les méthodes concurrentes CoD et SkillRise, entraînées sur les mêmes données, font 3,56 et 7,25. GPT-5.4 et Claude Opus 4.7, d’après le classement du banc, font 10,14 et 10,36. Les modèles de pointe testés par les auteurs font bien mieux en score (Claude Opus 5.5 à 17,40, GPT-6 Astra à 17,25, GPT-5.6 Sol à 15,20), mais Claude Opus 5.5 tire peu de son passé (+0,90), GPT-6 Astra autant que le 4B entraîné (+2,26), et seul GPT-5.6 Sol fait nettement plus (+4,71). Codex fait moins bien avec son historique que sans (−0,80).
Les ablations confirment le mécanisme. Sans bonus d’exploration et avec un rédacteur entraîné, le gain devient négatif. Les tâches d’entraînement, 382 suites de 12 tâches tirées de 53 dépôts, doivent aller du facile au difficile : mélangées, le score tombe à 8,05. Sur deux suites plus longues de 26 et 27 tâches, le modèle reste en tête (13,50 et 12,35). Un modèle unique pour les deux rôles fait mieux que deux modèles séparés (10,55 contre 10,07).
Les limites
Le billet n’a pas de section dédiée et pose surtout des questions ouvertes : jusqu’où la méthode généralise, et comment faire quand les tâches n’arrivent pas en suites bien définies. Nos réserves : le résultat principal repose sur une seule suite de 19 tâches et un seul modèle de 4 milliards de paramètres ; les scores de GPT-5.4 et Claude Opus 4.7 sont repris du classement, non recalculés, et les auteurs jugent eux-mêmes la comparaison inégale ; le test sur l’environnement jouet Symbolic Alchemy utilise un autre modèle, Qwen3-4B. Ce n’est pas un papier relu par des pairs.
Lecture Neurone21
Pour une entreprise qui fait travailler un agent dans la durée sur ses propres outils, le message est clair : un fichier de notes résumé à la fin de chaque tâche ne garantit pas que l’agent s’améliore, et les agents de code du marché testés ici gagnent peu, voire perdent, avec leur historique. Il vaut mieux mesurer ce gain directement, en comparant l’agent avec et sans sa mémoire sur une suite de tâches réelles. La méthode elle-même s’adresse aux équipes qui affinent un modèle ouvert : un petit modèle local entraîné ainsi peut rivaliser avec de grands modèles fermés de la génération précédente.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a recommandé le 13 novembre 2026 à 21:13 heure de Paris, en citant le post d’Aviral Kumar publié à 16:08. Nous avons lu le billet officiel. Écarts avec le post :
« Un score proche de GPT-5.4 et Claude Opus 4.7 » est exact pour le score cumulé sur Codebase Adaptation, mais ces deux références sont reprises du classement et datent d’une génération : les modèles de pointe testés par les auteurs font 15 à 17. La description des deux rôles, de la récompense du rédacteur et du juge qui compare anciennes et nouvelles notes est fidèle. Le post évoque un travail « à petite échelle », ce que confirme le billet : un seul modèle, une suite de test, pas de publication arXiv.
Pour aller plus loin
- Le billet de recherche : https://cmu-aire.github.io/RIME/
- Les tâches d’entraînement : https://huggingface.co/datasets/Racktic/memory-writing-train-tasks
- Le classement de Continual Learning Bench : https://continual-learning-bench.com/leaderboard.html
- Le post d’Aviral Kumar : https://x.com/aviral_kumar2/status/2121258848623464856
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2121335666457944226
- Notre fiche sur Continual-ARC et l’apprentissage continu : /p/continual-arc-apprentissage-continu-unify
- Notre fiche sur SoMem, une mémoire organisée par l’agent : /p/somem-memoire-auto-organisee-agents
- Notre fiche sur un petit modèle entraîné à améliorer le harnais d’un agent : /p/harnais-appris-cmu