Titre original : Continual-ARC: Measuring Skill Acquisition over a Working Lifetime
Auteur : Daniel Lenton (seul auteur sur arXiv), qui remercie Yusha Arif et Haris Mahmood pour les débuts du projet.
Affiliation : Unify, une entreprise qui construit des systèmes d’agents.
Publication : prépublication arXiv 2611.14505v1 (cs.LG), déposée le 10 novembre 2026, en cours d’évaluation, 51 pages.
Liens : page arXiv, PDF, site du banc d’essai.
L’idée en bref
On présente souvent le harnais d’un agent, avec ses notes et sa mémoire, comme un moyen d’apprendre en continu sans réentraîner le modèle. Encore faut-il le mesurer. Les bancs d’essai existants portent sur un seul domaine que les modèles connaissent déjà, servent chaque tâche une seule fois, et comparent rarement mémoire et réentraînement sur la même échelle.
Continual-ARC utilise les énigmes visuelles ARC, qui ne demandent aucune connaissance métier : il faut deviner une règle de transformation de grilles à partir de quelques exemples. Les mêmes énigmes reviennent après des pauses, chaque fois avec une nouvelle grille, pendant que d’autres arrivent. Chaque exemple demandé et chaque mauvaise réponse coûte un point, et un échec coûte tout le budget de seize points. Après le flux, le système est figé et testé sur deux choses : de nouvelles grilles des énigmes déjà vues, pour la mémorisation, et 100 énigmes jamais vues, pour la généralisation.
Ce que montre le papier
Le flux
Sur la piste ARC-AGI-1, le flux sert 200 grilles tirées de 25 énigmes, quatre actives à la fois, chacune revenant huit fois. Les principaux essais utilisent le harnais prime-agent avec deux modèles, Qwen3.5-9B et GLM-5.3 Flash. Ils sont comparés à un plancher qui se contente de garder les exemples déjà achetés, à une bibliothèque qui enregistre un programme Python vérifié par énigme, et à Qwen3.5-9B entraîné par imitation de GLM-5.3 Flash (méthode DAgger, avec un adaptateur LoRA mis à jour entre les tours).
Les harnais tels que livrés
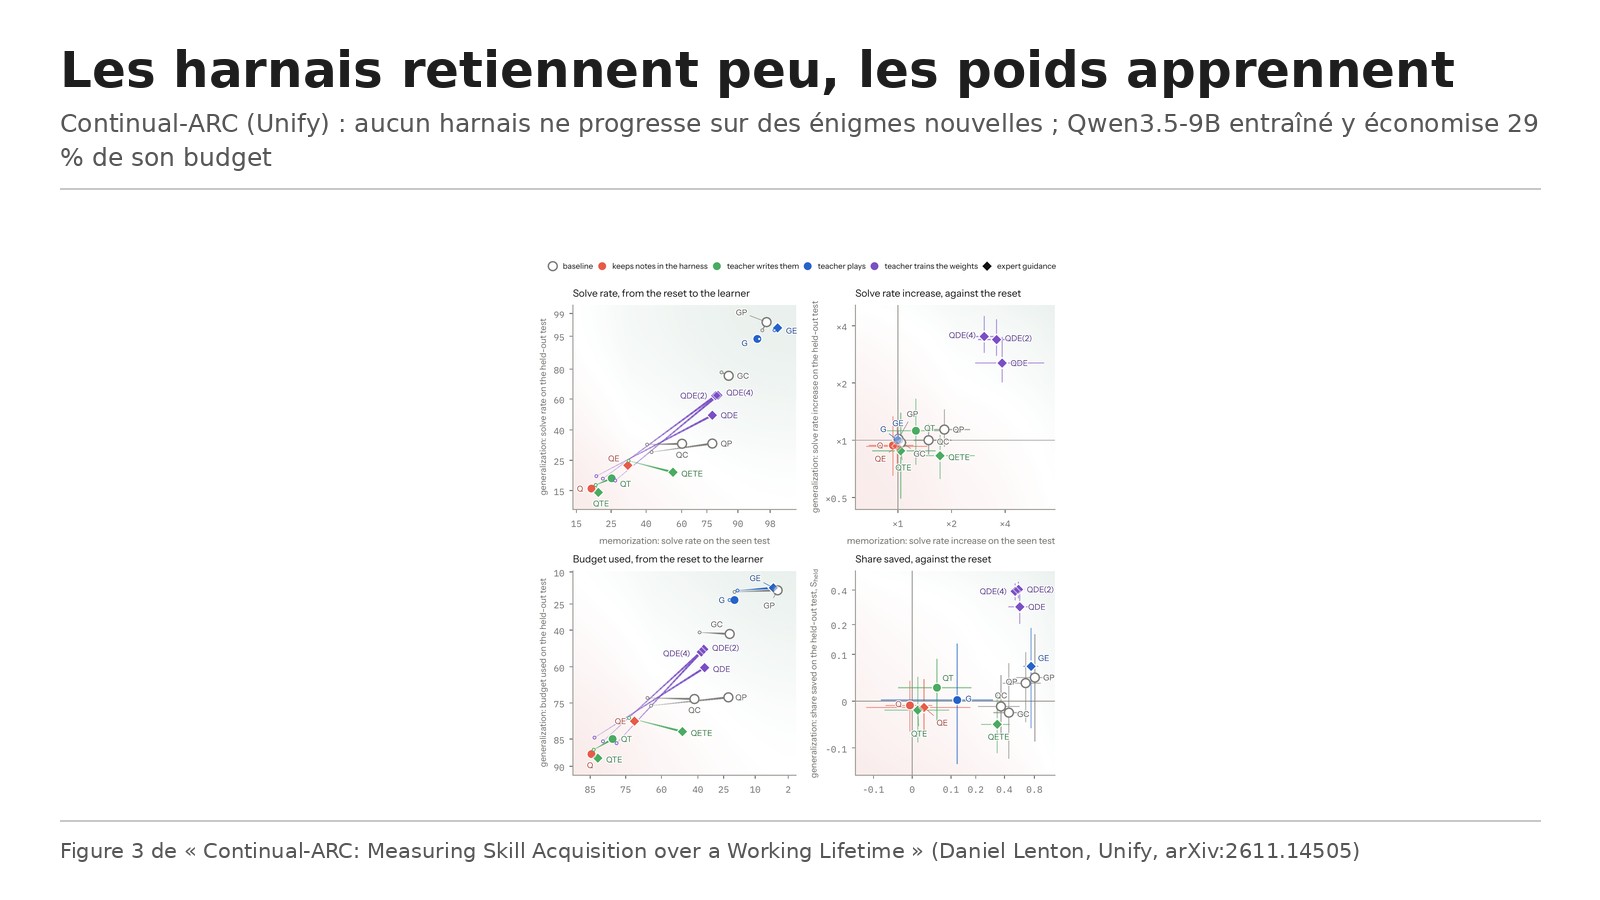
Sans aide, seul le harnais piloté par GLM-5.3 Flash économise de façon mesurable, 25 % sur les énigmes déjà vues. Avec Qwen3.5-9B, la mémoire du harnais n’économise rien de mesurable, même quand c’est GLM qui écrit les notes (106 notes et fichiers laissés). Aucun harnais ne fait mieux que le plancher qui garde simplement les exemples, lequel économise 37 % et 44 %. L’auteur a regardé pourquoi : prime-agent ne montre que six entrées de mémoire par grille, choisies avant de connaître l’énigme, si bien que la bonne règle n’est arrivée que dans 40 retours sur 154. Testés aussi avec GPT-6 Luna, hermes-agent chargeait des conseils trop généraux et openclaw ne gardait rien d’une session à l’autre.
Ce qui fonctionne
Demander au harnais de tout enregistrer après chaque verdict aide prime-agent avec GPT-6 Luna (42 % économisés sur les énigmes vues) mais pas les deux autres. Une consigne « d’expert », qui dit d’écrire un programme par énigme, de le vérifier puis de le réutiliser, fait monter l’économie à 74 % avec GLM et à 62 % à 72 % pour les trois harnais avec GPT-6 Luna. Mais aucune méthode à base de harnais ne progresse sur les énigmes nouvelles. Seul l’entraînement des poids y parvient : le Qwen3.5-9B entraîné économise 29 % sur les énigmes jamais vues et 57 % sur les vues, et résout 47 à 52 énigmes nouvelles sur 100, contre 31 pour le modèle sans entraînement en boucle simple et 18 dans prime-agent. Avec deux utilisateurs partageant le même système, l’économie sur les énigmes nouvelles monte à 40 %, puis 39 % avec quatre.
Les limites
L’auteur reconnaît que la plupart des essais utilisent de petits modèles sur la piste la plus facile, ARC-AGI-1 ; les pistes ARC-AGI-2 et ARC-AGI-3 n’ont que des résultats préliminaires. La méthode d’entraînement retenue suppose un modèle professeur plus fort dont le raisonnement est accessible. La comparaison avec trois harnais publics est négative pour eux, et l’auteur travaille pour une entreprise qui construit des systèmes d’agents ; il publie les adaptateurs pour que les auteurs des harnais puissent vérifier. Il indique aussi qu’un assistant de code (Claude) a rédigé les premières versions du texte et une grande partie du code, sous sa relecture.
Lecture Neurone21
Pour une entreprise, la conclusion pratique est nuancée. Un agent qui « garde des notes » ne retient pas forcément ce qui compte : ici, c’est une consigne précise sur quoi mémoriser et comment le vérifier qui fait la différence, pas la présence d’une mémoire. Avant de compter sur la mémoire d’un agent pour monter en compétence sur un métier, il faut tester qu’elle sert vraiment sur des cas qui reviennent, et ne pas attendre d’elle qu’elle rende l’agent meilleur sur des cas nouveaux.
L’autre enseignement va dans le sens du réentraînement léger : sur une petite série de tâches, ajuster les poids d’un modèle de 9 milliards de paramètres a mieux généralisé que toutes les notes. C’est un argument pour les modèles ouverts que l’on peut adapter soi-même.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a recommandé le 11 novembre 2026 à 23:04 heure de Paris, en citant le post de Daniel Lenton. Nous avons lu la version officielle arXiv 2611.14505v1. Écarts avec le post cité :
Daniel Lenton écrit qu’OpenClaw, Hermes Agent et Prime Agent n’ont rien mémorisé de valeur. C’est vrai de leurs réglages par défaut, mais le papier montre que prime-agent retient beaucoup quand on lui demande d’enregistrer ou qu’on lui donne la consigne d’expert, jusqu’à 74 % d’économie sur les énigmes vues. Ce qui ne marche dans aucun cas, c’est la progression sur des énigmes nouvelles.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.14505
- Le PDF : https://arxiv.org/pdf/2611.14505
- Le site du banc d’essai : https://continual-arc.unify.ai/
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2120638750740844672
- Notre fiche sur un harnais auto-amélioré testé sur ARC-AGI-3 : /p/harnais-auto-ameliore-arc-agi-3