Titre original : Can LLMs Improve Their Own Harness? A Controlled Study on ARC-AGI-3
Auteurs : Jens Lehmann (Amazon, travail fait hors d’Amazon, et Technische Universität Dresden), Sahar Vahdati (Universität Hannover et TIB, Leibniz Information Centre for Science and Technology)
Publication : prépublication arXiv 2610.30499v1 (cs.AI), déposée le 21 octobre 2026, 25 pages avec les annexes.
Liens : page arXiv, PDF. Les auteurs annoncent un artefact complet (cadre, prompts, instantanés de code, scripts de reproduction), sans lien public dans cette version.
L’idée en bref
Un harnais est le programme qui entoure le modèle : ce qu’il voit, ce qu’il retient, les outils qu’il appelle, la façon dont il se rattrape après une erreur et la quantité d’inférence qu’il dépense. Sur ARC-AGI-3, un banc d’essai de jeux en grilles 64 x 64 où l’agent doit découvrir seul les règles, des harnais conçus sous pilotage humain atteignent déjà 100 sur les jeux publics. La question des auteurs est donc simple : un modèle peut-il construire ce harnais lui-même, puis l’améliorer à partir de ses propres essais, sans aucune intervention humaine ?
Le protocole est volontairement strict. Chaque modèle part d’un dépôt minimal, travaille dans OpenCode (un harnais de code généraliste, de la même famille que Claude Code ou Codex), construit son solveur, joue cinq jeux de développement, reçoit ses traces, scores et coûts, puis révise tout le code. Il le fait deux fois. Chaque version figée est ensuite évaluée sur vingt jeux qui n’ont jamais servi à la construire ni à la réviser (section 4.2 et figure 1, p. 3 à 5). La mesure est le RHAE, qui ne crédite que les niveaux terminés et pénalise les solutions qui demandent plus d’actions qu’un humain, et le coût d’inférence en dollars.
Ce que montre le papier
Une étude de taille sérieuse. Neuf profils modèle et effort de raisonnement, de sept familles (GPT-6 Astra, GPT-5.6 Sol, Terra et Luna, Claude Fable 5, Opus 5 et Sonnet 5, avec Sol et Opus aussi en effort « xhigh », un cran au-dessus de « high »), trois constructions indépendantes chacun : 27 lignées, 81 instantanés figés et 2 025 parties évaluées (p. 2 ; tableau 1, p. 14). Le programme a coûté au moins 18 129,27 dollars aux prix publics figés le 13 septembre 2026, dont 16 130,09 pour les parties elles-mêmes et 1 352,34 pour la construction et les révisions du code (tableau 8, p. 18).
Les modèles savent construire. Les 27 constructions donnent toutes un harnais qui fonctionne. Sur les 81 étapes, 46 passent la qualification du premier coup et 35 après réparation. Le score initial sur les jeux non vus va de 0 à 97,14, pour une moyenne de 24,54 (p. 16). Les architectures varient beaucoup, même pour un même modèle : contrôleurs directs, systèmes d’heuristiques, binômes stratège et exécutant, manuels persistants, modèles du monde explicites, planificateurs déterministes, gestionnaires de budget d’inférence (p. 7).
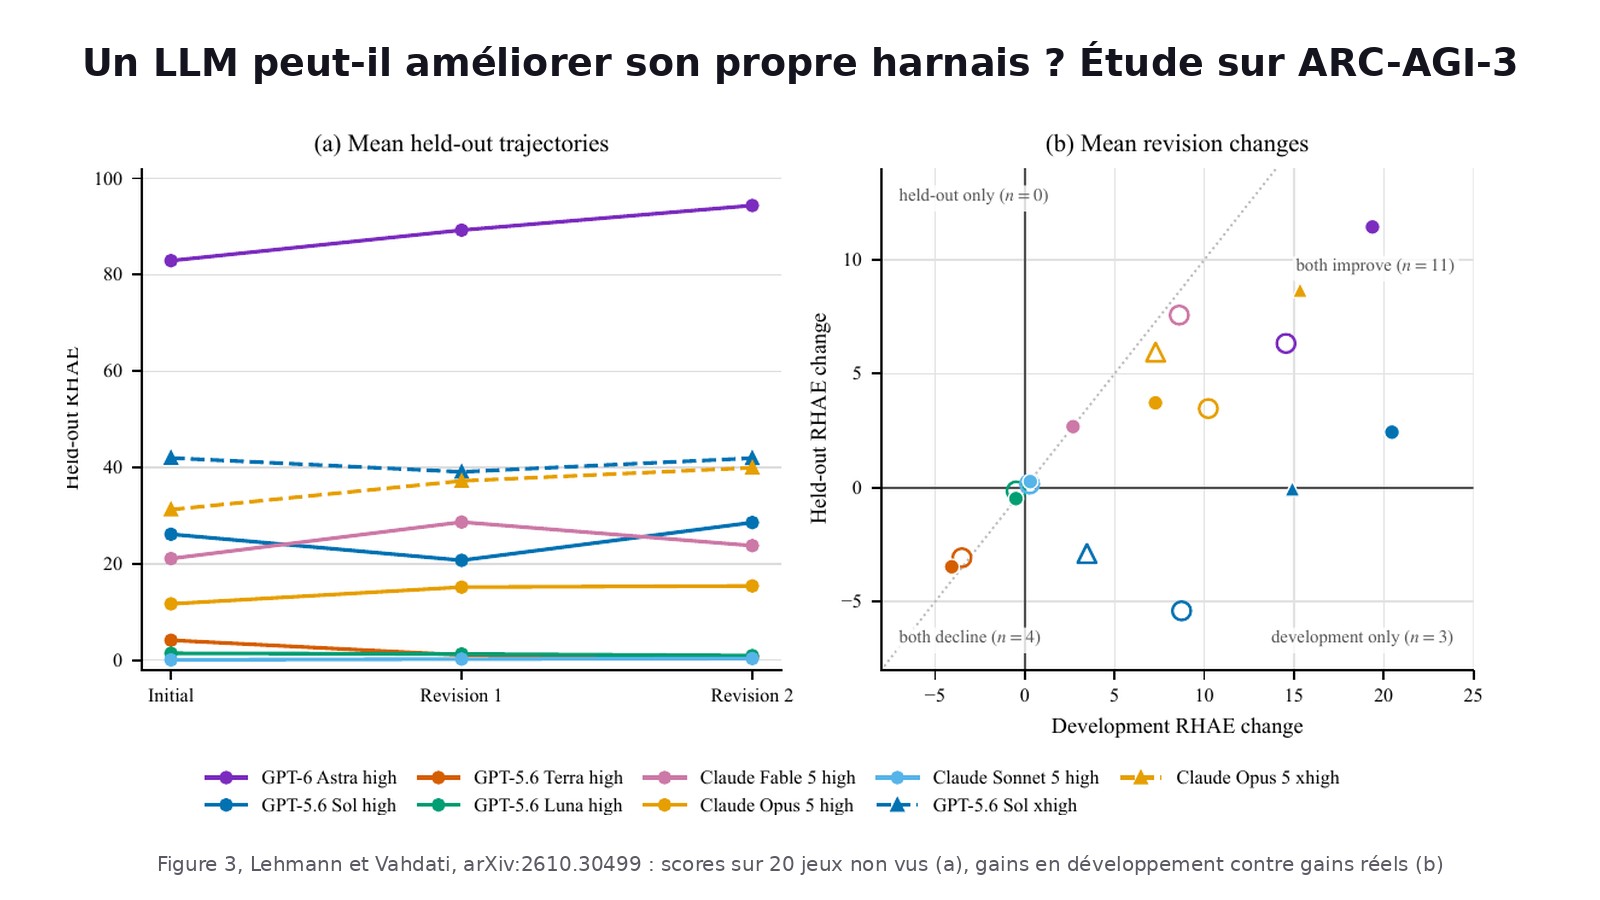
Les révisions apportent peu, en moyenne. Après deux révisions, le score moyen sur les jeux non vus monte de 2,80 points, avec un intervalle de confiance à 95 % de -1,44 à 7,35 : compatible avec aucun gain comme avec un gain utile. On compte 15 lignées en progrès et 12 en recul (test des signes, p = 0,70). Au seuil de 5 points, il reste 9 progrès, 3 reculs et 15 résultats indéterminés (p. 6). Par jeu, la moyenne monte sur 13 jeux et baisse sur 7, avec un plus fort gain de 20,44 points et une plus forte baisse de 15,03.
Les jeux d’entraînement donnent une image trop flatteuse. Sur les cinq jeux de développement, la deuxième révision gagne 8,42 points. L’écart moyen avec le gain sur les jeux non vus, que les auteurs appellent écart d’adaptation, est de 5,62 points (intervalle de 1,78 à 9,77, p. 6). Plusieurs révisions progressent sur les jeux qui ont fourni le retour tout en reculant sur les autres (figure 3b).
Moins cher ne veut pas dire meilleur. Le coût moyen par jeu passe de 10,30 dollars au départ à 7,57 après deux révisions, mais la médiane ne baisse que de 0,54 dollar (p. 6 ; tableau 6, p. 17). Sur 27 lignées, 9 gagnent à la fois en score et en coût, 6 gagnent en score mais coûtent plus, 9 coûtent moins mais perdent en score, 3 perdent sur les deux tableaux (figure 4, p. 7). Exemple du papier : une lignée Sol en effort xhigh passe de 31,39 à 7,18 dollars par jeu, et son score de 43,95 à 21,99, après avoir remplacé l’enchaînement des réponses par des appels indépendants avec une mémoire bornée (p. 7 et 8). À l’inverse, une révision Sol en effort high qui corrige le budget d’actions, la mémoire et les observations fait passer le score de 29,24 à 53,56 à coût quasi inchangé.
Garder la meilleure version aide un peu. Une règle simple, appliquée après coup, qui garde l’instantané le mieux noté sur les jeux de développement, donne +4,53 points sur les jeux non vus (intervalle de 0,81 à 8,68), contre +2,80 en déployant toujours la dernière révision, pour un coût de 9,15 dollars par jeu au lieu de 7,57 (tableau 5, p. 17). Or aucun modèle n’a choisi de garder sa version précédente, alors que c’était permis (p. 9).
Changer de stratégie est la règle, changer d’architecture jamais. Sur les premières révisions, 22 sur 27 réorientent le harnais (priorités de contrôle, mémoire, rejeu, répartition de l’inférence), 4 l’étendent et une seule le conserve. Aucune lignée ne remplace sa famille d’architecture (p. 7). Les révisions larges gagnent en moyenne +3,75 points contre -0,20 pour les retouches ciblées, mais l’intervalle inclut zéro (p. 8).
Un vrai écart avec les harnais pilotés par des humains. Avec Opus 5 au même effort xhigh, le harnais Tycho, co-signé par les mêmes auteurs, atteint 100 sur chacun des vingt jeux, quand les harnais révisés de l’étude font 39,95 en moyenne (p. 8 ; annexe D, p. 18). VISTA, ainsi que AVO de NVIDIA, annoncent aussi 100 avec Opus 5.
Le bruit de mesure n’est pas négligeable. Dix évaluations du même harnais figé sur les mêmes vingt jeux donnent un écart type de 3,99 points (p. 6). Une variation de quelques points sur une lignée ne prouve donc rien.
Les limites
Les auteurs reconnaissent que (section 8, p. 9) :
- l’étude porte sur un seul banc d’essai, un seul jeu de cinq parties d’entraînement et deux révisions seulement ; rien ne dit comment se comporteraient dix ou vingt révisions ;
- les jeux sont publics, donc certains modèles ont pu les voir à l’entraînement ;
- trois lignées par profil laissent beaucoup d’incertitude sur les différences entre modèles, et chaque instantané n’est évalué qu’une fois ;
- le coût d’inférence varie selon le harnais et le modèle, ce qui empêche de séparer capacité du modèle, conception du harnais et dépense ;
- l’analyse des comportements de révision repose sur deux annotations faites par GPT-5.6 Sol, sans contrôle par des annotateurs humains, et ne montre que des associations.
Réserves de notre lecture, toutes tirées du papier :
- La comparaison avec Tycho, VISTA ou AVO n’isole pas l’effet du pilotage humain : Tycho a choisi sa politique sur les 25 jeux publics, y compris les vingt jeux de test de l’étude (annexe D, p. 18). Les auteurs le disent eux-mêmes.
- La moyenne cache des écarts énormes entre modèles. GPT-6 Astra dépasse 90 sur les jeux non vus, quand Sonnet 5 et Luna restent sous 2 (tableau 3, p. 16). Le résultat moyen dit donc peu de chose sur un modèle donné.
- Le gain de la règle « garder la meilleure version » est mesuré après coup ; les auteurs précisent qu’il reste à valider avec une règle fixée à l’avance.
- Le protocole interdit tout accès en direct au jeu pendant le codage : le modèle ne voit ses résultats qu’entre deux étapes, ce qui est plus dur que la façon dont un ingénieur itère.
Lecture Neurone21
Pour qui laisse un agent modifier son propre outillage, le message est net : un modèle sait écrire un harnais qui marche, il sait moins bien juger si sa modification améliore vraiment les choses. Les gains mesurés sur les cas qui ont servi à la correction surestiment le progrès réel de plus de cinq points, et la moitié des versions moins chères perdent en qualité. Concrètement, une équipe qui laisse un agent réécrire ses prompts, sa mémoire ou ses scripts doit garder un jeu de tests qu’il ne voit jamais, et comparer chaque nouvelle version à l’ancienne avant de la déployer. Le papier montre que cette simple discipline, garder la version la mieux notée, rapporte déjà plus que d’adopter systématiquement la dernière.
Le deuxième enseignement tient au coût. Une révision qui divise la facture par quatre peut aussi diviser le score par deux, comme la lignée Sol citée plus haut. Suivre la qualité et la dépense ensemble, et pas l’une après l’autre, évite de prendre une régression pour une optimisation. Cela rejoint notre fiche sur les agents auto-évolutifs qui apprennent en oubliant, où chaque amélioration pouvait effacer un acquis, et celle sur l’agent de terminal de Tencent, qui alternait réécriture et renforcement. Elle complète aussi la fiche sur le harnais orienté objet de Google : la conception du harnais compte autant que le modèle, mais elle reste aujourd’hui largement un travail humain.
Elvis Saravia résume correctement le chiffre central, 2,80 points, et l’intervalle qui inclut zéro. Il parle en revanche de « deux réécritures complètes » du harnais : le papier autorise le modèle à modifier tout le code, mais son audit montre qu’aucune lignée n’a changé de famille d’architecture, et que la plupart des révisions réorientent la stratégie plutôt qu’elles ne repartent de zéro.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.30499
- Le PDF : https://arxiv.org/pdf/2610.30499v1
- Un exemple de jeu ARC-AGI-3 (FT09), cité dans le papier : https://arcprize.org/tasks/ft09
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2114050042705379461