Titre original : Terminal-RSI: Recursive Self-Improving Terminal Agents via Recursive Self-Rewrite and Policy-Refine
Auteurs : Junyao Yang, Zongxia Li, Yucheng Shi (contribution égale), Zhongzhi Li, Ruhan Wang, Ruiwen Zhou, Haitao Mi, Shuicheng Yan (auteur correspondant), Leowei Liang
Affiliations : Tencent Hy Frontier, Université nationale de Singapour (NUS), Université du Maryland à College Park, Université de Géorgie, Université de l’Indiana.
Publication : déposé sur arXiv le 15 octobre 2026 (version 1).
Liens : page arXiv, PDF, code sur GitHub (licence Apache 2.0), poids sur Hugging Face, page du projet.
L’idée en bref
Un agent de terminal travaille en ligne de commande : il inspecte un dépôt, répare des dépendances, lance des programmes, et n’est jugé réussi que si un vérificateur protégé valide l’état final. L’entraîner est difficile pour deux raisons : beaucoup d’essais progressent localement sans jamais aboutir, et la récompense finale arrive tard. Terminal-RSI (pour recursive self-improvement, auto-amélioration récursive) alterne deux phases sur un même modèle, Qwen3.8-27B. La première, la réécriture (RSR), réentraîne le modèle de façon supervisée sur des versions réécrites et revérifiées de ses trajectoires réussies. La seconde, le raffinement (RPR), applique de l’apprentissage par renforcement PPO (une méthode qui ajuste le modèle à partir des récompenses, épaulée par un second réseau, le « critique », qui estime ce que vaut chaque situation). Le critique est transmis d’une phase à l’autre au lieu d’être réinitialisé.
Ce que montre le papier
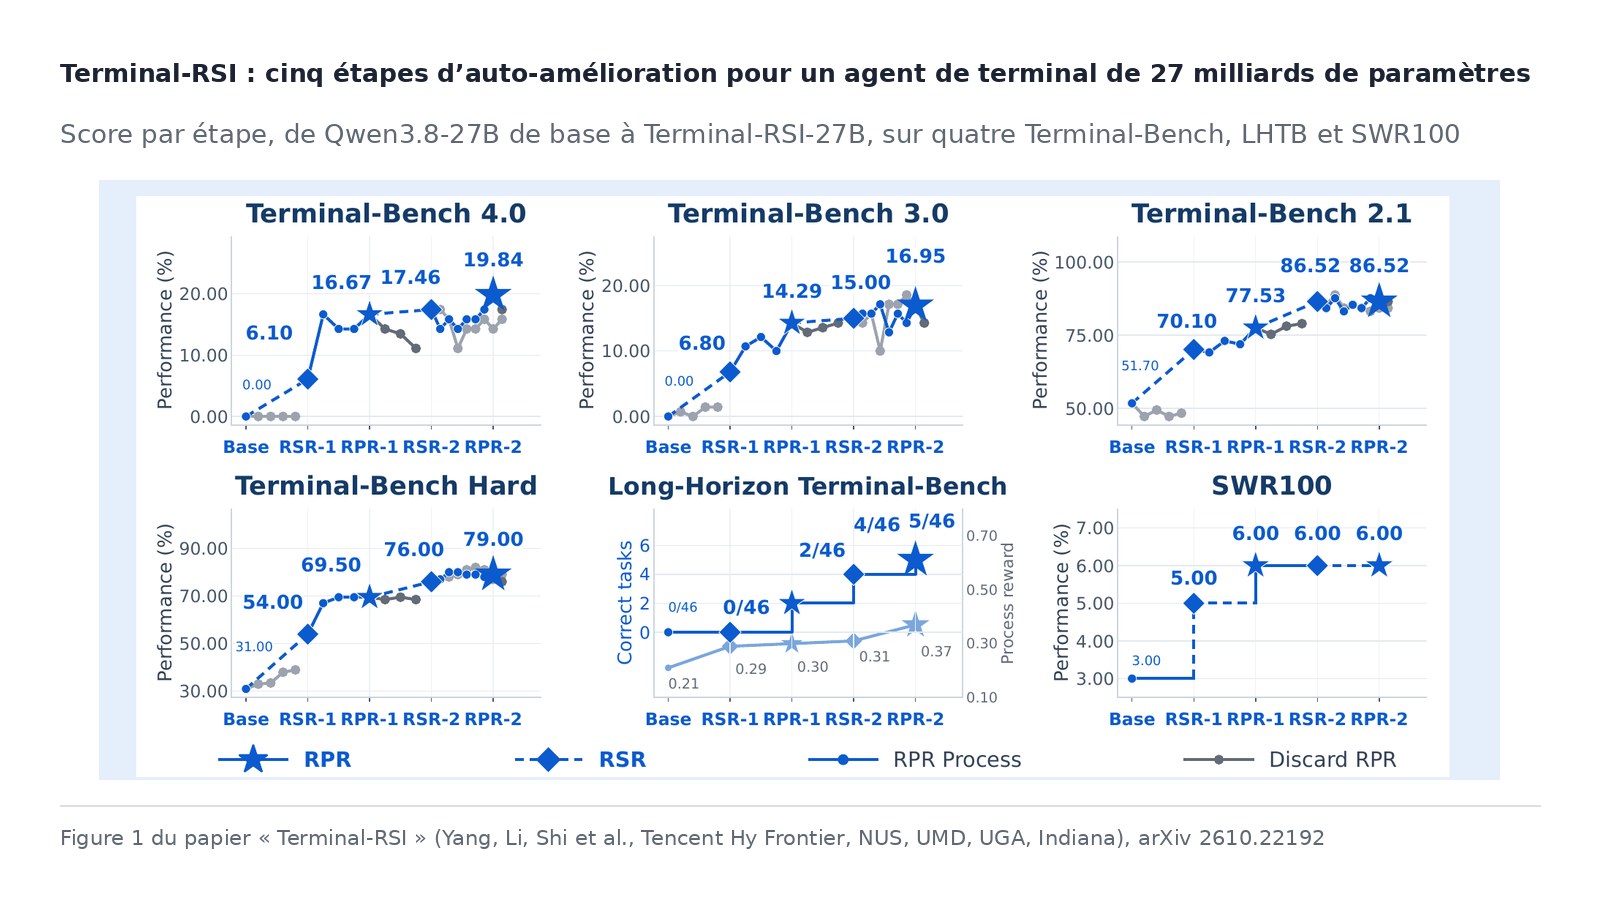
Cinq étapes, des gains à chaque fois. Base, RSR-1, RPR-1, RSR-2, RPR-2. Le modèle final, Terminal-RSI-27B, atteint en moyenne de trois évaluations (tableau 2) :
- Terminal-Bench 4.0 : de 0 % à 19,84 % ;
- Terminal-Bench 2.1 : de 51,70 % à 86,52 % ;
- Terminal-Bench 3.0 : de 0 % à 16,95 % ;
- Terminal-Bench Hard : de 31 % à 79 %.
La moyenne de ces quatre suites passe de 20,68 % à 50,58 %. Sur LHTB, un banc d’essai de tâches très longues, le modèle termine strictement 5 tâches sur 46 contre aucune au départ ; sur SWR100, tenu à l’écart des données d’entraînement, la réussite double, de 3 % à 6 %.
Commencer par la réécriture. Un PPO lancé directement sur le modèle de base progresse peu et ne résout aucune tâche de Terminal-Bench 4.0 ; après une première réécriture, le renforcement fait jusqu’à 29 points de mieux sur Terminal-Bench 2.1. Les auteurs précisent que cette comparaison n’est pas à calcul égal, la réécriture ayant son propre coût.
Un audit des récompenses. Avec une récompense « dense » qui paie chaque vérification partielle réussie, les trajectoires en échec raflaient 50,09 % de la récompense totale ; 48 d’entre elles passaient tous les contrôles exécutés mais rataient le test final. Une récompense qui sépare la réussite stricte du crédit partiel ramène cette part à 28,72 %. Ce chiffre vient d’un nouveau calcul sur des trajectoires déjà produites, pas d’un entraînement comparé.
Les limites
Les auteurs sont inhabituellement prudents (section 5 et annexes) :
- Pas d’attribution causale. Taux d’apprentissage, récompenses et initialisation changent ensemble d’une étape à l’autre ; il manque des comparaisons à budget égal pour savoir quel ingrédient fait quoi.
- Pas de graines multiples. Trois évaluations d’un même modèle mesurent la variabilité de l’inférence, pas celle de l’entraînement.
- Des décomptes à réconcilier. Le nombre de tâches de certaines suites diffère entre anciens et nouveaux relevés, et les scores des modèles concurrents cités sont des valeurs de référence dont la provenance n’est pas entièrement vérifiée.
- Un recouvrement partiellement audité entre données d’entraînement, dépôts publics et préentraînement.
- Un seul modèle, qui n’établit ni loi d’échelle ni progression garantie.
Lecture Neurone21
Le résultat intéresse ceux qui veulent un agent de code ouvert et de taille raisonnable : 27 milliards de paramètres, des poids publiés, et des scores qui, sur certains bancs d’essai, se comparent à ceux de modèles fermés bien plus gros, selon les valeurs de référence citées. C’est un argument pour les organisations qui préfèrent héberger leur propre agent.
L’enseignement le plus transférable est l’audit des récompenses : un signal qui paie la progression partielle peut récompenser des échecs presque aussi bien que des réussites. Toute équipe qui entraîne ou évalue des agents sur des contrôles intermédiaires devrait mesurer cette part avant de se fier à ses courbes. Le reste, très technique, demandera des réplications indépendantes.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.22192
- Le PDF : https://arxiv.org/pdf/2610.22192
- Le code : https://github.com/jyyang26/Terminal-RSI
- Les poids du modèle : https://huggingface.co/Teriminal-RSI
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2111487480281416004
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/terminal-rsi-recursive-self-improving-terminal-agents-via-recursive-self-rewrite-2610.22192