Titre original : Can LLM Agents Organize Their Own Memory?
Auteurs : Zichuan Fu et Junjia Qi (contribution égale), Wenlin Zhang, Yimin Deng, Shirong Wang, Jinyang Li, Xian Wu et Xiangyu Zhao (auteur de correspondance).
Affiliations : City University of Hong Kong (CityUHK) ; Xian Wu est chez Tencent Jarvis Lab.
Publication : prépublication arXiv 2611.11929v1 (cs.AI), déposée le 9 novembre 2026, avec le code en accès libre.
Liens : page arXiv, PDF, code.
L’idée en bref
Un modèle de langage ne change plus après son déploiement : ce qu’un agent apprend en travaillant, préférences d’un utilisateur, avancement d’une tâche, changements de contexte, doit être rangé dans une mémoire externe. La plupart des systèmes fixent d’avance la forme de cette mémoire, avec des types de fiches et des règles de regroupement. Les auteurs posent une question simple : l’agent peut-il organiser lui-même sa mémoire, avec des documents ordinaires ?
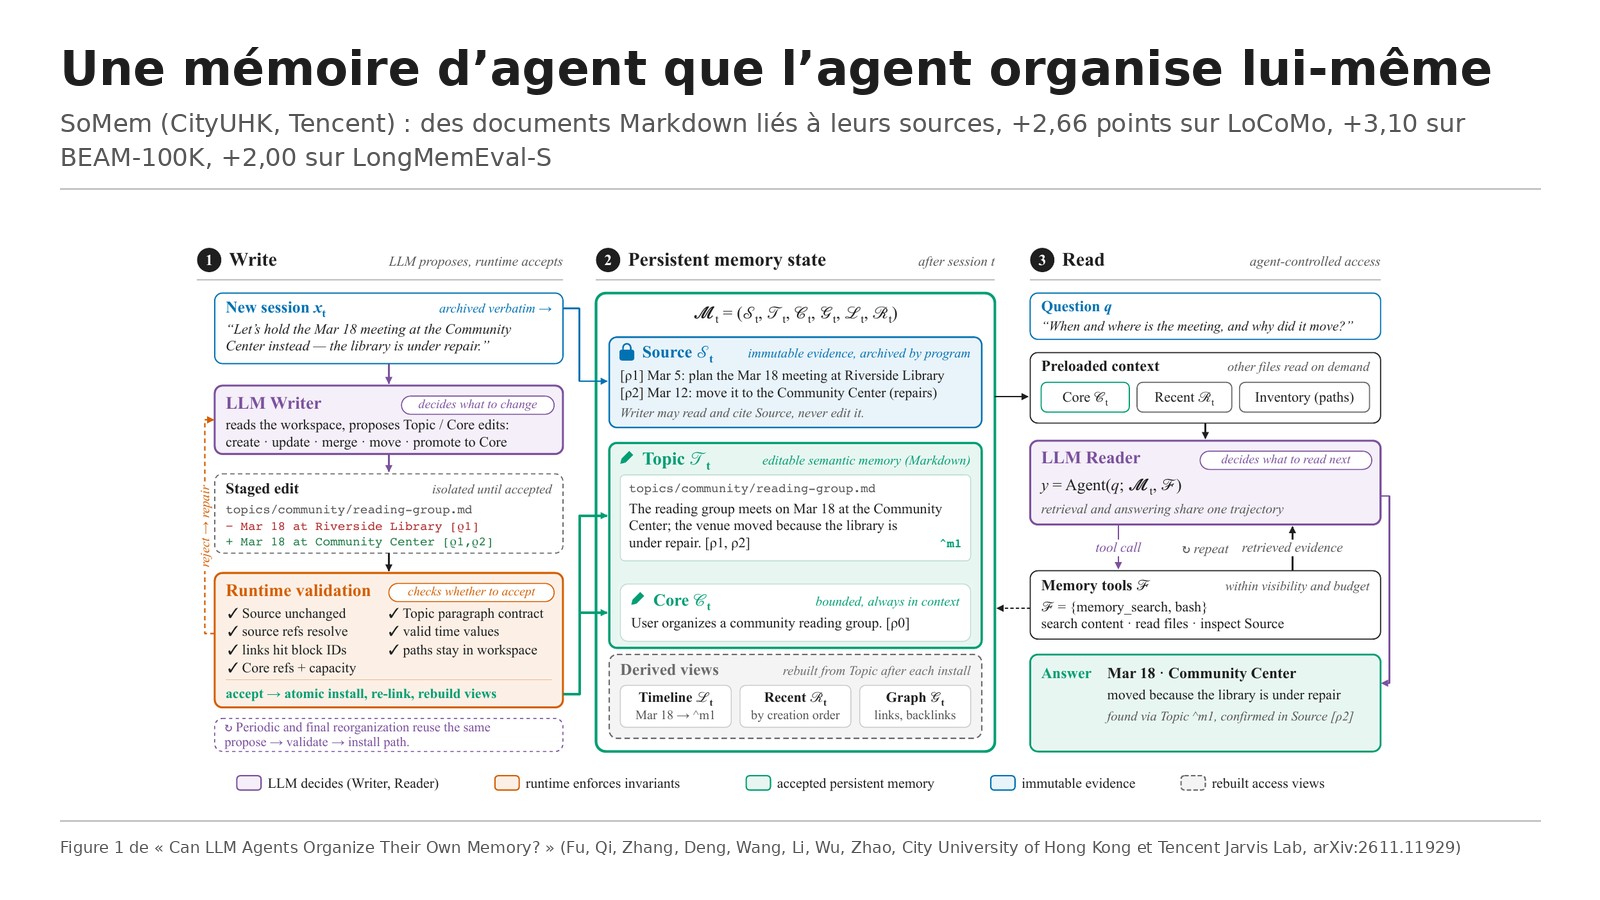
Leur réponse, SoMem (self-organized memory), confie au modèle le fond et au programme la cohérence. Chaque nouvel échange est archivé tel quel comme « source », que le modèle peut citer mais jamais modifier. Le modèle rédige et réorganise ensuite des documents thématiques en Markdown : il choisit les sujets, les titres, ce qu’il résume, ce qu’il fusionne ou déplace. Chaque phrase porte une date et un renvoi vers les échanges qui la justifient. Le programme vérifie chaque modification avant de l’accepter, puis reconstruit automatiquement trois vues : une chronologie, un graphe des liens entre paragraphes et la liste des souvenirs les plus récents. Au moment de répondre, l’agent cherche et lit ce dont il a besoin, et remonte aux sources quand le résumé ne suffit pas.
Ce que montre le papier
Le protocole
Toutes les méthodes comparées utilisent le même modèle, GPT-6 Luna, pour écrire la mémoire et pour répondre, sans effort de raisonnement supplémentaire. Les six systèmes de mémoire concurrents (A-Mem, Mem0, MemoryOS, Nemori, LightMem, E-mem) gardent leur propre organisation. Une septième référence, « Full Context », donne au modèle tout l’historique brut. Les réponses sont notées par un juge IA, GPT-4o-mini, à température nulle. Côté outils, l’agent dispose d’une recherche par mots-clés (BM25), d’une recherche sémantique par plongements, et de la lecture de fichiers.
Les scores
Sur LoCoMo (1 540 questions sur de longues conversations), SoMem atteint 88,96 % de bonnes réponses, contre 86,30 % pour E-mem, la meilleure référence, soit 2,66 points d’écart. Mem0 obtient 80,32 % et l’historique complet 84,22 %.
Sur BEAM-100K (400 questions, dix capacités de mémoire), SoMem obtient un score moyen de 54,02, contre 50,92 pour l’historique complet, soit 3,10 points. La meilleure méthode de mémoire, A-Mem, est à 50,51. En taux de questions réussies, SoMem monte à 61,50 % contre 55,75 % pour A-Mem. Ses points forts sont le raisonnement temporel, l’ordre des événements et le suivi de consignes données longtemps avant.
Sur LongMemEval-S (500 questions), SoMem atteint 76,50 % contre 74,50 % pour LightMem, soit 2,00 points, et 65,80 % pour l’historique complet.
Ce qui compte vraiment
Les auteurs retirent un à un les composants, mémoire gelée et modèle fixe. Sans les sources d’origine, le score sur LoCoMo tombe de 88,96 % à 80,32 %, soit 8,64 points de moins. Sans les documents thématiques, il perd 2,92 points. Le noyau toujours chargé, la chronologie, le graphe et les souvenirs récents déplacent chacun au plus 1,30 point, dans la marge d’incertitude. Autrement dit, ce sont les résumés et les preuves brutes, ensemble, qui font le résultat ; les vues dérivées aident surtout certaines questions, par exemple les questions de dates.
Une mémoire qui change de modèle
La mémoire construite par un modèle reste utilisable par un autre, sans reconstruction. Sur LoCoMo, une mémoire écrite par GPT-5.6 Luna donne entre 92,34 % et 93,25 % de bonnes réponses selon le modèle qui la lit (GPT-5.6 Luna, Gemini 3 Flash, DeepSeek V4 Flash ou Qwen 3.8 Flash). Les auteurs en concluent qu’on peut choisir séparément le modèle qui écrit et celui qui lit.
Le coût
C’est le revers. Sur l’ensemble de LoCoMo, SoMem coûte 229,73 dollars au tarif de référence, contre 6,75 dollars pour Mem0, 6,46 pour LightMem et 35,19 pour A-Mem. La construction, payée une fois, en représente 118,85 dollars ; chaque question coûte ensuite 0,07 dollar, avec 5,2 à 7,4 appels au modèle et une vingtaine de secondes par question. En facturant les entrées déjà en cache à 10 % du prix, le total descend à 96,33 dollars. Point notable : sur BEAM-100K, demander plus de raisonnement à GPT-6 Luna (de « High » à « xHigh ») fait monter le score de 59,07 à 61,79 tout en réduisant les jetons consommés, parce que l’agent cherche de façon plus ciblée.
Les limites
Les auteurs les écrivent eux-mêmes. Les bancs d’essai portent sur des questions posées à partir d’historiques de conversation, pas sur la personnalisation dans la durée ni sur l’exécution de tâches. La notation repose sur des juges IA sans calibrage humain systématique. Chaque condition des études de composants n’a tourné qu’une fois, et les analyses d’effort de raisonnement utilisent des sous-ensembles de 100 à 200 questions. Les niveaux d’effort n’ont pas le même sens d’un fournisseur à l’autre. Le programme vérifie la structure et les renvois, pas la justesse du contenu : une erreur ou un oubli du modèle peut rester dans la mémoire. Enfin, un déploiement réel demanderait des contrôles d’accès, une politique de conservation et une exécution isolée des outils.
Nos réserves : les gains sur les meilleures références restent de 2 à 3 points, pour une facture 34 fois supérieure à celle de Mem0 sur LoCoMo. Et sur BEAM-100K, la référence battue de 3,10 points est l’historique complet, pas une méthode de mémoire.
Lecture Neurone21
Pour une entreprise, l’intérêt tient moins aux points gagnés qu’à la forme de la mémoire. Des fichiers Markdown, datés, dont chaque phrase renvoie à l’échange d’origine, se lisent, s’auditent et se corrigent par un humain. Ils ne sont pas enfermés dans une base propriétaire, et le papier montre qu’on peut changer le modèle qui les lit sans tout reconstruire : un atout pour garder la main sur ses données et sur le choix de ses fournisseurs.
Le papier rejoint aussi un fil que nous suivons : garder les preuves brutes à côté des résumés. Retirer les sources fait perdre près de 9 points, bien plus que tout le reste. Avant d’adopter ce type de mémoire, il faut toutefois chiffrer la construction, qui pèse ici plus de la moitié de la facture, et vérifier que le volume de questions la rentabilise.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 12 novembre 2026 à 15:37 heure de Paris, en le qualifiant de lecture indispensable. Nous avons lu la version officielle arXiv 2611.11929v1. Écarts avec le post :
Les trois écarts annoncés (2,66, 3,10 et 2,00 points) sont exacts, mais sur BEAM-100K la meilleure référence est l’historique complet donné au modèle ; face à la meilleure méthode de mémoire, A-Mem, l’écart est de 3,51 points. Le post conseille d’essayer des notes liées « avant d’ajouter une base vectorielle » ; or SoMem utilise lui-même une recherche sémantique par plongements, en plus de la recherche par mots-clés, dans toutes ses expériences principales. La réutilisation de la mémoire par un autre modèle est confirmée, mais elle n’est mesurée que sur LoCoMo, avec trois modèles rédacteurs. Le post ne dit rien du coût, nettement plus élevé que celui des mémoires compactes.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.11929
- Le PDF : https://arxiv.org/pdf/2611.11929
- Le code : https://github.com/Qi202/SoMem
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2120888604402815485
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/can-llm-agents-organize-their-own-memory-2611.11929
- Notre fiche sur WikiTrace, une autre mémoire qui garde ses preuves : /p/wikitrace-memoire-agents-preuves-kaist
- Notre fiche sur MemoryTax, qui compare mémoire condensée et historique brut : /p/memoire-agents-memorytax