Titre original : Don’t Just Trust Your Memory: Evidence-Linked Memory Reduces Memory-Induced Degradation in LLM Agents
Auteurs : Yukyeong Lee et Yumin Choi (contribution égale), Jinheon Baek et Sung Ju Hwang (encadrement à parts égales).
Affiliations : KAIST et DeepAuto.ai.
Publication : prépublication arXiv 2611.14320v1 (cs.AI), déposée le 10 novembre 2026, avec le code en accès libre.
Liens : page arXiv, PDF, code.
L’idée en bref
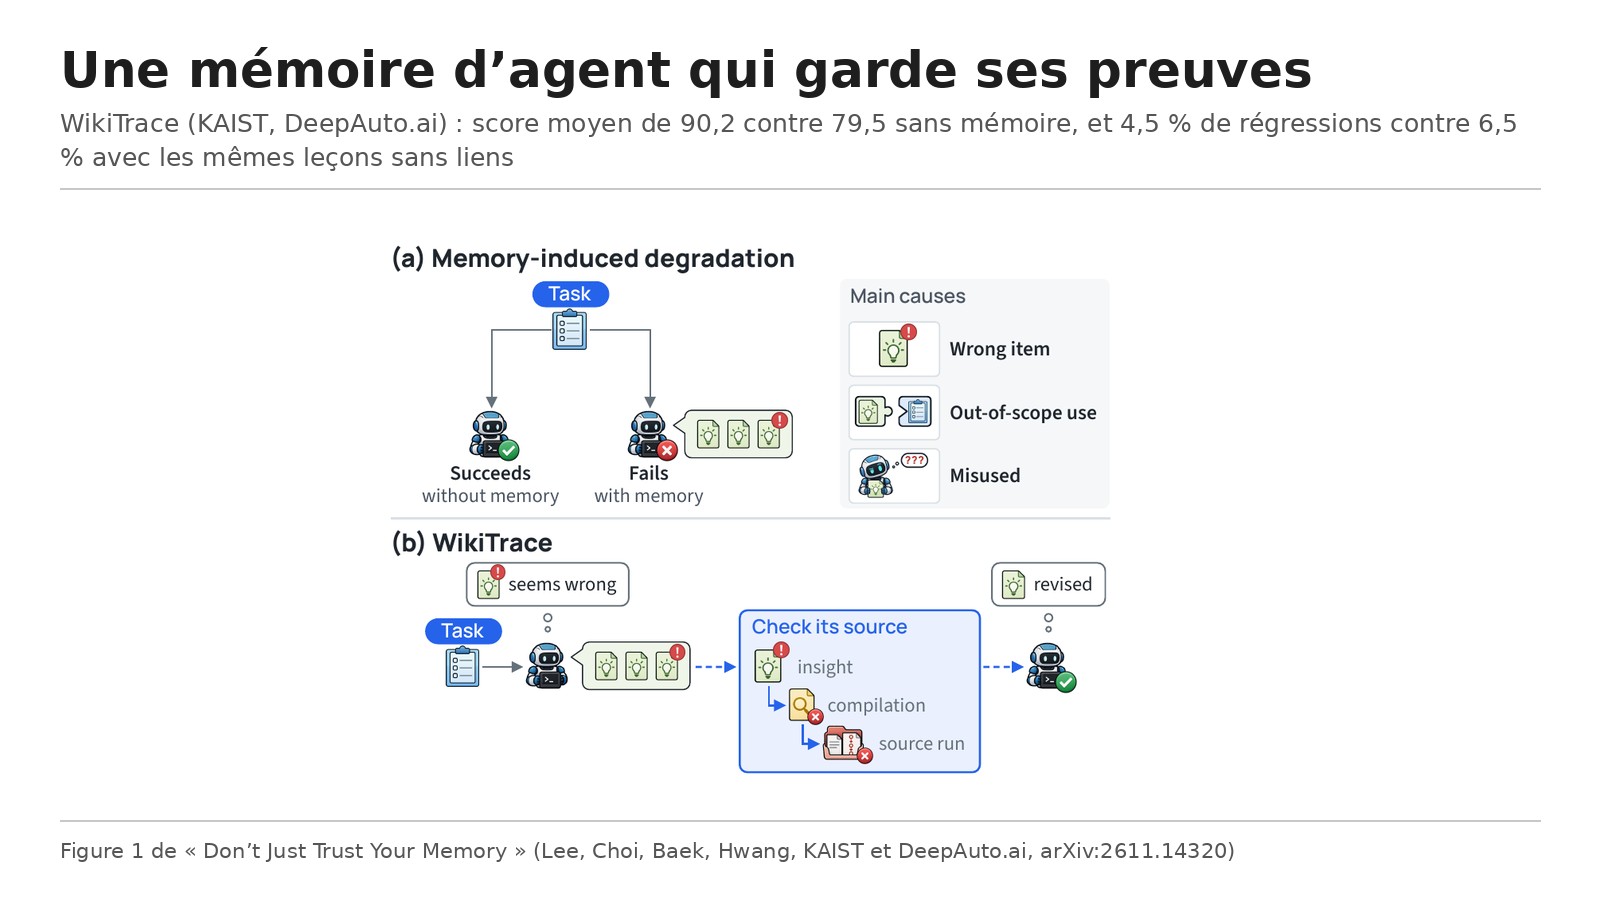
Beaucoup d’agents apprennent de leur expérience en résumant leurs essais passés en courtes leçons, qu’ils relisent avant une nouvelle tâche. Le problème, c’est qu’un essai ne porte qu’une étiquette, réussi ou raté, qui ne dit pas quelle action a fait la différence. La leçon tirée est donc une interprétation, parfois fausse. L’agent la suit quand même, et il rate des tâches qu’il réussissait sans mémoire. Les auteurs appellent cela la dégradation induite par la mémoire.
Leur réponse, WikiTrace, ne jette pas la source : chaque leçon renvoie à un résumé de l’essai qui l’a produite, puis à la trace brute de cet essai. Quand une leçon manque de détails, en contredit une autre ou vient d’un échec, l’agent va lire la source avec ses outils de terminal avant d’agir.
Ce que montre le papier
D’où viennent les échecs
Les auteurs ont isolé les tâches que l’agent réussit dans les trois essais sans mémoire mais rate avec. Un juge IA a comparé chaque échec à un essai sans mémoire. Dans 52 % des cas, l’échec remonte à un élément de mémoire que l’agent a suivi. Le cas le plus courant, 20 %, est une leçon fausse ; viennent ensuite une leçon juste appliquée hors de son champ, une leçon mal lue, ou une meilleure leçon ignorée.
Les scores
Le protocole est le même pour toutes les méthodes : la mémoire est construite une fois à partir des mêmes essais sans mémoire, sans essai de validation, avec le même agent et le modèle deepseek-v4-flash. Sur huit suites issues de cinq bancs d’essai (ALFWorld, ScienceWorld, PlanCraft, AppWorld et τ3-bench Retail), WikiTrace obtient le meilleur score partout, avec 90,2 en moyenne contre 79,5 sans mémoire. Les trois méthodes de mémoire existantes testées (AWM, ExpeL, ReasoningBank) plafonnent entre 80,3 et 81,7. Avec exactement les mêmes leçons mais sans les liens vers les sources, on obtient 87,0.
Moins de régressions
Le papier sépare deux taux : le gain, quand la mémoire transforme un échec en réussite, et la régression, l’inverse. WikiTrace descend à 4,5 % de régressions, contre 6,5 % pour les leçons seules et 9,7 % pour un simple nouvel essai sans mémoire, qui varie lui aussi d’une fois sur l’autre. Son gain dépasse celui de ce nouvel essai de 35 points, contre 27 pour les leçons seules et 7 à 14 pour les méthodes existantes.
L’agent consulte les sources dans 22 % des essais sur les tâches faciles et 44 % sur les difficiles. Quand il le fait, la source change son plan dans 43 % des cas. À l’usage, WikiTrace coûte 1,17 fois le prix des leçons seules par tâche. Avec un autre modèle, GLM-5.3-flash, sur trois suites, il atteint 92,7 contre 90,9 pour les leçons seules et 71,2 sans mémoire.
Les limites
Les auteurs les écrivent eux-mêmes. Le lien vers la source permet de vérifier une leçon, pas de la prouver : le diagnostic d’un échec reste une interprétation. Toutes les leçons sont placées dans le premier message, si bien que le prompt grossit avec la mémoire ; une mémoire trop grande demanderait un système de recherche que le papier ne traite pas. Les causes d’échec et les raisons de consulter les sources sont classées par un juge IA qui lit le raisonnement de l’agent, ce qui décrit ce que l’agent dit, pas forcément ce qui a causé le résultat. Les bancs d’essai sont des mondes textuels et des environnements d’outils simulés.
Lecture Neurone21
Pour une entreprise qui ajoute de la mémoire à ses agents, deux réflexes ressortent. D’abord, mesurer les régressions à part : une moyenne qui monte peut cacher des tâches qui marchaient et ne marchent plus. Ensuite, garder la trace de l’essai qui a produit chaque règle mémorisée, au lieu de ne conserver qu’un résumé. C’est ce qui permet à l’agent, et à l’humain qui l’audite, de retrouver pourquoi une règle existe et de la corriger.
Le papier rejoint plusieurs travaux déjà présentés ici : une mémoire qui condense trop perd l’information qui permet de la remettre en cause.
D’où vient ce papier
DAIR.AI (@dair_ai) l’a présenté le 11 novembre 2026 à 15:25 heure de Paris, et Elvis Saravia (@omarsar0) a reposté ce post à 15:38. Nous avons lu la version officielle arXiv 2611.14320v1. Écarts avec le post :
Le post présente le travail comme celui de chercheurs du KAIST ; le papier associe aussi DeepAuto.ai. Le passage visible du post décrit le problème sans chiffres. Il faut savoir que la baisse des régressions reste modeste en valeur absolue, de 6,5 % à 4,5 %, et que tous les essais principaux reposent sur un seul modèle, deepseek-v4-flash.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.14320
- Le PDF : https://arxiv.org/pdf/2611.14320
- Le code : https://github.com/yukyeongleee/wikitrace
- Le post de DAIR.AI reposté par Elvis Saravia : https://x.com/dair_ai/status/2120523196072161401
- Notre fiche sur MemoryTax, qui compare mémoire condensée et historique brut : /p/memoire-agents-memorytax