Titre original : Harness Learning Enables Generalizable Test-Time Adaptation
Auteurs : Alvin Zhang, Xuecheng Liu, Zixuan Wang, Fahim Tajwar, Daman Arora, Ruslan Salakhutdinov, Daniel Khashabi, Yuda Song, Andrea Zanette
Affiliations : non indiquées en tête du papier. Les remerciements citent les moyens de calcul de Carnegie Mellon (centre FLAME, cluster Babel) et de Johns Hopkins ; le post d’Elvis Saravia présente le travail comme venant de CMU.
Publication : déposé sur arXiv le 28 septembre 2026 (version 1), 36 pages.
Liens : page arXiv, PDF. Aucun code ni page de projet n’est indiqué dans le papier.
L’idée en bref
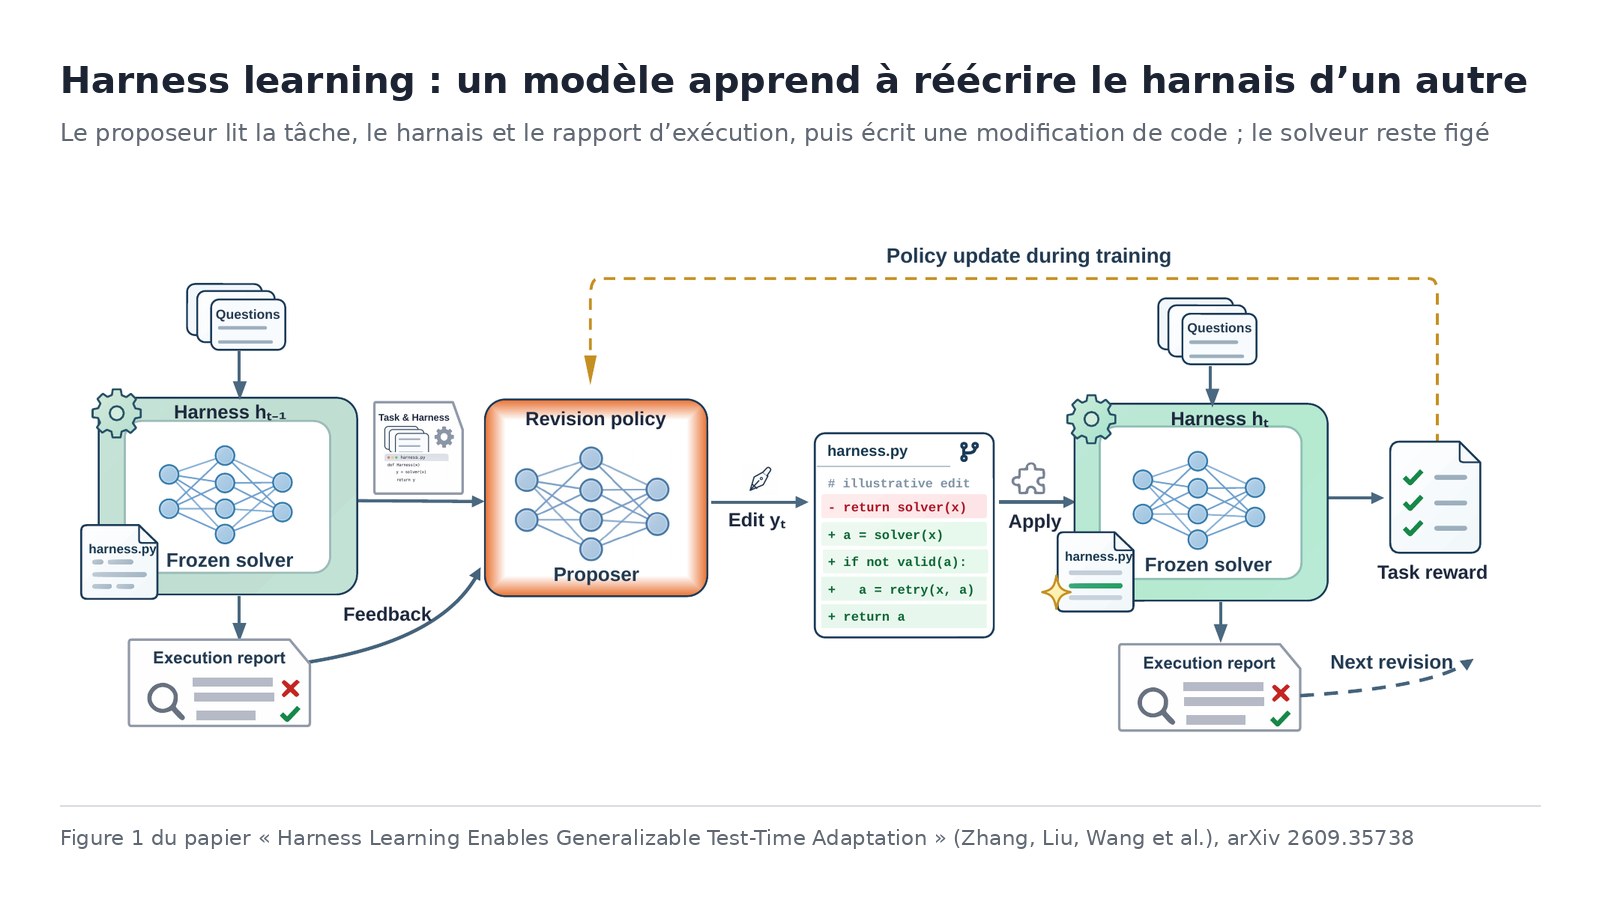
Un agent fondé sur un modèle de langage, c’est un modèle plus un « harnais » : le programme qui organise ses appels, ses outils et la circulation de l’information. Changer le harnais peut améliorer nettement un agent sans modifier le modèle. Elvis Saravia y voit une compétence d’ingénierie montante : améliorer un agent en éditant son harnais plutôt que ses poids.
Les auteurs automatisent ce travail. Un modèle « proposeur » lit la description de la tâche, le code actuel du harnais et un rapport d’exécution, puis écrit une modification de code, par exemple ajouter une vérification de la réponse et une nouvelle tentative en cas d’échec. Le modèle qui résout la tâche, le « solveur », reste figé. Le proposeur est entraîné par apprentissage par renforcement : sa récompense est le score obtenu par le harnais révisé. Les auteurs y voient une forme de méta-apprentissage (apprendre à apprendre), où la révision du harnais joue le rôle d’une mise à jour des poids.
Ce que montre le papier
Sur Reasoning Gym, une collection de familles de problèmes de raisonnement générés automatiquement. Le proposeur et le solveur sont des Qwen3.5-4B. Le proposeur est d’abord entraîné à imiter les révisions d’un professeur de 35 milliards de paramètres (Qwen3.6-35B-A3B), puis par renforcement. Sur 21 familles exclues de tout entraînement, la note moyenne d’une révision unique passe de 0,32 pour le modèle de départ à 0,62. Le professeur obtient 0,56 : le petit proposeur le dépasse en moyenne. Nuance absente du post : en retenant la meilleure de huit propositions, c’est le professeur qui l’emporte.
Sur les questions à plusieurs étapes. Un proposeur Qwen3-4B, entraîné sur HotpotQA pour améliorer le harnais d’un solveur Qwen3-8B, continue d’améliorer les harnais sur deux tests jamais vus, MuSiQue et 2WikiMultihopQA. Sur MuSiQue, une révision isolée ne fait guère mieux que le harnais de départ (0,15 de bonnes réponses exactes en moyenne), mais dix révisions successives atteignent 0,27. Sur les deux tests inédits, la moyenne des parcours finaux dépasse même la meilleure de 80 révisions indépendantes, à nombre de propositions égal mais sans égaliser le calcul total.
Entraîner sur des séquences n’aide pas toujours. Entraîner le proposeur sur des enchaînements de révisions n’apporte pas de gain constant : un entraînement sur des révisions isolées suffit déjà à produire des améliorations successives.
Les limites
- Un seul professeur de 35 milliards pour la phase d’imitation sur Reasoning Gym, et des consignes de révision imposées.
- Un solveur figé : le papier ne teste pas l’entraînement conjoint du proposeur et du solveur.
- Un proposeur qui ne mène pas sa propre enquête : il reçoit un rapport d’exécution tout fait, sans pouvoir inspecter le code ou lancer des tests ciblés.
- Des tâches courtes et académiques (raisonnement, questions-réponses) ; les longues séquences d’outils restent à étudier, selon les auteurs.
- Des gains mesurés en moyenne, avec des différences selon les familles de tâches détaillées en annexe.
Lecture Neurone21
Ce travail illustre un déplacement que Neurone21 suit de près : une partie de la performance des agents se joue dans le code qui les entoure, et ce code peut lui-même être optimisé par un modèle. L’intérêt pratique est réel pour des équipes qui ne peuvent pas réentraîner un grand modèle : un petit modèle spécialisé, peu coûteux, pourrait ajuster le harnais d’un agent à chaque nouvelle tâche.
Prudence toutefois : les résultats portent sur des tests de recherche, avec de petits modèles, et le code n’est pas publié. L’application à des harnais d’entreprise, plus longs et plus complexes, reste à démontrer.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2609.35738
- Le PDF : https://arxiv.org/pdf/2609.35738
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2106529236068819394
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/harness-learning-enables-generalizable-test-time-adaptation-2609.35738