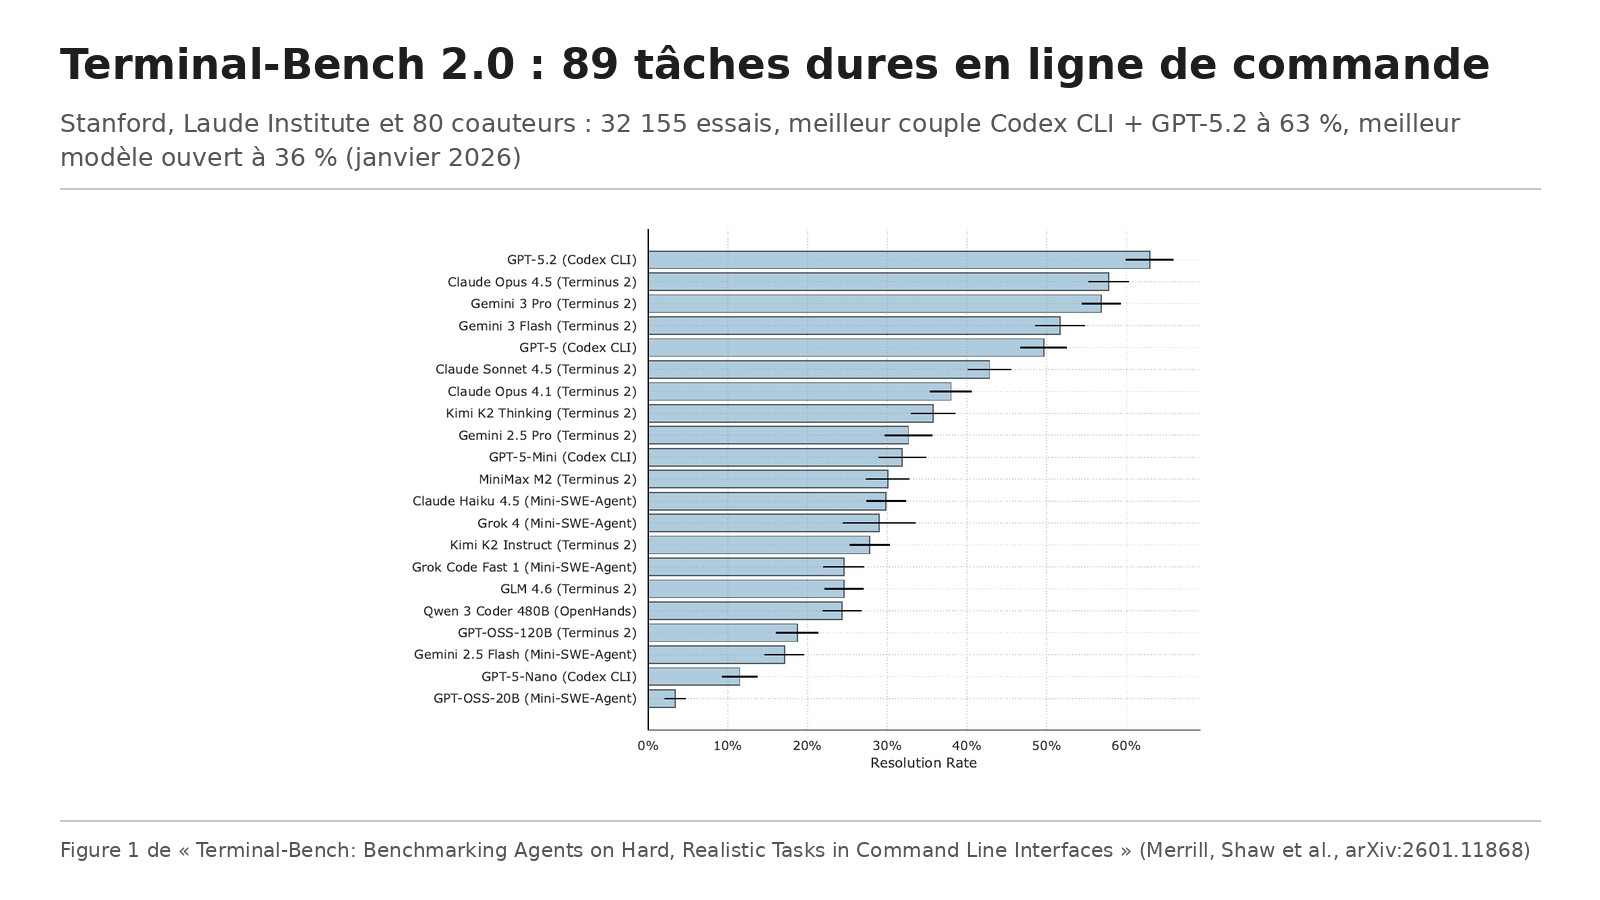
Titre original : Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces
Auteurs : Mike A. Merrill et Alexander G. Shaw (premiers auteurs, contribution égale), Nicholas Carlini et près de 80 coauteurs, dont Niklas Muennighoff, Alex Dimakis et Andy Konwinski.
Affiliations : Stanford University et Laude Institute en tête, avec Anthropic, Carnegie Mellon, le MIT, Berkeley, l’Allen Institute for AI, LAION, Moonshot AI, Amazon et une quarantaine d’autres institutions.
Publication : prépublication déposée sur arXiv le 17 janvier 2026 (2601.11868v1, 84 pages avec annexes). Jeu de tâches et harnais d’évaluation (Harbor) publiés, classement à jour sur tbench.ai.
Liens : page arXiv, PDF, site et classement, données des expériences.
L’idée en bref
Le terminal est l’outil de base des agents de code (Claude Code, Codex CLI, Gemini CLI, Cursor). Les auteurs reprochent aux benchmarks existants d’être soit trop éloignés du travail réel, soit trop faciles pour départager les modèles de pointe. Terminal-Bench 2.0 vise les deux à la fois : des tâches réalistes et difficiles, mais vérifiables automatiquement.
Chaque tâche comprend une consigne, une image Docker, une solution de référence écrite par un humain, une limite de temps et des tests. Les tests vérifient l’état final du conteneur, pas les commandes tapées : l’agent est libre de sa méthode. Les tâches vont de l’entraînement d’un modèle à la compilation de Linux depuis les sources, en passant par la rétroconception de binaires ou la réécriture d’un programme COBOL en Python. L’une d’elles, réparer le ramasse-miettes d’OCaml après une optimisation ratée, est estimée à près d’une journée pour un expert et dix jours pour un débutant.
Ce que montre le papier
Un tri sévère
Le jeu est participatif : 93 contributeurs ont proposé 229 tâches, 89 ont été retenues. Chaque tâche passe par une série de contrôles : la solution de référence doit réussir les tests, un agent qui ne fait rien doit échouer, l’auteur remplit une liste de vérification, un outil à base de LLM cherche les erreurs courantes, des relecteurs expérimentés revoient la tâche, plusieurs modèles la tentent (et chaque échec est examiné pour savoir s’il vient du modèle ou de la tâche), puis un agent « tricheur » cherche des failles avant deux derniers auditeurs. En moyenne, une tâche a reçu environ trois heures de relecture humaine, soit plusieurs centaines d’heures au total.
Aucun agent au-dessus de 65 %
Les auteurs évaluent six agents (Claude Code, Codex CLI, Gemini CLI, OpenHands, Mini-SWE-Agent et leur propre harnais minimal, Terminus 2) avec 16 modèles, chaque combinaison au moins cinq fois : 32 155 essais au total. En tête, Codex CLI avec GPT-5.2 résout 63 % des tâches en moyenne, devant Terminus 2 avec Claude Opus 4.5 (58 %) et avec Gemini 3 Pro (57 %). Les modèles propriétaires occupent les 13 premières places ; le meilleur modèle ouvert, Kimi K2 Thinking avec Terminus 2, plafonne à 36 %. Les petits modèles tournent autour de 15 %, et certaines tâches n’ont été résolues par personne.
Le choix du modèle pèse plus que celui du harnais : Codex CLI gagne 52 points en passant de GPT-5-Nano à GPT-5.2, quand Gemini 2.5 Pro ne gagne que 17 points en changeant de harnais (Terminus 2 au lieu d’OpenHands). Un passage complet coûte de 1 à 100 dollars selon le prix du modèle. La plupart des tentatives durent moins de 20 minutes, mais certaines vont jusqu’à deux heures et près de 100 millions de tokens pour une seule tâche. Ni le nombre de tours ni le nombre de tokens ne sont corrélés au succès.
Pourquoi les agents échouent
Sur des échecs annotés (deux par tâche et par modèle, juge GPT-5 validé à 90 % d’accord avec des annotations humaines sur 120 traces), les erreurs d’exécution dominent pour Claude Opus 4.5 et GPT-5.2, devant les erreurs de cohérence et de vérification. Le modèle ouvert Qwen Coder échoue de façon plus répartie. Sur 3 800 commandes ratées, la cause la plus fréquente est banale : appeler un programme absent ou hors du chemin d’exécution (24,1 %), devant les erreurs pendant l’exécution d’un programme (9,6 %).
Un banc qui pourrait vieillir vite
Entre la sortie de Gemini 2.5 Pro et celle de GPT-5.2, soit huit mois, le meilleur score a presque doublé. Les auteurs reconnaissent que Terminal-Bench 2.0 pourrait être saturé dans l’année et prévoient de nouveaux jeux de tâches plus durs.
Les limites
Les auteurs le disent : les agents ont accès à internet pour installer des paquets, donc ils pourraient en théorie trouver les solutions en ligne (comportement non observé sur des dizaines de milliers de trajectoires). Le jeu étant public, des éditeurs pourraient s’entraîner dessus ; une chaîne « canari » aide à le détecter, mais il n’y a pas de jeu de test privé. Internet et les ressources des machines rendent la reproduction imparfaite. Enfin, malgré l’audit, certaines tâches peuvent rester défectueuses.
Nos réserves : les chiffres datent de janvier 2026 et des modèles de l’époque ; les classements ont bougé depuis, d’où l’intérêt de consulter tbench.ai. Le harnais Terminus 2 et une partie des tâches viennent des auteurs eux-mêmes, et la difficulté « empirique » est calculée avec ce même harnais.
Lecture Neurone21
Terminal-Bench est un bon modèle pour construire ses propres tests d’agents en entreprise : un environnement propre par tâche, une solution connue, un test qui vérifie le résultat et pas le chemin. Il rappelle aussi qu’avant de payer un harnais, mieux vaut choisir le bon modèle, et que les erreurs les plus fréquentes sont souvent bêtes (un outil absent de l’environnement), donc évitables par une bonne préparation de l’environnement de travail.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a placé en deuxième (« Test Realistic Tasks ») dans son article X « My Top 10 Eval Papers of 2026 », publié le 16 novembre 2026 à 15:17 heure de Paris, qu’il a ensuite cité et reposté le même jour. Nous avons lu la version officielle arXiv 2601.11868v1. Écarts avec l’article :
Les chiffres de l’article sont ceux du papier (89 tâches, conteneur, solution humaine, tests sur l’état final, moins de 65 % à la sortie). Il ne précise pas qu’il s’agit de la version 2.0 du banc ni que le meilleur score, 63 %, date de janvier 2026 avec les modèles d’alors.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2601.11868
- Le PDF : https://arxiv.org/pdf/2601.11868
- Le classement à jour : https://tbench.ai
- Les données des expériences : https://github.com/laude-institute/terminal-bench-experiments
- L’article d’Elvis Saravia « My Top 10 Eval Papers of 2026 » : https://x.com/omarsar0/status/2122333324895035868
- Notre fiche sur la saturation des benchmarks : /p/saturation-benchmarks-ia-60-bancs-icml
- Notre fiche sur SkillsBench, qui mesure l’apport des Skills sur des tâches du même type : /p/skillsbench-skills-agents-evaluation-appariee