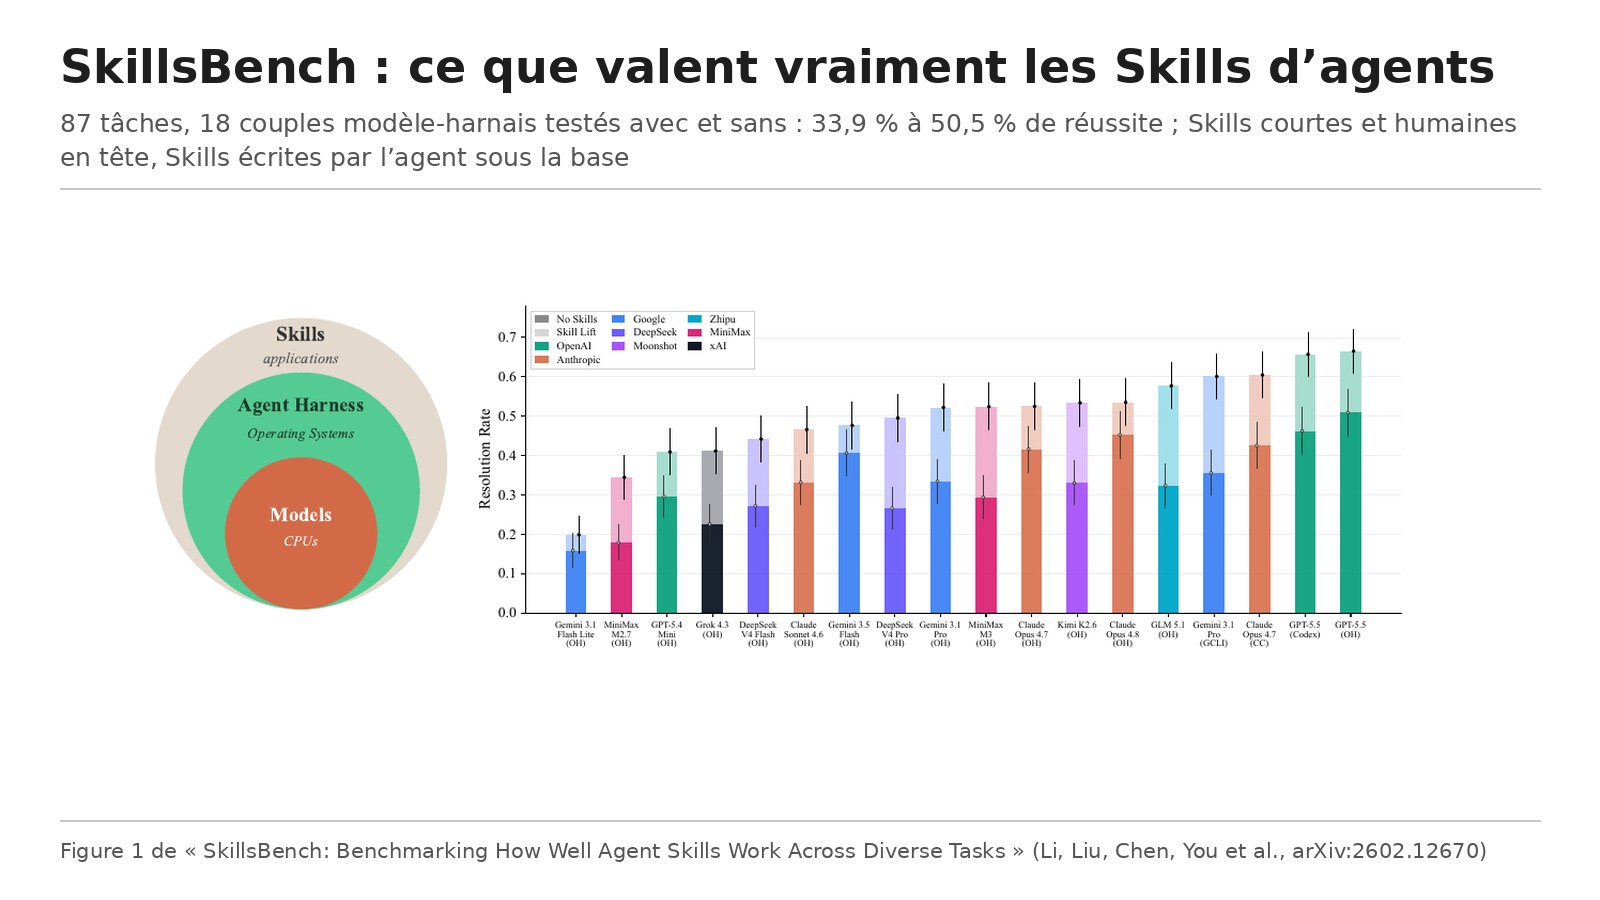
Titre original : SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks
Auteurs : Xiangyi Li (auteur correspondant), Yimin Liu, Wenbo Chen et Bingran You (contribution égale), avec près de 90 coauteurs, dont Xuandong Zhao et Dawn Song.
Affiliations : BenchFlow en tête, avec UC Berkeley, Ohio State, Amazon (travail mené hors du rôle des auteurs concernés), Stanford, Carnegie Mellon, Princeton, Oxford, ByteDance, Foxconn, Snap et une trentaine d’autres institutions.
Publication : déposé sur arXiv le 13 février 2026 ; nous avons lu la version 4 du 14 juin 2026 (2602.12670v4), qui porte sur l’inventaire actuel de 87 tâches. Pas de relecture par des pairs mentionnée.
Liens : page arXiv, PDF.
L’idée en bref
Les Skills sont des paquets de savoir-faire (instructions, procédures, scripts) qu’un agent charge au moment où il en a besoin, sans toucher aux poids du modèle. Anthropic les a popularisées et elles se sont répandues vite. Mais personne ne mesurait sérieusement si elles aident.
La réponse de SkillsBench tient en un principe : la comparaison appariée. Chaque tâche est jouée deux fois dans les mêmes conditions, une fois sans Skills et une fois avec des Skills choisies par des humains, et seul l’écart compte. Pour que la mesure ait un sens, les Skills doivent apporter de l’expertise, pas la réponse : elles sont écrites indépendamment des tâches (dépôts publics, expérience métier) et filtrées pour ne pas contenir de solution.
Ce que montre le papier
Un tri sévère pour 87 tâches
Les 87 tâches viennent de 400 propositions faites par 142 contributeurs, filtrées par des contrôles automatiques et une relecture humaine. Chacune tourne dans un conteneur avec des données fixes, une solution de référence et un vérificateur déterministe. Elles couvrent huit domaines (de 5 à 16 tâches chacun), avec 28 tâches jugées extrêmes, de plus de quatre heures de travail humain. Les 18 couples modèle-harnais ont été évalués sur la plateforme BenchFlow, avec trois essais par tâche et par condition, soit 9 396 fichiers de résultats publics.
Un gain réel mais très variable
En moyenne, les Skills font passer le taux de réussite de 33,9 % à 50,5 %, soit 16,6 points (25,5 % du chemin restant vers 100 %). Les 18 couples progressent tous, mais l’écart va de 4,1 points (OpenHands avec Gemini 3.1 Flash Lite) à 25,7 points (OpenHands avec GLM 5.1). Les meilleurs scores absolus avec Skills sont ceux d’OpenHands avec GPT-5.5 (67,3 %), de Codex avec GPT-5.5 (66,5 %) et de Claude Code avec Claude Opus 4.7 (61,2 %). Les plus gros gains ne vont pas aux plus forts : Gemini 3.5 Flash, parti de 41,1 % sans Skills, ne gagne que 7,1 points.
Le harnais change la donne pour un même modèle : Gemini 3.1 Pro atteint 60,8 % avec Gemini CLI mais 52,8 % avec OpenHands ; Claude Opus 4.7, 61,2 % avec Claude Code contre 53,1 % avec OpenHands.
Les Skills écrites par l’agent font pire que rien
Sur trois couples, les auteurs ont aussi laissé l’agent écrire lui-même ses Skills (avec l’outil skill-creator d’Anthropic) avant de résoudre la tâche. Résultat : sous le niveau sans Skills dans les trois cas (−8,1 points pour Claude Code avec Opus 4.7, −11,3 pour Codex avec GPT-5.5, −11,5 pour Gemini CLI avec Gemini 3.1 Pro), alors que les Skills humaines apportent de +18,2 à +24,8 points sur les mêmes couples. Les causes relevées : des paquets que l’agent ne retrouve pas, du temps perdu à écrire au lieu de résoudre, et des contenus faux mais assurés.
Courtes et ciblées
Le gain dépend du domaine : +28,8 points en sciences naturelles, +24,1 en production de médias, +18,9 en cybersécurité, mais seulement +11,6 en génie logiciel et +9,7 en mathématiques et recherche opérationnelle, des domaines déjà bien couverts par l’entraînement des modèles. Treize tâches sur 87 reculent avec les Skills (jusqu’à −7,4 points), quand la Skill impose une chaîne trop lourde, remplace une meilleure stratégie par défaut ou pointe vers un outil que l’agent ne sait pas déboguer.
Le format compte : une seule Skill par tâche rapporte +18,0 points, deux ou trois +19,0, quatre ou plus seulement +10,1. Côté longueur, les Skills compactes (+19,0) ou standard (+21,5) battent les détaillées (+14,5) et les documentations exhaustives (+0,7). Enfin, un modèle plus petit équipé de Skills peut dépasser un plus gros sans : MiniMax M2.7 avec Skills (34,9 %) passe devant GLM 5.1 sans Skills (32,7 %).
Les limites
Les auteurs le disent : les tâches sont toutes en terminal et en conteneur, donc les résultats ne se transposent pas forcément aux agents graphiques, aux systèmes multi-agents ou aux travaux très longs. L’ensemble des modèles et harnais est limité et évolue vite. Surtout, ajouter une Skill allonge le contexte : une partie du gain pourrait venir du simple fait d’avoir plus de texte, faute de témoin de même longueur (texte aléatoire, documentation brute).
Nos réserves : BenchFlow, qui mène le projet, est aussi la plateforme sur laquelle tournent les évaluations. Le papier a connu quatre versions entre février et juin 2026 : les chiffres cités ici sont ceux de la quatrième.
Lecture Neurone21
Pour une entreprise qui déploie des agents, le message est concret : avant de généraliser une Skill, une consigne ou un outil, il faut le tester sur ses propres tâches, avec et sans, sur le couple modèle-harnais réellement utilisé. Le gain moyen ne dit rien du vôtre. Et les meilleures Skills sont courtes, procédurales et écrites par quelqu’un qui connaît le métier ; laisser l’agent rédiger ses propres procédures n’est pas un raccourci.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a placé en troisième (« Run Paired Comparisons ») dans son article X « My Top 10 Eval Papers of 2026 », publié le 16 novembre 2026 à 15:17 heure de Paris, qu’il a ensuite cité et reposté le même jour. C’est aussi l’habitude qu’il recommande en premier. Nous avons lu la version officielle arXiv 2602.12670v4. Écarts avec l’article :
Les chiffres sont ceux de la version 4 (87 tâches, 18 couples, 33,9 % à 50,5 %, gain de 4,1 à 25,7 points). « Les Skills courtes à trois parties au plus marchent mieux » mélange deux constats du papier : le nombre de Skills par tâche (une à trois font mieux que quatre ou plus) et leur longueur (compactes ou standard plutôt qu’exhaustives). L’article ne mentionne pas le résultat négatif des Skills générées par l’agent.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2602.12670
- Le PDF : https://arxiv.org/pdf/2602.12670
- L’article d’Elvis Saravia « My Top 10 Eval Papers of 2026 » : https://x.com/omarsar0/status/2122333324895035868
- Notre fiche sur Terminal-Bench 2.0, un banc de tâches en terminal construit selon le même principe : /p/terminal-bench-2-agents-terminal-89-taches
- Notre fiche sur Claw-Eval, qui note aussi le déroulé des tâches d’agents : /p/claw-eval-trajectoires-agents-securite