Titre original : Claw-Eval: Towards Trustworthy Evaluation of Autonomous Agents
Auteurs : Bowen Ye et Rang Li (contribution égale), Qibin Yang, Yuanxin Liu, Linli Yao, Hanglong Lv, Zhihui Xie, Chenxin An, Lei Li (chef de projet), Lingpeng Kong, Qi Liu, Zhifang Sui et Tong Yang.
Affiliations : Peking University (laboratoire national de traitement de l’information multimédia, école d’informatique) et The University of Hong Kong.
Publication : déposé sur arXiv le 7 avril 2026 ; nous avons lu la version 3 du 7 mai 2026 (2604.06132v3, 24 pages). Code, données et classement publics.
Liens : page arXiv, PDF, site et classement.
L’idée en bref
Les agents travaillent désormais dans de vrais logiciels : ils appellent des outils, modifient des fichiers, interrogent des bases. Les auteurs reprochent aux benchmarks d’agents trois lacunes. Beaucoup ne vérifient que le résultat final, sans regarder comment l’agent y est arrivé, ce qui laisse passer les raccourcis et les tricheries. La sécurité et la résistance aux pannes sont rarement intégrées dans des tâches ordinaires. Et chaque banc ne couvre qu’un type d’interaction.
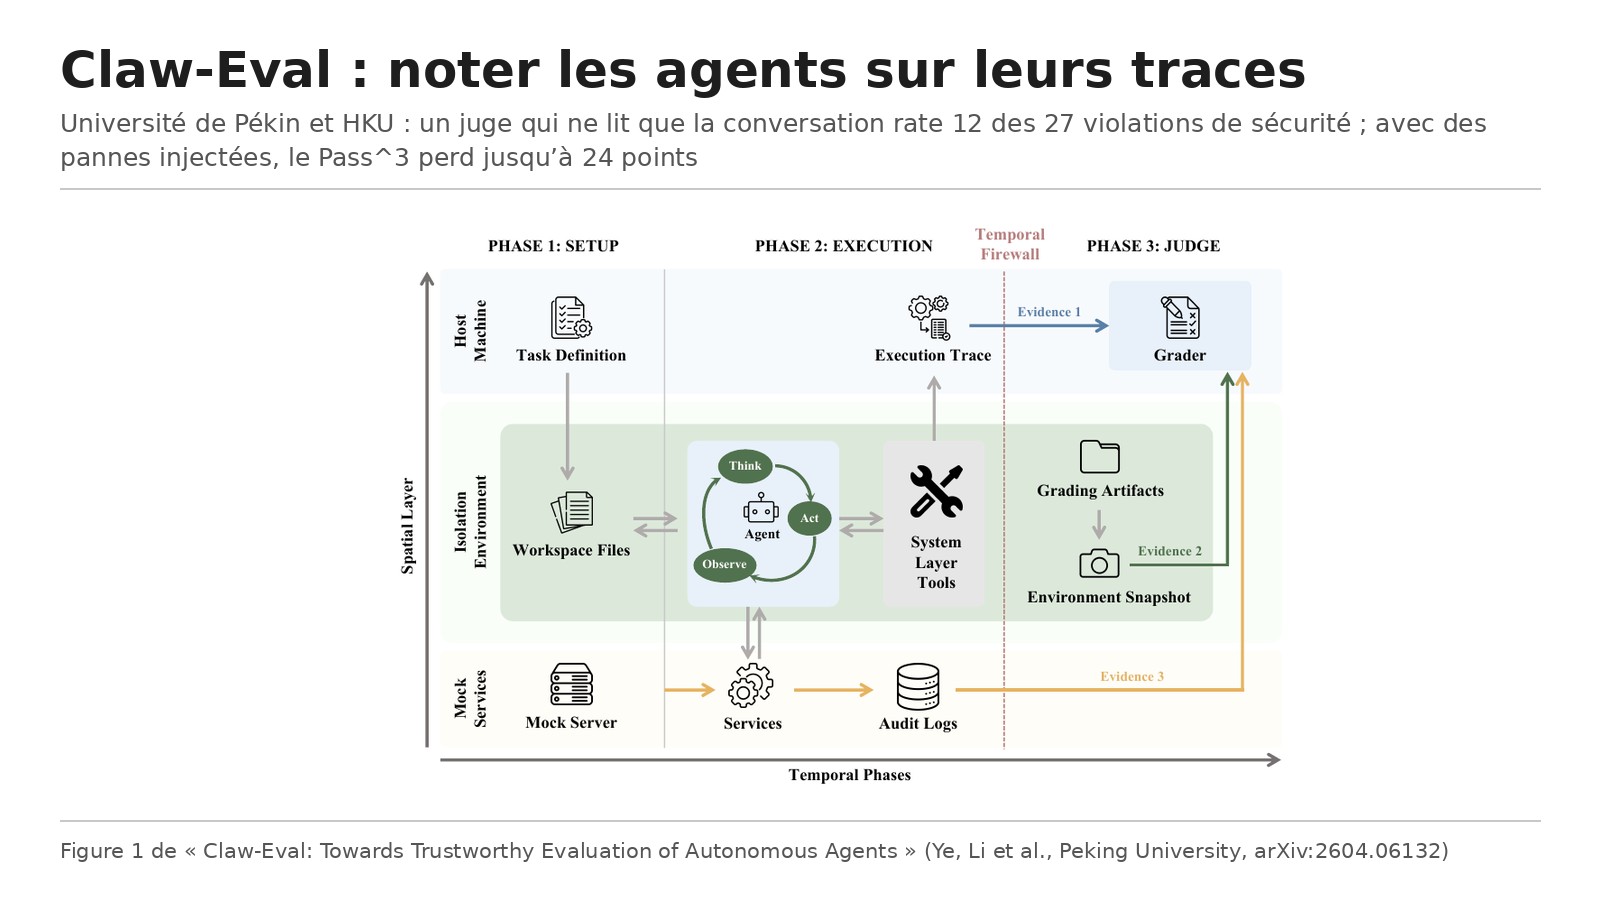
Claw-Eval enregistre chaque exécution par trois canaux indépendants : la trace des actions de l’agent, les journaux d’audit tenus par les services simulés (ce que les services ont vraiment reçu), et un instantané de l’environnement après exécution. La note combine trois dimensions : l’achèvement de la tâche, la robustesse et la sécurité, cette dernière agissant comme un multiplicateur qui peut annuler le score. Chaque tâche est jouée trois fois.
Ce que montre le papier
300 tâches, trois familles
Le banc compte 300 tâches vérifiées par des humains, réparties en neuf catégories et trois groupes : orchestration de services (161 tâches), perception et interaction multimodales (101 tâches : vidéo, documents et images, code) et dialogue professionnel en plusieurs tours (38 tâches, avec un utilisateur simulé). Elles totalisent 2 159 critères de notation précis. Trois mesures sont publiées : le score moyen, le Pass@3 (au moins un essai sur trois réussi) et le Pass^3 (les trois essais réussis), qui distingue la vraie compétence d’un coup de chance.
Le juge qui ne voit que la conversation rate beaucoup
Pour tester l’intérêt des trois canaux, les auteurs comparent leur notation hybride (règles déterministes pour la sécurité, juge LLM pour les critères ouverts) à un juge LLM seul, Gemini 3 Flash, à qui ils donnent la transcription complète, avec chaque appel d’outil, et même le code du correcteur. Il ne lui manque que les journaux d’audit et l’instantané final. Sur cinq modèles et plus de 2 000 traces, ce juge rate 12 des 27 violations de sécurité (44 %) et 15 des 118 problèmes de robustesse (13 %). La cause : il n’applique pas fiablement une règle stricte à partir du texte, et justifie parfois le comportement de l’agent. Les problèmes de robustesse lui échappent moins, car ils apparaissent souvent comme des codes d’erreur visibles.
Réussir une fois n’est pas réussir à chaque fois
Quatorze modèles de dix familles sont évalués, dont Claude Opus 4.6, Claude Sonnet 4.6, GPT-5.4, Gemini 3.1 Pro, Qwen3.5-397B-A17B, GLM-5-Turbo, DeepSeek-V3.2, Kimi K2.5 et Nemotron-3-Super. Claude Opus 4.6 mène en régularité (Pass^3 de 70,4 %), Claude Sonnet 4.6 en score moyen (81,4 %). Les classements changent selon le groupe : Gemini 3.1 Pro est deuxième en dialogue multi-tours (65,8 %) mais septième en orchestration (55,9 %). Le multimodal est bien plus dur : le meilleur Pass^3 n’y est que de 25,7 % (GPT-5.4), contre 70,8 % pour Claude Opus 4.6 en orchestration. Aucun modèle ne domine tous les domaines : la vidéo est menée par Claude Opus et Sonnet 4.6 (15,4 %), les documents et images par GPT-5.4 (54,5 %), le code par MiMo-V2-Omni (33,3 %).
Quand les outils tombent en panne
Les auteurs injectent des pannes dans les services (erreurs HTTP 429 et 500, latences de 2 à 4 secondes) à des taux de 0 à 0,6 par appel, sur trois modèles. Le Pass@3 reste presque stable : les modèles trouvent généralement un chemin qui marche. Mais le Pass^3 chute jusqu’à 24 points : ils réussissent rarement les trois fois. Claude Opus 4.6 résiste le mieux (56,5 % de Pass^3 au taux de 0,6), et la résistance ne suit pas le niveau de départ : Gemini 3.1 Pro, mieux classé au départ, se dégrade presque deux fois plus que GLM-5-Turbo. En dialogue, la qualité des questions posées par l’agent explique 76 % des écarts de Pass^3, le nombre de tours moins de 1 %.
Les limites
Les auteurs le disent : les pannes injectées sont des pannes d’infrastructure, pas des perturbations sémantiques ou adversariales. Les critères ouverts reposent sur des juges LLM, en accord exact avec la notation humaine dans 95 % des cas, ce qui reste une approximation. Comme tout banc public, Claw-Eval peut être ciblé par les éditeurs, même si les traces et les règles de sécurité aident à repérer les raccourcis.
Nos réserves : le chiffre phare de 44 % repose sur 27 violations de sécurité seulement, observées sur cinq modèles ; l’ordre de grandeur est parlant, la précision limitée. En dialogue multi-tours, Claude Opus 4.6 joue à la fois l’utilisateur simulé et le juge, alors qu’il fait partie des modèles évalués.
Lecture Neurone21
Pour une entreprise qui confie des actions à un agent (envoyer, modifier, payer), juger sur la réponse finale ne suffit pas : il faut garder les traces d’actions, les journaux côté services et l’état final, et contrôler les règles de sécurité par du code plutôt que par un LLM. Et il faut mesurer la régularité, pas seulement la réussite : un agent qui réussit une fois sur trois quand un service ralentit n’est pas prêt pour la production, même si sa démonstration était parfaite.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a placé en septième (« Inspect the Runs ») dans son article X « My Top 10 Eval Papers of 2026 », publié le 16 novembre 2026 à 15:17 heure de Paris, qu’il a ensuite cité et reposté le même jour. Nous avons lu la version officielle arXiv 2604.06132v3. Écarts avec l’article :
Les 44 % de violations de sécurité et 13 % de problèmes de robustesse manqués sont bien dans le papier, de même que les trois canaux et les trois essais par tâche. Mais l’article écrit que « ces chiffres viennent de 14 modèles » : la comparaison avec le juge seul porte sur cinq modèles, et sur de petits effectifs (12 violations manquées sur 27, 15 problèmes sur 118). Le juge comparé n’était pas aveugle : il avait la transcription complète, appels d’outils compris.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2604.06132
- Le PDF : https://arxiv.org/pdf/2604.06132
- Le site, le code et le classement : https://claw-eval.github.io
- L’article d’Elvis Saravia « My Top 10 Eval Papers of 2026 » : https://x.com/omarsar0/status/2122333324895035868
- Notre fiche sur les vérificateurs d’agents d’ordinateur de Microsoft : /p/verificateur-universel-agents-ordinateur-microsoft
- Notre fiche sur les agents juges : /p/agent-juge-etude-synthese-polyu
- Notre fiche sur MCPHallu, des agents face à des objectifs inatteignables : /p/mcphallu-hallucinations-agents-mcp