Titre original : A Survey on Agent-as-a-Judge (page arXiv : Agent-as-a-Judge)
Auteurs : Runyang You et Hongru Cai (contribution égale), Caiqi Zhang, Qiancheng Xu, Meng Liu, Tiezheng Yu, Yongqi Li (auteur correspondant) et Wenjie Li.
Affiliations : The Hong Kong Polytechnic University, avec l’université de Cambridge et la Shandong Jianzhu University.
Publication : étude de synthèse déposée sur arXiv le 8 janvier 2026 (2601.05111v1, 15 pages). Ce n’est pas un papier expérimental : il n’apporte ni benchmark ni mesure nouvelle, il organise la littérature.
Liens : page arXiv, PDF.
L’idée en bref
Le « LLM juge » a remplacé une bonne partie de l’évaluation humaine : il note vite, à grande échelle, et sert même de récompense pour entraîner d’autres modèles. Mais les auteurs lui voient trois défauts quand les tâches se compliquent. Il a des biais propres (il préfère les réponses longues, ou celles qui lui ressemblent). Il juge sur l’apparence, sans vérifier : une réponse qui a l’air juste passe, d’où ce qu’ils appellent une « correction hallucinée ». Et face à une grille à nombreux critères, il sature et rend une note grossière.
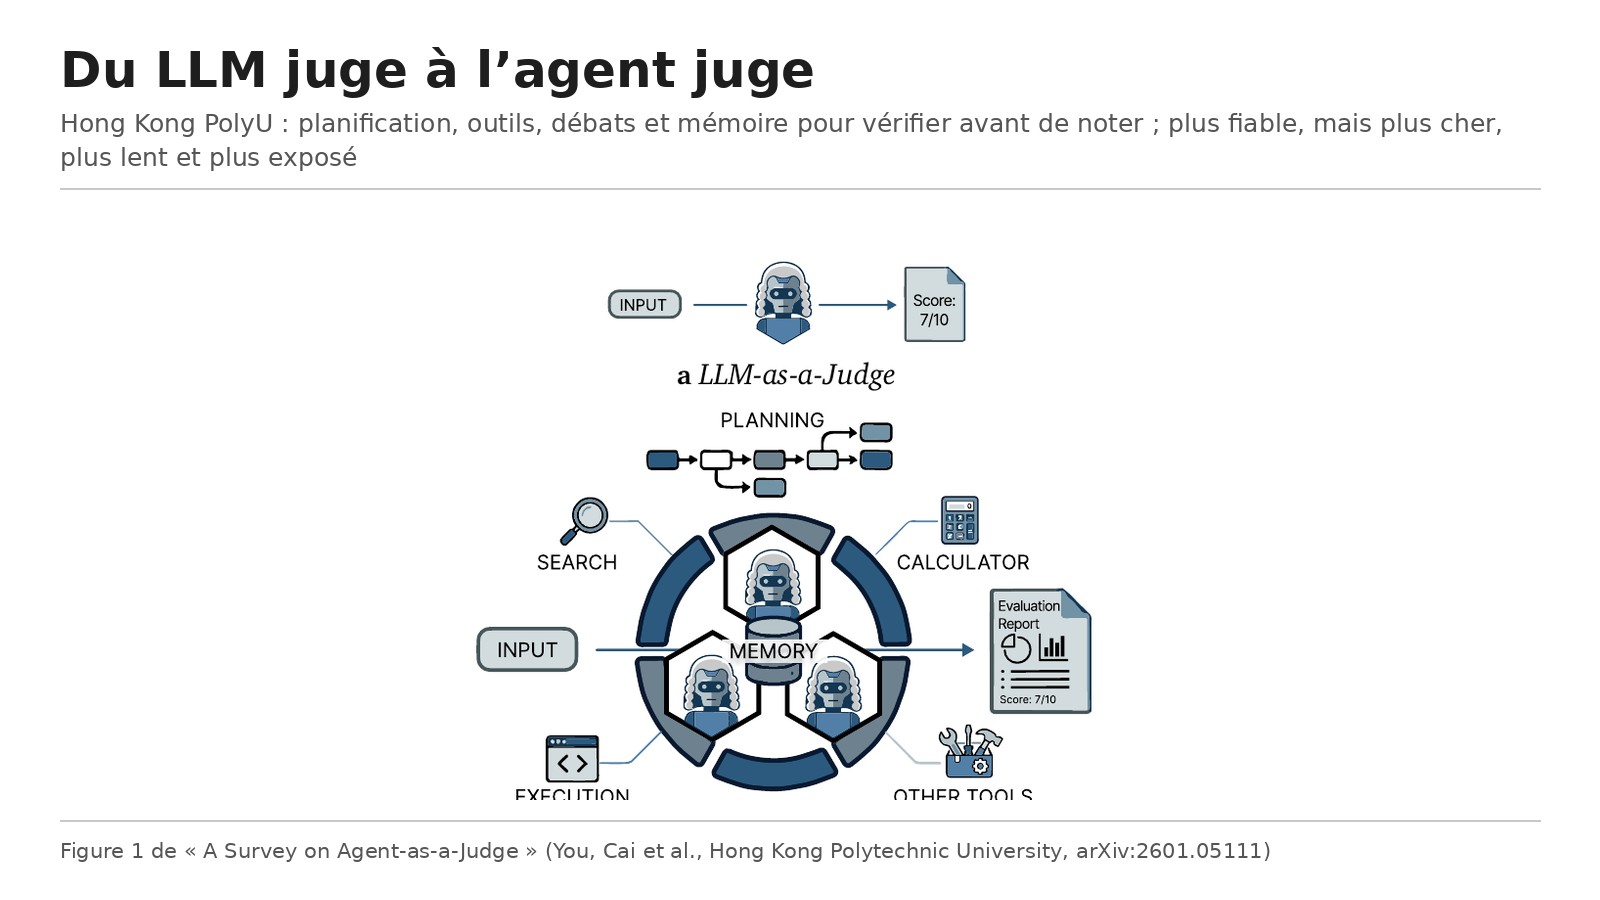
L’agent juge répond à ces défauts avec les outils des agents : il découpe l’évaluation en sous-tâches, vérifie avec des outils (exécution de code, tests, recherche), confronte plusieurs points de vue entre agents et garde en mémoire ses étapes intermédiaires ou les préférences d’un utilisateur.
Ce que montre le papier
Trois stades d’autonomie
Les auteurs classent les systèmes existants selon leur degré d’autonomie. Au stade procédural, l’évaluation suit un flux fixé à l’avance : ChatEval, par exemple, organise un débat inspiré d’un tribunal entre agents aux rôles définis. Au stade réactif, le système adapte son chemin à ce qu’il observe, par exemple un agent routeur qui choisit l’outil ou l’expert le plus pertinent (AGENT-X). Au stade auto-évolutif, le juge affine lui-même ses critères et ses composants au fil des évaluations. Ils notent que le mot « agent » est souvent employé de façon très large dans ce domaine.
Cinq familles de méthodes
L’étude range les méthodes en cinq dimensions : la collaboration entre agents (débats, rôles spécialisés, méta-évaluateur qui juge les juges), la planification (décomposer une grille, décider quand arrêter de chercher des preuves), l’intégration d’outils (exécution de code, analyse statique, tests unitaires, recherche, calcul), la mémoire et la personnalisation (garder le contexte d’un utilisateur ou d’une évaluation longue), et les paradigmes d’optimisation (entraîner ou faire évoluer le juge).
Des usages dans plusieurs métiers
Les applications recensées vont des domaines généraux (maths et code, où le juge exécute ou inspecte le programme ; vérification des faits ; conversation ; images et vidéos) aux domaines professionnels. En médecine, des évaluateurs découpent la qualité clinique en rôles spécialisés ou simulent des patients. En droit, ils reproduisent le débat contradictoire, jusqu’aux opinions concordantes et dissidentes. En finance, ils extraient la logique d’un rapport d’analyste ou auditent la trajectoire d’un agent pour repérer hallucinations et informations périmées. En éducation, ils décomposent la correction en étapes (grille, repérage des preuves, relecture croisée).
Ce que ça coûte
L’étude consacre une partie aux défis. Le coût d’abord : plusieurs étapes de raisonnement, des appels d’outils et la coordination de plusieurs agents multiplient le calcul par évaluation. La latence ensuite, problématique pour la modération en direct ou pour des boucles d’entraînement qui demandent un retour rapide. La sécurité : un juge qui accède à un moteur de recherche, un exécuteur de code ou une base de données élargit la surface d’attaque (injection de consignes, mauvais usage des outils), les comportements dangereux peuvent se propager entre agents, et quand le juge sert de récompense, ses biais peuvent être amplifiés par l’entraînement. La confidentialité enfin, dès que le juge garde une mémoire persistante. Les pistes proposées : personnaliser les juges, générer les grilles à la volée selon la réponse, adapter le niveau de détail et rendre les juges plus interactifs.
Les limites
Les auteurs le disent : le domaine n’a pas encore de définition consensuelle de l’agent évaluateur, et ils incluent des méthodes pionnières qui reposent surtout sur des consignes (jeu de rôle fixe) sans répondre aux critères stricts d’autonomie.
Nos réserves : une étude de synthèse ne mesure rien ; elle ne dit pas de combien un agent juge améliore la fiabilité, ni à quel coût, sur une tâche donnée. Elle date de janvier 2026, dans un domaine qui bouge vite.
Lecture Neurone21
Dès qu’une réponse ne peut pas être vérifiée en la lisant (un code qui doit tourner, un chiffre à recouper, un fichier modifié), un juge qui agit est plus fiable qu’un juge qui lit. Mais un juge qui exécute du code ou interroge des systèmes est lui-même un agent, avec les mêmes risques : il doit tourner dans un environnement isolé, avec des droits limités, et ses verdicts doivent être contrôlés sur un échantillon relu par des humains, comme n’importe quel autre correcteur.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a placé en sixième (« Give Judges Evidence ») dans son article X « My Top 10 Eval Papers of 2026 », publié le 16 novembre 2026 à 15:17 heure de Paris, qu’il a ensuite cité et reposté le même jour. Nous avons lu la version officielle arXiv 2601.05111v1. Écarts avec l’article :
L’article ne cite pas de chiffres et résume fidèlement les avantages et les défis (coût, lenteur, sécurité). Deux précisions : il s’agit d’une étude de synthèse sans expérience propre, et le conseil de placer le juge dans le même bac à sable que l’agent évalué vient d’Elvis Saravia, pas des auteurs, même s’il découle de leurs remarques sur la sécurité.
Pour aller plus loin
- L’étude sur arXiv : https://arxiv.org/abs/2601.05111
- Le PDF : https://arxiv.org/pdf/2601.05111
- L’article d’Elvis Saravia « My Top 10 Eval Papers of 2026 » : https://x.com/omarsar0/status/2122333324895035868
- Notre fiche sur Claw-Eval, qui note les agents à partir de leurs traces : /p/claw-eval-trajectoires-agents-securite
- Notre fiche sur les panels de juges LLM : /p/panels-juges-llm-erreurs-correlees-apple
- Notre fiche sur AutoRefine, des juges de code recalés sur les tests : /p/autorefine-juges-code-meta