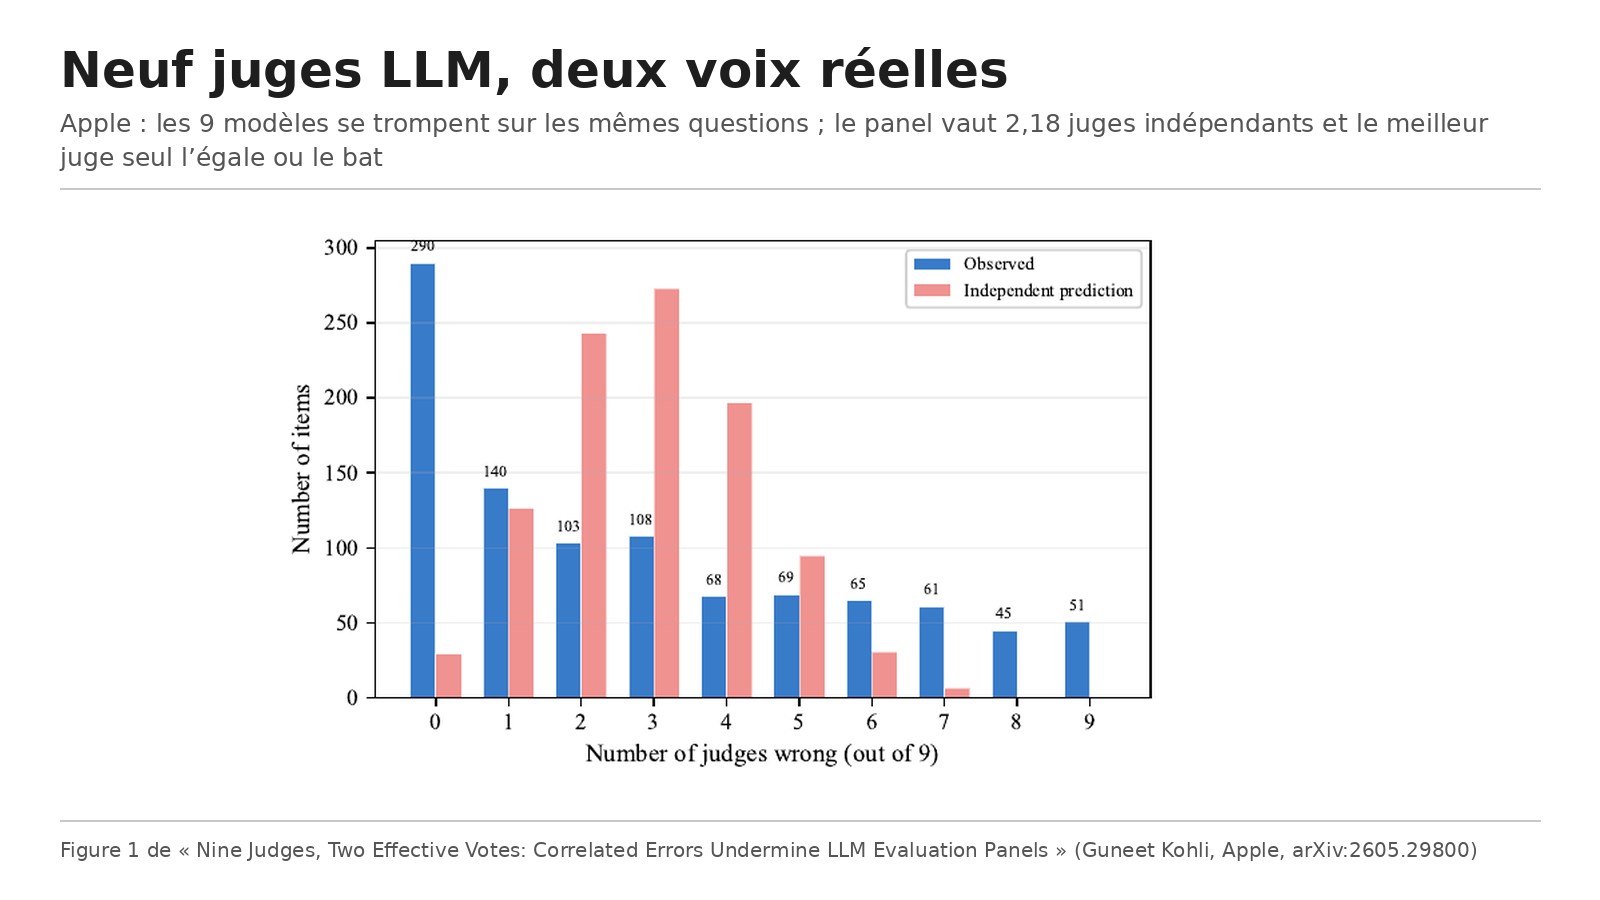
Titre original : Nine Judges, Two Effective Votes: Correlated Errors Undermine LLM Evaluation Panels
Auteur : Guneet Kohli (auteur unique).
Affiliation : Apple.
Publication : prépublication déposée sur arXiv le 28 mai 2026 (2605.29800v1, cs.CL, 14 pages). Pas de relecture par des pairs mentionnée.
Liens : page arXiv, PDF.
L’idée en bref
Un juge LLM peut se tromper. La parade la plus répandue : en réunir plusieurs, de familles différentes, et prendre la majorité. Le raisonnement suppose que leurs erreurs sont indépendantes : si chacun a raison sept fois sur dix, la majorité de neuf juges devrait avoir raison bien plus souvent. C’est le théorème du jury de Condorcet.
L’auteur vérifie cette hypothèse. Il mesure combien de juges réellement indépendants vaut un panel, avec la taille d’échantillon effective de Kish (calculée à partir de la corrélation des erreurs entre chaque paire de juges), et compare la précision réelle du panel à celle d’un modèle de Condorcet où des juges de même niveau voteraient de façon indépendante. L’écart entre les deux est appelé écart de Condorcet.
Ce que montre le papier
Un panel de 9 modèles de 7 familles
Le panel réunit GPT-4o et GPT-4o-mini (OpenAI), Claude Sonnet 4.5 (Anthropic), Gemini 2.5 Pro (Google), Llama 4 Maverick et Llama 4 Scout (Meta), Qwen3-32B (Alibaba), Mistral Large 3 et DeepSeek-V3, tous à température nulle avec la même consigne. Ils jugent des questions d’inférence en langue naturelle (une phrase en implique-t-elle une autre, la contredit-elle, ou ni l’un ni l’autre ?) tirées de ChaosNLI, où chaque question a été annotée par 100 personnes. La bonne réponse est le vote majoritaire de ces 100 annotateurs. Trois jeux sont utilisés (MNLI, SNLI et AlphaNLI, ce dernier en raisonnement abductif), avec 1 000 questions chacun, plus 1 000 paires de RewardBench pour une tâche de préférence.
Neuf votes qui en valent deux
Sur MNLI, le panel vaut 2,18 juges indépendants (intervalle de confiance à 95 % : 2,07 à 2,31), soit 24,2 % de son indépendance nominale. Le signe est visible à l’œil nu : 290 questions (29 %) sont réussies par les neuf juges et 51 (5,1 %) ratées par les neuf, quand l’indépendance en prédirait moins d’une. Sur les trois jeux, le panel vaut entre 2,2 et 2,5 juges, pour des précisions de 72 % à 89 %.
Conséquence : le meilleur juge seul égale ou bat le panel partout. Sur MNLI, le panel (72,0 %) devance Qwen3-32B (71,8 %) de 0,2 point, dans le bruit. Sur SNLI, Claude Sonnet 4.5 seul fait 84,2 % contre 77,7 % pour le panel ; sur AlphaNLI, 91,2 % contre 88,7 %. L’écart de Condorcet atteint 22,0, 14,0 et 7,6 points selon le jeu.
Ni plus de juges ni une meilleure formule
Au-delà de cinq juges, en ajouter n’apporte presque plus rien : l’indépendance effective plafonne vers 2,3 à 3,1. Les méthodes d’agrégation établies (l’algorithme de Dawid-Skene, le vote pondéré par la précision de chaque juge) comblent au plus 11 % de l’écart, même quand on leur donne accès aux bonnes réponses pour régler leurs poids. Le problème vient des juges, pas de la formule.
Le résultat tient avec quatre variantes de consigne et deux températures (entre 1,94 et 2,18 juges effectifs). Faire raisonner les juges pas à pas augmente même la corrélation (1,94). Sur RewardBench, la précision du panel monte à 92,7 % et l’écart à 6,8 points seulement, mais le panel ne vaut toujours que 1,99 juge. Les juges d’une même famille se ressemblent un peu plus, mais retirer n’importe quel juge ne change presque rien : le phénomène est général. Même sur les 179 questions faciles, où au moins 80 % des humains sont d’accord, le panel ne vaut que 2,67 juges.
Les limites
L’auteur le dit : les quatre tâches sont des classifications ou des préférences binaires ; la corrélation pourrait différer pour l’évaluation de textes libres ou la revue de code. Sur les questions ambiguës, le vote majoritaire des humains est une préférence plus qu’une vérité. Les résultats sont un instantané des modèles actuels, et l’intervalle de confiance ne couvre pas le choix des juges : un autre panel pourrait donner un autre chiffre.
Nos réserves : une bonne partie du panel date de 2025 (GPT-4o, Llama 4, DeepSeek-V3) ; les modèles de 2026 pourraient être plus ou moins corrélés. L’étude est signée par un seul auteur, ce qui n’enlève rien à la méthode, très simple à refaire, mais limite les vérifications croisées.
Lecture Neurone21
Si vous évaluez vos résultats avec plusieurs LLM qui votent, mesurez d’abord à quel point ils se trompent ensemble, sur vos propres données. Un panel de cinq modèles qui ratent les mêmes cas coûte cinq fois plus cher qu’un seul juge, pour une fiabilité à peine supérieure. Mieux vaut souvent un bon juge unique, des vérifications indépendantes de nature différente (règles, tests, humains sur un échantillon), et une attention particulière aux cas où tous les juges sont d’accord : l’unanimité n’est pas une preuve.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a placé en cinquième (« Check Judge Independence ») dans son article X « My Top 10 Eval Papers of 2026 », publié le 16 novembre 2026 à 15:17 heure de Paris, qu’il a ensuite cité et reposté le même jour. Nous avons lu la version officielle arXiv 2605.29800v1. Écarts avec l’article :
Les constats sont conformes : neuf juges de sept familles, environ deux votes indépendants, meilleur juge seul aussi bon ou meilleur, agrégation inefficace, tâches d’inférence et de préférence. L’article parle de « neuf modèles de pointe » : plusieurs étaient déjà anciens au moment de l’étude (GPT-4o, GPT-4o-mini, DeepSeek-V3).
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2605.29800
- Le PDF : https://arxiv.org/pdf/2605.29800
- L’article d’Elvis Saravia « My Top 10 Eval Papers of 2026 » : https://x.com/omarsar0/status/2122333324895035868
- Notre fiche sur JEV comme juge de premier niveau : /p/jev-juge-confiance-escalade-cmu
- Notre fiche sur AutoRefine, qui recale des juges de code avec les tests : /p/autorefine-juges-code-meta
- Notre fiche sur les agents juges : /p/agent-juge-etude-synthese-polyu