Titre original : JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
Auteurs : Yubo Li, Yidi Miao, Ramayya Krishnan et Rema Padman.
Affiliations : Carnegie Mellon University. Travail financé en partie par le NIST et par le centre AIMSEC de Carnegie Mellon, avec des crédits d’API du programme d’accès chercheurs d’OpenAI. Aucun auteur n’est affilié à TypeSafe, l’éditeur de JEV.
Publication : prépublication arXiv de septembre 2026 ; nous avons lu la version 6 du 29 octobre 2026 (2609.26550v6, 53 pages), qui ajoute en annexe une comparaison avec des modèles de décision ouverts.
Liens : page arXiv, PDF.
L’idée en bref
Faire noter les réponses d’un modèle par un autre LLM est devenu la norme. Mais un juge qui raisonne coûte cher et répond lentement : dans le panel des auteurs, GPT-6 revient à environ 12 dollars les 1 000 jugements, une facture qui revient à chaque nouveau modèle, chaque réglage, chaque nouveau jeu de données. Or la moitié du problème, notent-ils, ce sont des décisions de routine.
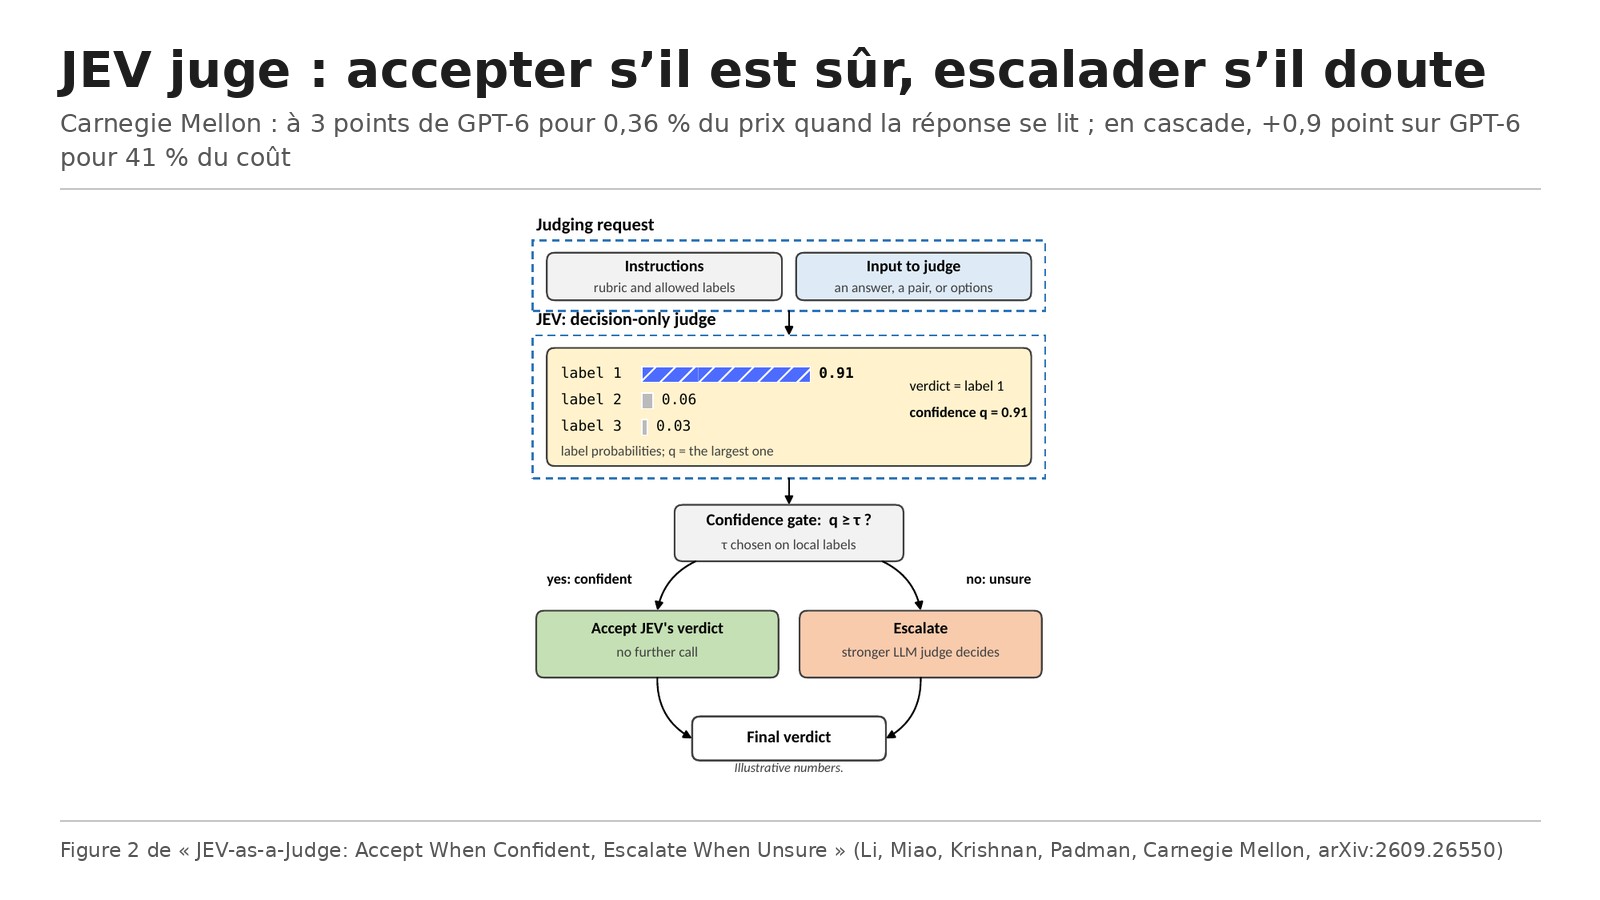
JEV, de la société TypeSafe, est un modèle de décision : il reçoit une consigne et des options, et renvoie une probabilité pour chaque option, sans générer de texte. Les auteurs prennent la probabilité la plus haute comme indice de confiance. Le principe testé : accepter le verdict de JEV quand il est sûr de lui, et transmettre les autres cas à un juge plus fort. Pour une comparaison équitable, les juges génératifs répondent au même format (un verdict et des probabilités, sans justification).
Ce que montre le papier
Un juge très bon marché, au milieu du peloton
JEV (version 1.13.0, facturée 0,042 dollar par million de tokens d’entrée, sortie gratuite) est comparé à 16 juges : 14 LLM génératifs et 2 modèles de récompense. Le banc couvre 5 172 jugements de base : 1 500 paires RewardBench, 350 paires JudgeBench, 3 000 réponses HaluEval à vérifier, plus des tests de style (500 prompts RM-Bench), de format, de prose libre (600 jugements) et de choix entre quatre options. Des humains ont arbitré à l’aveugle chaque étiquette contestée par JEV ou GPT-6 sur un sous-ensemble de 990 items.
Sur 4 850 jugements publics, JEV se classe huitième des quinze juges LLM, 1,7 point derrière GPT-6, pour un coût 277 fois plus faible (0,044 dollar les 1 000 jugements) et une latence médiane de 0,15 seconde.
Bon quand la réponse se lit, faible quand il faut la trouver
Quand le verdict peut se lire dans le texte (qualité de conversation, sécurité, préférence ordinaire, vérification d’une réponse finale fournie), JEV reste à 2 ou 3 points de GPT-6, pour 0,36 % de son prix. Il ne le bat nettement que sur quelques tranches faciles. En revanche, quand le juge doit trouver lui-même la bonne réponse (connaissances d’expert, code, maths, énigmes logiques), il décroche de 7 à 28 points. Il perd aussi 13,5 points sur des paires RM-Bench où la mauvaise réponse est mieux rédigée. Sur les items que les 13 autres juges LLM réussissent tous, JEV fait 99,8 % : l’écart se joue sur les cas de difficulté moyenne. Les arbitres humains donnent raison à GPT-6 sur 57 des 69 items JudgeBench disputés.
La confiance indique où se trouve l’écart
Quand la confiance de JEV atteint au moins 0,9, les deux juges sont à égalité (94,7 % contre 94,4 % pour GPT-6 sur 3 744 items). Seuls 12 à 21 % des erreurs de préférence de JEV se font avec une telle confiance, contre 25 à 41 % pour GPT-6. Le signal faiblit là où JEV est trompé avec assurance : sur les paires piégées par le style, sa confiance détecte moins bien ses erreurs (AUROC de 0,76 contre 0,84), et sur de la prose libre sans référence, tous les juges testés sont proches du hasard tout en restant confiants.
En cascade, aussi précis que GPT-6 pour moins cher
Avec un seuil fixé avant l’évaluation, la cascade transmet 31 % de 1 610 paires tenues à l’écart et fait 0,9 point de mieux que GPT-6 seul, pour 41 % de son coût. Sur RewardBench, elle transmet 25 % des paires pour 27 % du coût ; sur JudgeBench, où JEV seul est 12 points derrière, elle en transmet 65 % et comble 94 % de l’écart. En conditions réelles sur 510 paires, la latence médiane est de 0,27 seconde contre 2,10 pour GPT-6 seul. Parmi huit premiers étages bon marché ou ouverts, JEV est le seul à rester à moins de 2 points de GPT-6 sur les deux bancs en économisant au moins 30 % du coût.
Le choix du seuil compte : en le fixant par une borne basse de confiance plutôt qu’une estimation ponctuelle, avec une centaine d’exemples étiquetés localement, le risque de perdre plus de 2 points passe d’environ 45 % à environ 5 %, et sous 1 % avec un seuil propre à chaque usage. Dans un test annoncé à l’avance sur 570 paires de deux nouveaux usages, où JEV seul est 14 points derrière GPT-6, la cascade égale exactement la précision de GPT-6 en transmettant 74 % des paires et en économisant un quart du coût.
Les limites
Les auteurs le disent : les tests portent sur des questions avec des réponses candidates ; la prose longue sans référence est à peine couverte, et là tous les juges sont proches du hasard. Les domaines professionnels spécialisés ne sont pas testés, et un juge sans justification ne donne aucune explication à auditer. JEV n’est pas évalué à l’intérieur d’un agent. C’est une boîte noire propriétaire, dont la taille et les données d’entraînement ne sont pas publiques : impossible d’exclure qu’il ait vu les bancs d’essai. Les juges comparés ne disposent pas du même calcul, et les prix et latences viennent d’un lieu et d’une période. Enfin, une cascade en série ne corrige pas les erreurs que les deux juges partagent.
Nos réserves : l’étude dépend d’un produit commercial dont la version et le prix peuvent changer. Le gain de la cascade sur GPT-6 (0,9 point) est petit ; l’intérêt principal est le coût et la latence, pas la précision.
Lecture Neurone21
Pour une entreprise qui évalue ses modèles ou ses agents en continu, l’architecture vaut plus que le produit : un premier juge rapide et bon marché qui tranche les cas évidents, un juge fort pour les cas douteux, et un seuil calibré sur une centaine d’exemples maison. Le papier montre aussi où ne pas faire confiance à un juge bon marché : dès qu’il faut calculer, coder ou raisonner pour savoir qui a raison. Des modèles de décision ouverts existent aussi pour qui veut garder ses données chez soi.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a placé en quatrième (« Use Judge Confidence ») dans son article X « My Top 10 Eval Papers of 2026 », publié le 16 novembre 2026 à 15:17 heure de Paris, qu’il a ensuite cité et reposté le même jour. Nous avons lu la version officielle arXiv 2609.26550v6. Écarts avec l’article :
Les chiffres sont conformes (à 3 points de GPT-6 quand la réponse se lit dans le texte, cascade un peu plus précise que GPT-6 pour 41 % du coût). L’article présente JEV comme « un petit modèle de décision » : le papier précise que sa taille n’est pas publiée. Il ne dit pas que le gain de précision est de 0,9 point sur 1 610 paires, ni que le seuil a été figé avant l’évaluation.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2609.26550
- Le PDF : https://arxiv.org/pdf/2609.26550
- L’article d’Elvis Saravia « My Top 10 Eval Papers of 2026 » : https://x.com/omarsar0/status/2122333324895035868
- Notre fiche sur JEV comme professeur d’agents : /p/modeles-decision-acteur-juge-professeur-agents
- Notre fiche sur Drex, des modèles de décision ouverts : /p/drex-modeles-decision-nace-ai
- Notre fiche sur les panels de juges dont les erreurs se ressemblent : /p/panels-juges-llm-erreurs-correlees-apple