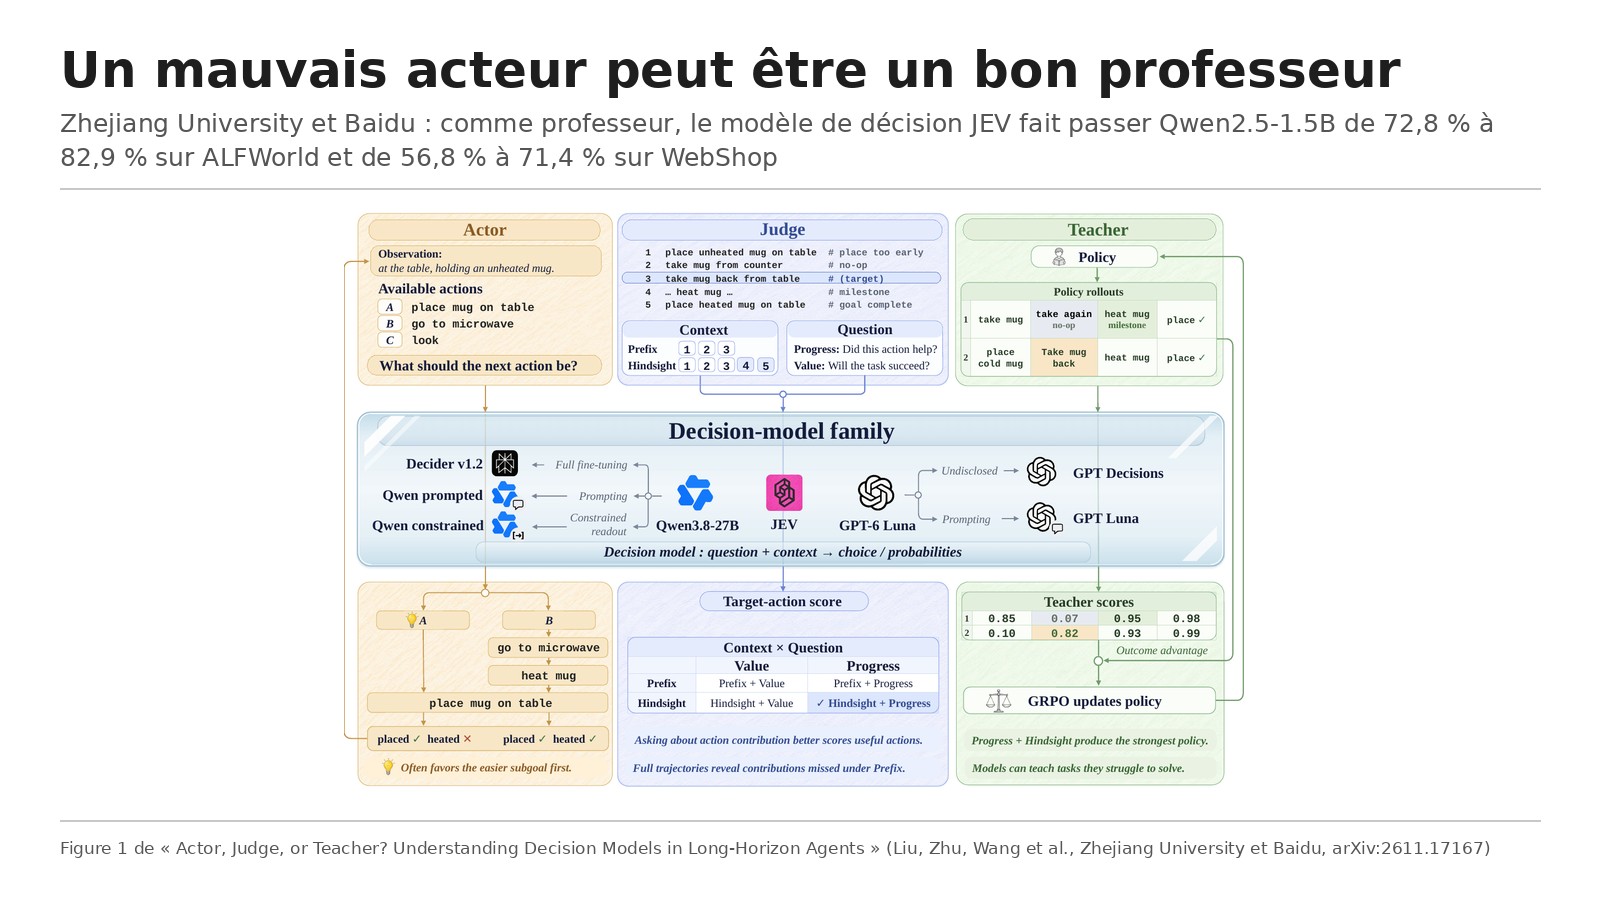
Titre original : Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents
Auteurs : Haochen Liu, Qianhao Zhu et Zixuan Wang (contribution égale), Dingming Li, Tongbo Chen, Peng Qiu, Yingqi Qu, Weiming Lu, Jun Xiao et Yongliang Shen (auteur de correspondance).
Affiliations : université du Zhejiang et Baidu (Peng Qiu, Yingqi Qu).
Publication : prépublication arXiv 2611.17167v1 (cs.AI), déposée le 12 novembre 2026, avec le code en accès libre.
Liens : page arXiv, PDF, code.
L’idée en bref
Les modèles de décision ne rédigent pas de texte : on leur pose une question avec des options, ils choisissent et donnent une probabilité pour chacune, vite et pour pas cher. On peut donc s’en servir de trois façons dans un agent : choisir la prochaine action (acteur), noter après coup des actions déjà jouées (juge), ou noter chaque action d’un agent en cours d’entraînement par renforcement (professeur). Jusqu’ici, on les a surtout évalués comme acteurs, où ils déçoivent. Les auteurs se demandent si un mauvais acteur peut quand même bien enseigner.
Six modèles sont comparés : trois modèles de décision, JEV (TypeSafe AI, fermé), Decider v1.2 (Perplexity, poids ouverts, affiné depuis Qwen3.8-27B) et GPT Decisions (OpenAI, bâti sur GPT-6 Luna), et trois modèles généralistes interrogés de la même façon, Qwen3.8-27B de deux manières et GPT-6 Luna.
Ce que montre le papier
Comme acteurs, tous prennent le raccourci
Sur ALFWorld, banc d’essai de tâches ménagères en mode texte, les six modèles échouent surtout quand une étape doit précéder l’autre, comme chauffer une tasse avant de la poser. JEV réussit 70,8 % des tâches à deux objets posables dans n’importe quel ordre, mais 14,7 % des tâches à étapes ordonnées, et 42,9 % au total. Ce n’est pas un manque de connaissance : quand on retire la sous-tâche facile du but, la probabilité que JEV donne à l’étape requise passe de 14,6 % à 77,6 %. Un simple rappel des dépendances dans la consigne change la réussite de −2,8 à +5,2 points selon les modèles.
Comme juges, tout dépend de la question
Montrer au juge toute la trajectoire, et pas seulement le début, l’aide à reconnaître les étapes utiles. Mais il faut aussi bien poser la question. Demander « cette action a-t-elle aidé ? » sépare nettement les actions qui accomplissent une sous-tâche de celles qui ne changent rien : JEV note les premières 0,36 plus haut dans une même trajectoire. Demander « la tâche va-t-elle réussir ? » ne donne qu’un écart de 0,05, car la réponse est alors la même pour toutes les actions. Les deux modèles de décision dont on connaît la base jugent mieux que cette base interrogée pareil, pour un coût par note 28 % à 43 % plus faible.
Comme professeur, JEV fait mieux que lui-même
Les notes de JEV s’ajoutent à la récompense finale dans GRPO (une méthode de renforcement qui compare plusieurs essais sur la même tâche). Avec la trajectoire complète et la question « a-t-elle aidé ? », un modèle Qwen2.5-1.5B passe de 72,8 % à 82,9 % sur ALFWorld et de 56,8 % à 71,4 % sur WebShop (achats en ligne simulés). La question « va-t-elle réussir ? » ne donne que 69,3 % et 68,3 %. Sur les tâches à étapes ordonnées, que JEV ne réussit qu’à 14,7 % comme acteur, l’élève atteint 86,8 %. Le gain tient pour Qwen2.5-7B (de 77,6 % à 83,8 %, et de 66,1 % à 73,6 %), et le petit modèle ainsi entraîné dépasse le 7B entraîné sans professeur. Les appels à JEV coûtent entre 22,21 et 30,07 dollars par entraînement.
Les limites
Les auteurs en citent trois : deux environnements en mode texte, avec au plus 30 actions par épisode ; des juges qui notent après la fin de l’épisode, ce qui ne transpose pas tel quel à un filtrage en direct ; et des modèles fermés (JEV, GPT Decisions) dont on ignore comment ils ont été adaptés. Nos réserves : seul JEV a servi de professeur, les scores de référence GRPO sont repris d’un autre papier (GiGPO) et pas recalculés, et chaque politique n’est évaluée que sur trois graines. Les gains sont exprimés en points de pourcentage, même si le papier écrit « % ».
Lecture Neurone21
La leçon pratique dépasse les modèles de décision. Pour choisir un évaluateur automatique, il faut le tester sur ce qu’il doit faire, juger des trajectoires enregistrées, et non sur sa capacité à faire la tâche : ici, le plus mauvais acteur s’est révélé un bon professeur. La formulation de la question compte autant que le modèle : demander à chaque étape si elle a fait avancer le but vaut bien mieux que demander si l’ensemble va réussir. Pour une équipe qui entraîne un petit agent métier, c’est une supervision étape par étape à quelques dizaines de dollars, sans étiquetage manuel, et sans coût supplémentaire une fois l’agent en production.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 13 novembre 2026 à 15:47 heure de Paris. Nous avons lu la version officielle arXiv 2611.17167v1. Écarts avec le post :
Les chiffres du post sont exacts : six modèles testés comme acteurs sur ALFWorld (trois modèles de décision, trois généralistes), et de 72,8 % à 82,9 % puis de 56,8 % à 71,4 % pour le Qwen2.5-1.5B. Le post parle de « l’un des modèles de décision » comme professeur : c’est JEV, le seul testé dans ce rôle, et le résultat ne vaut qu’avec la trajectoire complète et la question « a-t-elle aidé ? ». Le post ne dit pas que la référence GRPO est reprise d’un autre papier.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.17167
- Le PDF : https://arxiv.org/pdf/2611.17167
- Le code : https://github.com/ZJU-REAL/decision-agents
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2121253509333201244
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/actor-judge-or-teacher-understanding-decision-models-in-long-horizon-agents-2611.17167
- Notre fiche sur Decider v1.3 de Perplexity : /p/perplexity-decider-v1-3-locate-modeles-decision-apache-2
- Notre fiche sur la Decisions API d’OpenAI : /p/openai-decisions-api-disponibilite-generale-gpt-6-luna
- Notre fiche sur un contrôle juste avant l’action des agents : /p/controle-avant-action-agents-ia-jevact