Titre original : Think Before You Act: Decision Gate for LLM Agents
Auteurs : Iftach Shoham, Yuval David, Offer Akrabi, Erez Bilgory, Ido Levy, Sami Marreed, Sergey Zeltyn et Segev Shlomov, tous affiliés à IBM (mention « IBM SIL » dans le papier).
Publication : prépublication arXiv 2610.38620v1 (cs.AI), déposée le 28 octobre 2026, 18 pages.
Liens : page arXiv, PDF.
L’idée en bref
Un agent IA qui modifie une réservation, résilie un contrat ou dit au client « je ne peux rien faire de plus » agit souvent dès que le modèle a proposé l’action, sans vérification. Une erreur de réponse se corrige au tour suivant ; une écriture non autorisée en base, ou un abandon trop rapide, beaucoup moins.
JevAct ajoute un point de contrôle entre l’agent et ses outils. Le modèle de l’agent, son prompt et ses outils restent inchangés. Avant chaque écriture et avant chaque abandon, le contrôle vérifie l’action. Si elle pose problème, elle n’est pas exécutée : l’agent reçoit un retour précis et une chance limitée de corriger, deux fois au plus pour une écriture et une fois pour un abandon. Un contrôle ne peut donc pas bloquer l’agent indéfiniment (section 3.2).
Ce que montre le papier
Comment le contrôle est construit
Hors ligne, un modèle (ici Claude Opus 4.6) transforme la politique métier en trois choses : des questions oui ou non, une règle qui combine les réponses, et du code Python qui calcule ce que les enregistrements des outils permettent d’établir, comme des dates, des montants ou des franchises de bagages. Pour les abandons, il produit une liste des étapes de dépannage à essayer d’abord (section 3.3).
À l’exécution, le code vérifie les faits chiffrés. Les questions qui dépendent de la conversation, comme « le client a-t-il vraiment demandé l’annulation ? », vont à Kev-27B, un modèle de décision open source dérivé de Qwen3.8-27B. Il ne génère pas de texte : il renvoie en une seule passe une probabilité pour chaque réponse. Une action n’est refusée que si le modèle est très sûr, avec une probabilité de « oui » de 5 % au plus (sections 3.4 et 3.5).
Les résultats
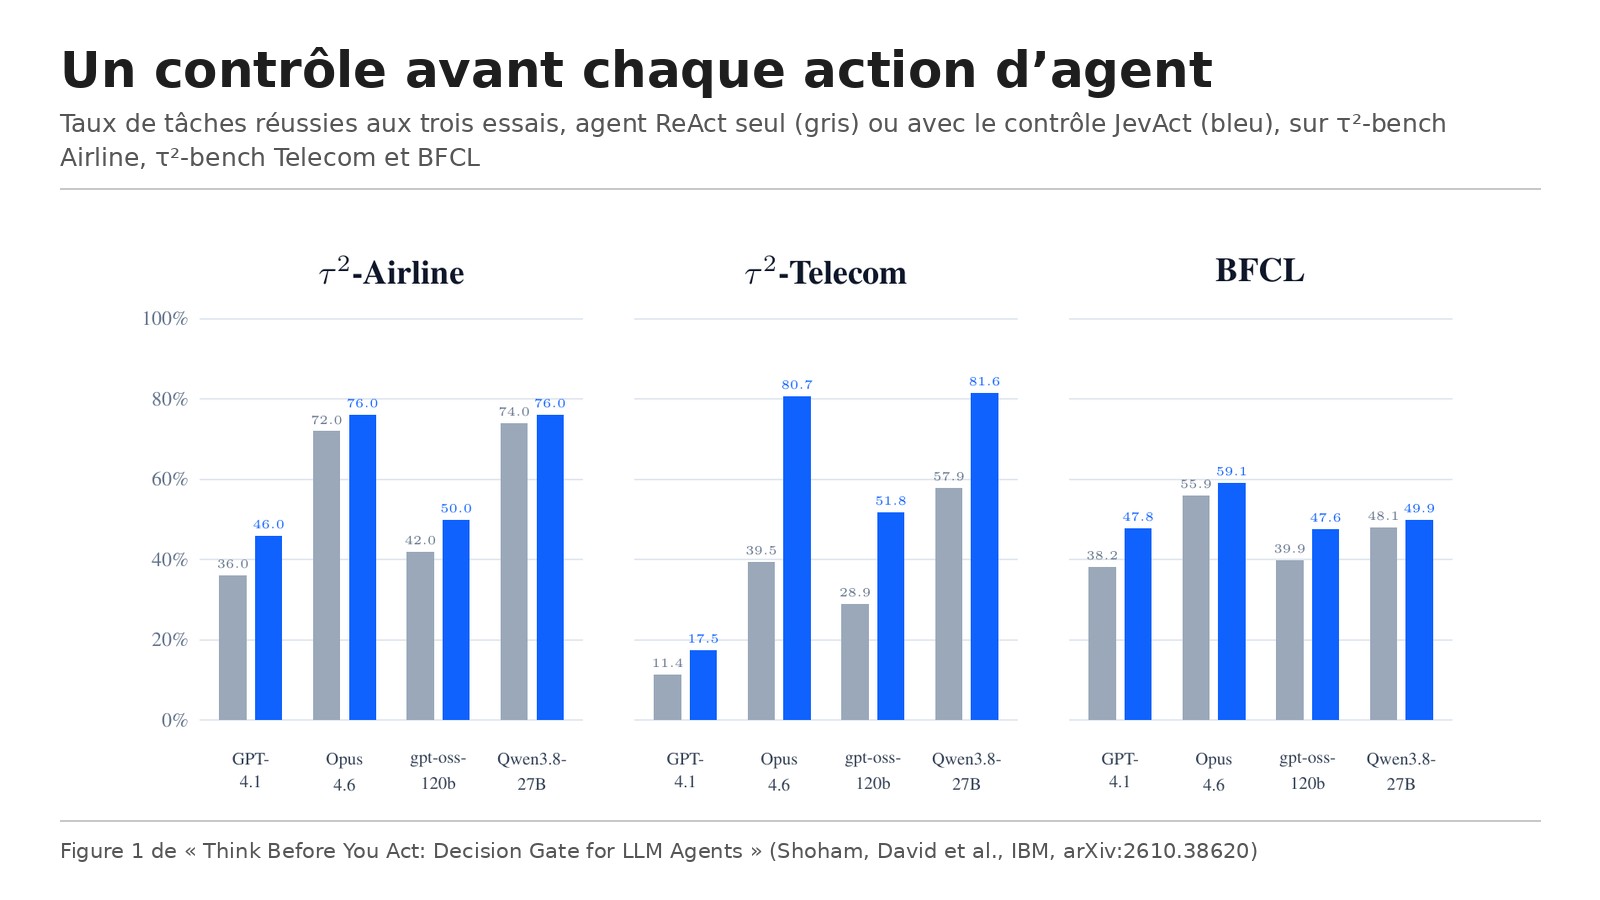
Le test τ²-bench Telecom (114 tâches de dépannage) donne les gains les plus nets : les huit agents testés progressent, de 16,9 points en moyenne en réussite aux trois essais. Claude Opus 4.6 passe de 39,5 % à 80,7 %, et même Claude Opus 5.5, le plus fort au départ, passe de 74,6 % à 82,5 % (section 5, tableau 2).
Sur τ²-bench Airline (50 tâches de réservation), c’est plus mitigé : la réussite aux trois essais monte pour quatre agents sur six et baisse pour deux. Sur BFCL (800 tâches d’appel de fonctions, sans politique écrite), les neuf agents progressent en réussite aux trois essais, de 0,1 à 9,6 points, mais cinq reculent légèrement en réussite au moins une fois.
D’où vient le gain
Sur Airline avec GPT-4.1, en un essai, le contrôle complet fait passer la réussite de 50,0 % à 72,0 %. Le code seul atteint déjà 68,0 %, les questions au modèle de décision seules 57,1 %. Un placebo qui renvoie chaque écriture une fois sans rien vérifier ne gagne rien (50,0 %) (tableau 3). Mais pour gpt-oss-120b, une simple relecture forcée ou des refus au hasard donnent le même gain que le contrôle complet : l’utilité du jugement dépend donc de l’agent (section 5.1).
Un juge bon marché
Sur Airline, Kev-27B fait aussi bien ou mieux que les modèles génératifs testés comme juges, pour beaucoup moins cher : entre 0,0003 et 0,0017 dollar par tâche pour les modèles Kev, contre 0,0127 à 0,0231 dollar pour des juges par API comme Claude Haiku 4.5 ou GPT-4.1 (tableau 4). Un juge plus petit peut suffire : sur 609 situations d’abandon rejouées sur Telecom, Kev-9B prend la même décision que Kev-27B dans 97,0 % des cas (annexe A.2).
Les limites
Les auteurs reconnaissent que (sections 5 et 6) :
- les comparaisons évaluent tout le dispositif, pas le juge seul ;
- avec un autre simulateur de client (gpt-oss-120b au lieu de GPT-4.1), le gain sur Telecom disparaît : moins 1,8 point, avec un intervalle de confiance de moins 7,9 à plus 4,4 ;
- sur 260 écritures annotées, 42 des 101 appels erronés ne violent aucune des questions compilées, parce que les questions décrivent la politique et non la demande du client ;
- avec 50 tâches sur Airline, une seule tâche fait varier le score de 2 points.
Réserves de notre lecture, tirées du papier :
- Les tests sont des simulations de service client, avec un client joué par un modèle. Le résultat dépend visiblement de ce simulateur.
- La liste des étapes de dépannage a été revue après un examen des résultats (annexe A.1, étape 6), ce qui rend le gain sur Telecom un peu moins indépendant.
Lecture Neurone21
Pour une entreprise qui déploie un agent sur ses outils métier, c’est l’un des résultats les plus directement utiles du moment. Il dit trois choses simples. D’abord, la fiabilité d’un agent se joue autant dans ce qui l’entoure que dans le modèle choisi. Ensuite, une grande partie du gain vient de vérifications écrites en code, sur des faits que les systèmes connaissent déjà : dates, montants, droits. Enfin, un petit modèle spécialisé suffit pour juger le reste, pour une fraction de centime par tâche.
En pratique, avant de changer de modèle parce que l’agent fait des erreurs, il vaut la peine de lister les actions qui écrivent dans vos systèmes, de traduire vos règles en contrôles, et de vérifier que l’agent ne rend pas la main trop tôt. C’est l’esprit de notre dossier sur le harnais des agents IA, et de notre fiche sur la vérification dans les harnais d’agents.
Le post d’Elvis Saravia est fidèle aux chiffres. Sa phrase « les gains viennent du harnais » doit se lire comme le disent les auteurs : le dispositif est évalué en bloc, sans isoler le rôle du juge. Le post ne mentionne pas que le gain sur Telecom disparaît avec un autre simulateur de client.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.38620
- Le PDF : https://arxiv.org/pdf/2610.38620v1
- Le modèle de décision Kev : https://github.com/jaredpalmer/kev
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2116547247018229999
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/think-before-you-act-decision-gate-for-llm-agents-2610.38620