Titre original : Rethinking Verification in Agent Harnesses
Auteurs : Zhengxin Zhang (université Cornell, travail réalisé en stage chez Alibaba), Erkang Zhu, Yin Lin, Bolin Ding et Jingren Zhou (Alibaba Group), Claire Cardie (université Cornell)
Publication : prépublication arXiv 2610.34577v1 (cs.AI), déposée le 25 octobre 2026, 9 pages de texte principal et 65 pages avec les annexes.
Liens : page arXiv, PDF.
L’idée en bref
Un agent de code travaille dans un harnais : la boucle qui lui donne des outils, exécute ses commandes et lui renvoie les résultats. Une partie de ce harnais sert à vérifier le travail avant de l’accepter. Claude Code propose des crochets de vérification en fin de tâche, Codex fait relire et itérer, mais ces choix reposent surtout sur l’expérience des équipes. Les auteurs mesurent systématiquement quand intervenir, qui doit vérifier et comment la vérification mène à une correction.
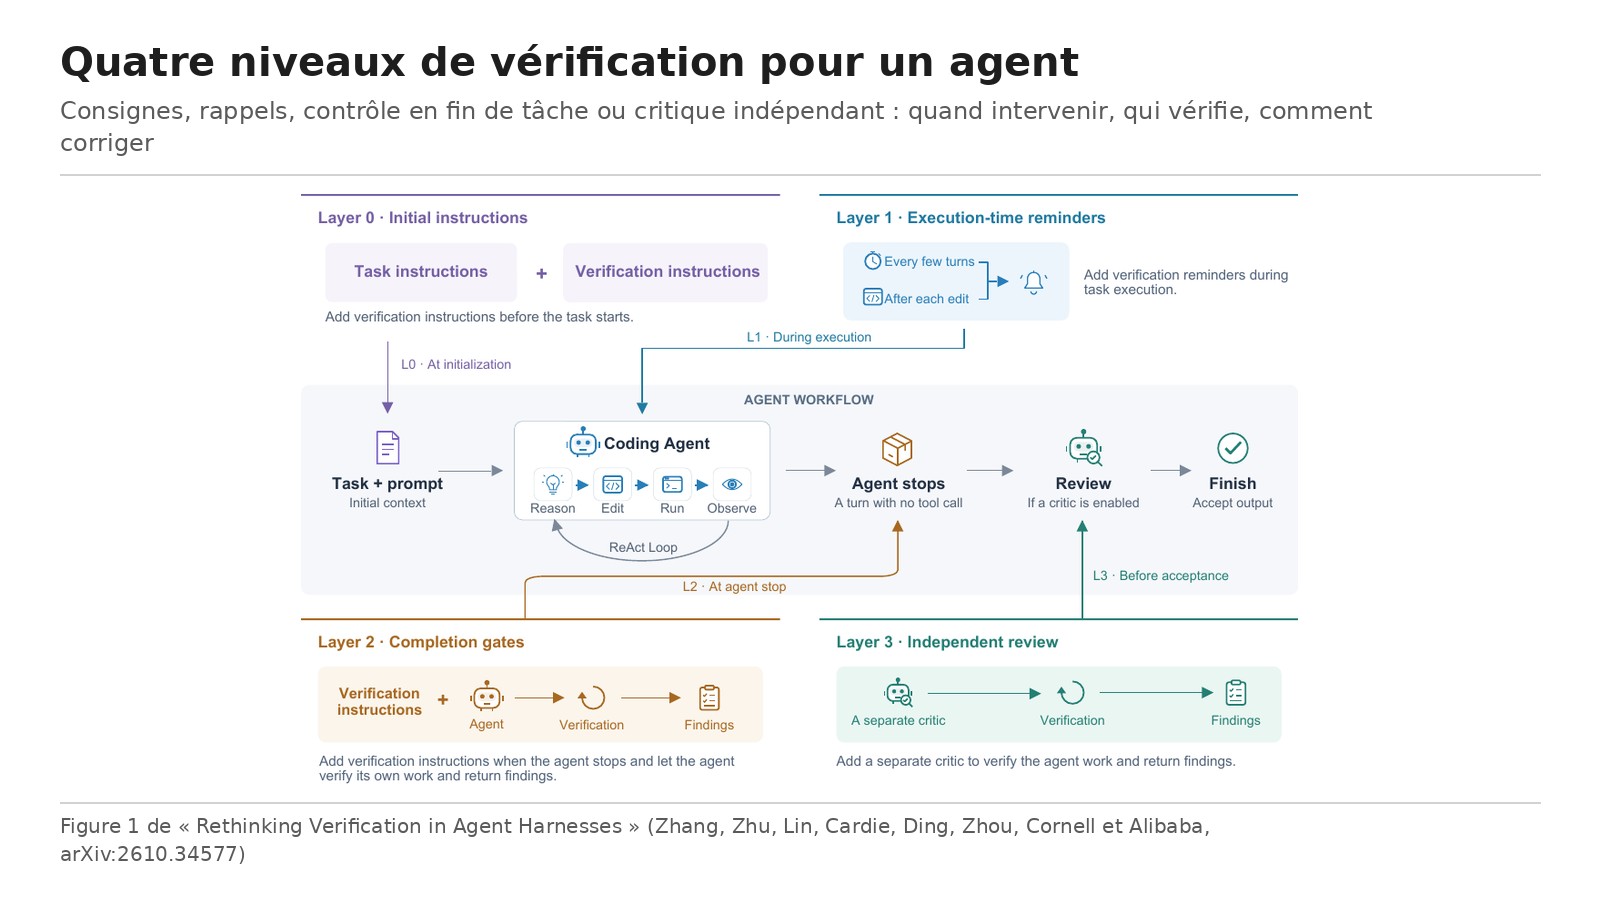
Ils rangent les options en quatre niveaux. Au niveau 0, on ajoute des consignes de vérification au départ. Au niveau 1, on envoie des rappels pendant l’exécution, par exemple après chaque modification de fichier. Au niveau 2, on rouvre le travail quand l’agent veut s’arrêter, pour qu’il se relise ou continue. Au niveau 3, un critique séparé, qui démarre avec un contexte neuf, vérifie le livrable et renvoie ses remarques à l’agent (section 3 et figure 1).
Ce que montre le papier
Un banc d’essai large
Les 17 variantes sont testées sur sept modèles de code accessibles via la plateforme d’Alibaba Cloud : Qwen3.7-Max, Qwen3.8-Max, GLM-5.2, DeepSeek V4-Pro, DeepSeek V4-Flash, Kimi-K2.7-Code et MiniMax-M2.5. Le critique est toujours Qwen3.7-Plus, un modèle moins cher. Les tâches viennent de Terminal-Bench 2.1 (31 tâches retenues sur 89) et de SWE-bench Verified (une trentaine de tâches choisies par niveau de difficulté), avec trois essais par modèle et par tâche. S’y ajoute VisualBench, un banc interne de 18 tâches visuelles et interactives (jeu jouable, configurateur 3D, explorateur de données), jugé à l’aveugle par des évaluateurs de l’entreprise (section 4 et annexe A.1).
Consignes et rappels : peu d’effet, peu de coût
Une consigne de vérification dans le prompt système ajoute 3,3 points en moyenne sur Terminal-Bench et 3,9 sur SWE-bench, contre 1,2 et −1,1 quand la même consigne est placée dans le message de l’utilisateur. Les effets varient beaucoup selon le modèle : MiniMax-M2.5 gagne 12,6 points sur SWE-bench, Qwen3.8-Max en perd 2,3 (section 5.1 et tableaux 2 et 3). Les rappels après modification de fichier donnent des gains comparables tout en réduisant les jetons produits de 14 à 25 % sur Terminal-Bench. Les auteurs avaient relevé qu’à la base, seuls 6,2 à 13,6 % des tours d’édition sont suivis d’une commande de vérification (section 3). Sur VisualBench, ces deux niveaux font légèrement moins bien que l’agent de base (−3,2 points de préférence nette).
L’autocontrôle en fin de tâche coûte cher
Refuser la fin de tâche et demander à l’agent de continuer donne les meilleurs gains du niveau 2 : jusqu’à 6,0 points sur Terminal-Bench et 6,2 sur SWE-bench quand le refus intervient tôt. Mais les variantes de refus coûtent 1,60 à 1,76 fois le coût de base sur Terminal-Bench et 1,48 à 1,56 fois sur SWE-bench (section 5.3). Rouvrir le travail ne garantit pas un meilleur résultat : un agent relancé peut casser une solution juste, comme Kimi-K2.7-Code qui laisse des contenus de test dans des branches livrées et échoue.
Le critique séparé, meilleur rapport qualité-prix
Les quatre variantes de critique indépendant améliorent la précision moyenne de 5,9 à 9,5 points sur Terminal-Bench et de 3,9 à 6,6 sur SWE-bench, pour 1,13 à 1,25 fois et 1,00 à 1,04 fois le coût de base, revue et corrections comprises. La meilleure sur ce banc, une revue qui part des exigences de la tâche et reçoit aussi la trajectoire de l’agent, fait passer Terminal-Bench de 55,1 % à 64,6 % (section 5.4). Sur VisualBench, les quatre variantes l’emportent nettement, avec une préférence nette de 13,2 à 23,8 points. Sur l’ensemble des trois bancs, donner au critique toute la trajectoire de l’agent n’améliore pas régulièrement le résultat, alors que cela coûte 29 à 43 % de plus en critique. Les auteurs recommandent donc de ne lui transmettre par défaut que les exigences de la tâche et les modifications. Les exemples sont parlants : sur une migration d’un programme COBOL vers Python, le critique teste un résultat négatif que l’agent n’avait pas essayé et découvre que Python écrit un signe moins là où le champ COBOL, non signé, n’en a pas. L’agent reproduit l’écart, corrige le format et passe le correcteur externe, ce que la version sans critique ne fait pas.
Plus de relectures, un peu mieux encore
Sur Terminal-Bench, un critique et un tour atteignent 62,7 % ; deux tours, 65,6 % ; quatre tours, 66,1 % ; quatre critiques en parallèle, 65,8 %. Quatre critiques font gagner 3,1 points sur un seul pour 1,33 fois le coût total, et approchent le résultat de quatre tours pour 19 % de coût en moins (section 5.4, figure 4 et annexe).
Les limites
Le papier n’a pas de section consacrée aux limites. Il signale lui-même que :
- les gains des niveaux 0 et 1 dépendent fortement du modèle et du banc d’essai, avec des reculs pour certains modèles ;
- un critique peut confirmer un défaut sans que l’agent parvienne à le corriger dans le temps imparti, comme sur une tâche de nettoyage asynchrone interrompue au bout de 45 minutes.
Réserves de notre lecture, tirées du papier :
- Les échantillons sont petits : 31 tâches Terminal-Bench et une trentaine de tâches SWE-bench, sélectionnées pour couvrir plusieurs niveaux de difficulté. Un écart d’un ou deux points correspond à peu de tâches.
- Tous les modèles passent par la plateforme d’Alibaba, le critique est un modèle Qwen et les coûts sont calculés avec les tarifs de cette plateforme (annexe A.2).
- VisualBench est un banc interne et ses évaluateurs appartiennent à une équipe de l’entreprise ; il n’est pas public.
- Aucun modèle de pointe américain (Claude, GPT, Gemini) n’est testé comme agent.
- Le papier ne mentionne pas de publication du code ou des données.
Lecture Neurone21
Pour une équipe qui met des agents de code en production, la recommandation est simple à appliquer : plutôt que d’allonger le prompt avec « vérifie ton travail » ou de forcer l’agent à se relire indéfiniment, faire relire le livrable par un second modèle, moins cher, qui ne voit que la consigne et le diff, avec accès à l’environnement pour lancer ses propres tests. C’est l’équivalent d’une revue de code par un collègue qui n’a pas suivi le raisonnement de l’auteur, et qui teste donc les cas oubliés. Dans le protocole, le critique a une règle de non-modification : il renvoie ses constats, et c’est l’agent qui corrige.
Le résultat intéresse aussi les projets d’IA locale : le critique peut être un modèle plus petit que l’agent principal, et la revue sur SWE-bench ne coûte presque rien de plus. Cette fiche complète celle sur HarnessMM, qui traque les appels inutiles dans le harnais, celle sur les pannes d’outils MCP et celle sur les échecs de délégation recensés par Microsoft Research, publiée le même jour, où les utilisateurs disent vérifier eux-mêmes ce que l’agent prétend avoir fait.
Le post de DAIR.AI, relayé par Elvis Saravia, reprend fidèlement les chiffres du résumé : 5,9 à 9,5 points sur Terminal-Bench pour 1,13 à 1,25 fois le coût, 3,9 à 6,6 points sur SWE-bench, et un gain supplémentaire avec davantage de relectures (3,4 points avec quatre tours dans le papier). Deux nuances : le meilleur gain du niveau 2 sur SWE-bench (6,2 points) est presque aussi bon que celui du critique (6,6), à un coût plus élevé, et le post ne dit pas que les tâches sont des sous-ensembles d’une trentaine de tâches, ni que VisualBench est un banc interne.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.34577
- Le PDF : https://arxiv.org/pdf/2610.34577v1
- Le post de DAIR.AI relayé par Elvis Saravia : https://x.com/dair_ai/status/2115101219119325606
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/rethinking-verification-in-agent-harnesses-2610.34577