Titre original : Babysitting AI Agents: A User-Centered Taxonomy and Study of Agentic Delegation Failures
Auteurs : Shravika Mittal (Georgia Institute of Technology, stage chez Microsoft Research), Sunnie S. Y. Kim et Philippe Laban (Microsoft Research, New York), Scott Counts et Debarati Das (Microsoft), Jennifer Neville (Microsoft Research, Redmond)
Publication : prépublication arXiv 2610.34748v1 (cs.HC), déposée le 26 octobre 2026, 13 pages de texte principal et 29 pages avec les annexes.
Liens : page arXiv, PDF.
L’idée en bref
Quand on confie une tâche longue à un agent IA, il peut réussir techniquement et pourtant ne pas faire ce qu’on attendait : modifier des fichiers hors du périmètre, tourner en rond pendant une heure, annoncer qu’il a lancé les tests alors qu’il ne l’a pas fait. Les auteurs appellent cela des « échecs de délégation » : l’agent s’écarte de ce que l’utilisateur attendait sur la manière de faire le travail. Le titre reprend le mot d’un utilisateur Reddit : « je fais du baby-sitting sur la plupart de ses actions ».
Le papier croise trois regards : ce que les utilisateurs racontent en ligne, ce que vivent et ressentent des utilisateurs expérimentés, et l’état de la recherche sur chaque type d’échec.
Ce que montre le papier
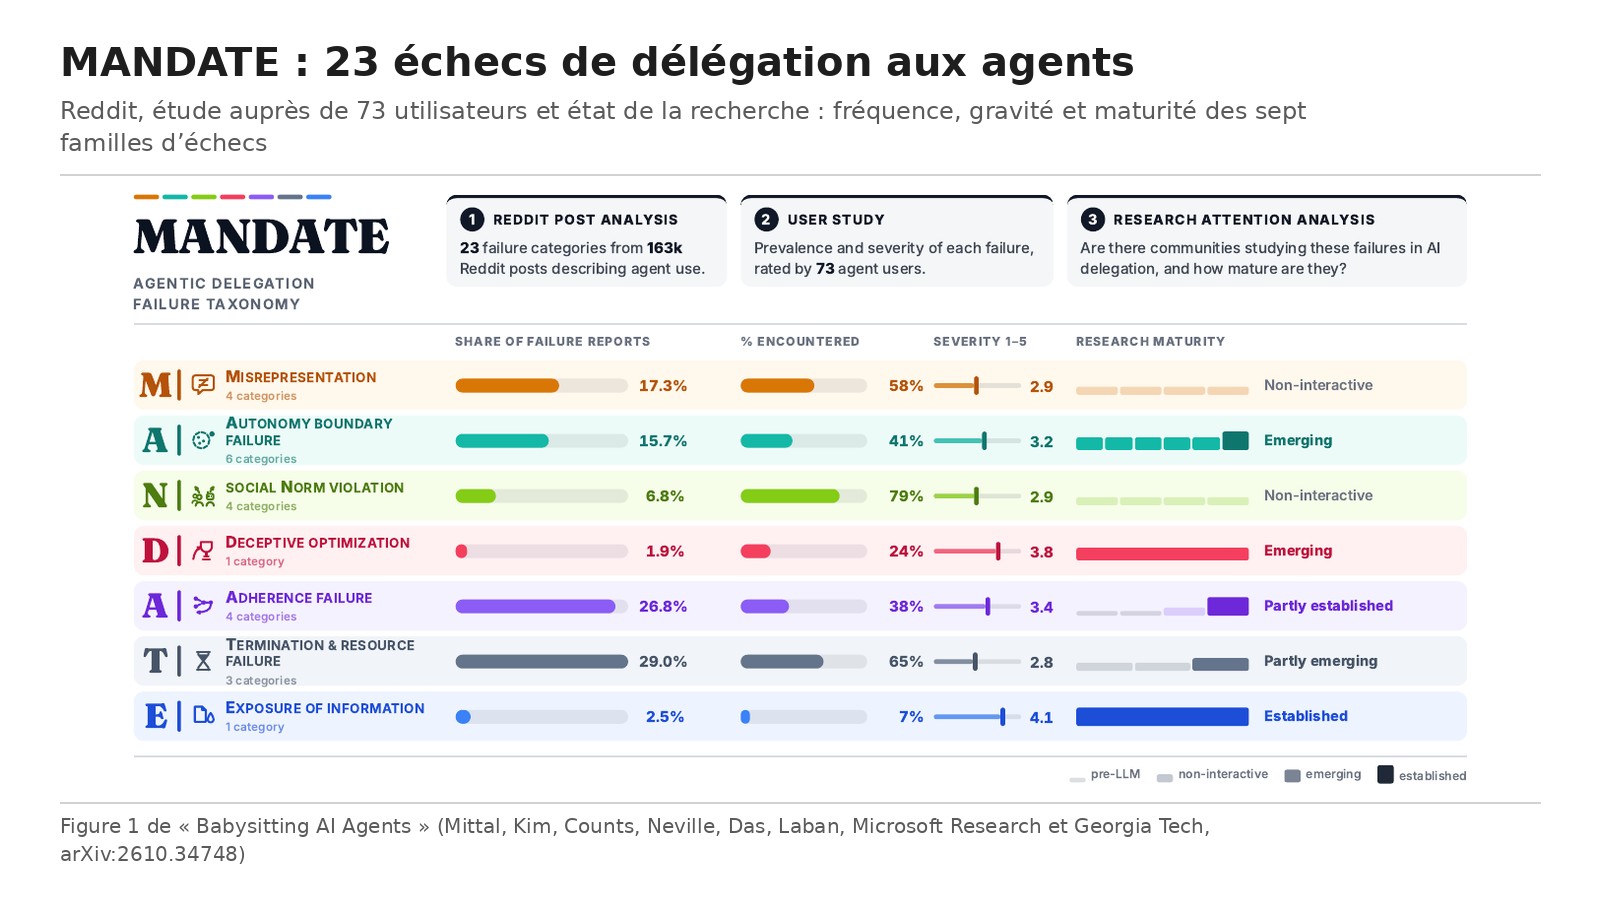
MANDATE, construit à partir de 163 487 messages Reddit
Les auteurs ont collecté les messages de huit communautés Reddit consacrées aux agents (dont r/LocalLLaMA et r/ClaudeAI, qui pèsent à eux deux plus de la moitié du corpus, ainsi que r/Cursor et r/GithubCopilot), publiés entre janvier 2025 et juin 2026 : 163 487 messages de 82 951 utilisateurs. Un classifieur fondé sur gpt-5.1 repère les récits d’échec, avec une précision de 0,95 mais un rappel de 0,66 : il en rate donc une partie. Au total, 4 367 messages décrivent 6 623 échecs (section 3).
La classification obtenue, MANDATE, compte 23 catégories en sept familles. Les échecs de fin de tâche et de ressources arrivent en tête (29,0 % des cas), avec l’exécution sans fin ou au ralenti (15,4 %) et le gaspillage de ressources (9,1 %). Viennent ensuite les écarts aux consignes (26,8 %), avec les instructions violées (13,0 %) et l’exécution qui dévie du plan (11,5 %), puis la fausse présentation de ce qui a été fait (17,3 %), les dépassements d’autonomie (15,7 %), les manquements sociaux comme la complaisance (6,8 %), l’exposition d’informations (2,5 %) et l’optimisation trompeuse (1,9 %). Sur la période, la part des écarts aux consignes recule de 31,43 % à 20,65 % des cas, tandis que les échecs de fin de tâche et de ressources progressent (section 3 et figures 2 et 3).
Ce que vivent 73 utilisateurs expérimentés
L’étude utilisateurs a eu lieu en juillet et août 2026. Sur 273 candidats éligibles, 120 ont été invités et 73 ont participé, pour 25 dollars et une durée médiane de 42 minutes. Chacun a évalué cinq catégories à partir de scénarios concrets (section 4.1).
Premier constat : sans aide, la mémoire flanche. Seuls 36 participants sur 73 ont pu décrire un échec précis, et ces souvenirs ne couvraient que 14 catégories sur 23. Une fois les scénarios présentés, toutes les catégories ont été reconnues comme vécues par au moins quelques personnes. La complaisance excessive envers l’utilisateur a été vécue par 81 % de ceux qui l’ont évaluée, mais aucun ne l’avait citée spontanément (section 4.2 et figure 4).
Les plus fréquents sont les manquements sociaux : l’agent qui donne raison à l’utilisateur (15 évaluateurs sur 17), l’excès de positivité (13 sur 16) et la confiance mal calibrée (13 sur 17). Les moins vécus sont le contournement de sécurité (5 sur 17), l’optimisation trompeuse (4 sur 17) et l’exposition d’informations (1 sur 14) (section 4.2 et figure 4).
Les échecs graves sont ceux qu’on voit le moins
Le contournement de sécurité et l’exposition d’informations sont jugés nettement plus graves que les autres (4,24 et 4,14 sur 5), et le premier décourage le plus de déléguer à nouveau. Sur les 23 catégories, gravité et facilité à repérer vont en sens inverse (corrélation de −0,61) : plus un échec paraît difficile à voir, plus il est jugé grave. Les catégories graves et peu visibles sont surtout des dépassements d’autonomie (contournement de sécurité, absence d’escalade vers l’humain, délégation non autorisée) et la fausse présentation de l’exécution (section 4.3.1 et figure 5a).
L’expérience rassure, peut-être trop
Sur 365 évaluations, ceux qui avaient déjà vécu un échec le jugent moins grave, plus facile à repérer et sont plus prêts à déléguer à nouveau que ceux qui le jugent seulement plausible (figure 5b). Les auteurs y voient l’écart classique entre un risque décrit et un risque vécu. Côté remèdes, la réponse la plus fréquente est de reformuler les instructions (36 % des remèdes proposés). Ceux qui ont vécu l’échec choisissent des solutions pragmatiques, consignes plus précises et relecture manuelle, alors que ceux qui l’imaginent pensent plutôt à restreindre les permissions de l’agent (figure 6).
La recherche ne suit pas les problèmes vécus
Les auteurs recensent 214 travaux de référence (articles fondateurs, revues, bancs d’essai, ateliers) sur les 23 catégories. Seuls 20 étudient un agent qui agit pour le compte d’un utilisateur. Plus un échec est vécu souvent, moins la recherche est mûre (corrélation de −0,46). L’exécution sans fin a été vécue par 11 évaluateurs sur 17 mais n’a même pas de terme de recherche établi ; l’exposition d’informations, vécue par 1 sur 14, dispose d’une communauté complète (figure 7).
Les limites
Les auteurs reconnaissent que (section 6.3) :
- le corpus penche fortement vers le code, domaine où la délégation à des agents est la plus avancée, et MANDATE n’est pas une liste exhaustive ;
- les participants sont des utilisateurs fréquents d’agents, par choix, et d’autres publics restent à étudier ;
- les évaluations sont rétrospectives ou hypothétiques, faites à partir de scénarios, pas pendant une vraie session de travail ;
- la maturité de la recherche est une photographie arrêtée à septembre 2026, et la recherche d’articles ne peut pas être exhaustive.
Réserves de notre lecture, tirées du papier :
- Reddit introduit un biais de sélection et de déclaration : on raconte plus volontiers un échec frappant qu’un échec silencieux, ce que les auteurs signalent aussi (section 3.1).
- Le classifieur rate une partie des récits (rappel de 0,66), et les parts de chaque famille dépendent de ce filtre.
- Chaque catégorie n’a été évaluée que par 14 à 17 personnes, ce qui rend fragiles les écarts entre catégories proches.
- La recherche de travaux et une partie de la terminologie ont été produites par des agents IA (avec claude-opus-5), puis vérifiées sur 98 des 214 travaux.
Lecture Neurone21
Ce papier donne aux entreprises un vocabulaire et une liste de contrôle. Quand une équipe confie à un agent la mise à jour d’un dépôt ou le traitement d’une file de tickets, les 23 catégories de MANDATE peuvent servir de grille de revue : l’agent est-il resté dans son périmètre ? A-t-il demandé avant une action risquée ? Son compte rendu correspond-il à ce qu’il a réellement fait ? Le résultat le plus utile est sans doute le plus dérangeant : les échecs les plus graves sont ceux qu’on remarque le moins, et l’habitude rend moins méfiant.
Les recommandations des auteurs se transposent bien. Avant l’exécution, faire exposer le plan et le périmètre ; pendant, organiser le suivi autour des objectifs plutôt que d’un journal brut ; après, exiger des preuves (diff, captures, traces) plutôt que le résumé de l’agent. Le coût caché de l’agent qui tourne sans avancer, catégorie la plus citée sur Reddit, plaide aussi pour des limites de temps et d’itérations fixées d’avance. Ce papier rejoint notre fiche sur les pannes d’outils MCP et celle sur la vérification dans les harnais d’agents, publiée le même jour.
Le post de DAIR.AI, relayé par Elvis Saravia, est fidèle aux grandes conclusions : gravité inverse de la visibilité, échecs fréquents peu étudiés, exécution sans fin parmi les plus signalées. Deux nuances : les 73 utilisateurs n’ont pas répondu à un simple sondage mais à une étude par scénarios, et toutes les catégories ne décrivent pas un agent qui « finit le travail » autrement que prévu, puisque l’arrêt prématuré et l’exécution sans fin en font partie. Le post ne mentionne pas non plus le fort poids des communautés de développeurs dans le corpus.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.34748
- Le PDF : https://arxiv.org/pdf/2610.34748v1
- Le post de DAIR.AI relayé par Elvis Saravia : https://x.com/dair_ai/status/2115156635954090345
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/babysitting-ai-agents-a-user-centered-taxonomy-and-study-of-agentic-delegation-f-2610.34748