Titre original : Tool-Calling LLM Agents Under Realistic MCP Faults: Scale Does Not Purchase Fault Tolerance
Auteurs : Antonio Ken Iannillo et Kristina Kudryavtseva (SnT, université du Luxembourg), Joshua Segun Owotogbe et Indika Kumara (université de Tilburg), Roberto Natella (Gran Sasso Science Institute), Francesco Avallone (université de Naples Frédéric-II)
Publication : prépublication arXiv 2610.32555v1 (cs.SE), déposée le 23 octobre 2026, acceptée à NeurIPS 2026 (poster). 10 pages de texte principal, 35 pages avec les annexes.
Liens : page arXiv, PDF, code et données.
L’idée en bref
Les agents IA agissent de plus en plus à travers des outils exposés par le Model Context Protocol (MCP), le standard qui relie un modèle à des services externes. Or les bancs d’essai supposent que ces outils répondent toujours, à temps et correctement. En production, c’est faux : un serveur renvoie une erreur, met trente secondes à répondre, ne répond plus du tout, ou renvoie une valeur bien formée mais fausse.
L’équipe construit MCP-Injector, un intermédiaire qui se place entre l’agent et ses serveurs MCP sans modifier ni l’un ni les autres. Il injecte six types de pannes : petite erreur de caractère, mot remplacé, mauvais type de donnée, message d’erreur explicite, réponse retardée et silence total. Chaque panne peut être permanente, passagère ou intermittente. Pour que le mélange ressemble à la réalité, les auteurs ont analysé les tickets et demandes de modification de 1 774 dépôts de serveurs MCP open source (sections 3 et 4, p. 2 à 5).
Ce que montre le papier
Un profil de pannes tiré du terrain
Sur 103 166 fils de discussion collectés en septembre 2025, 57 240 restent après filtrage. GPT-4o les classe (pour environ 800 dollars d’API), et deux chercheurs vérifient un échantillon de 117 fils avec un accord élevé (kappa de Cohen de 0,93 pour le type de panne, 0,80 pour sa durée). Sur 14 829 pannes classées, 10 393 sont des erreurs explicites. Le profil injecté est donc dominé par les pannes permanentes (91,3 %), et l’erreur explicite permanente pèse à elle seule 65,6 % des tirages (section 4 et tableau 2, p. 4 et 5).
Un plan d’expérience complet
L’étude croise deux modèles open source (gpt-oss-20B et gpt-oss-120B), trois cadres d’agent (la boucle « planifier puis exécuter » de MCP-Bench, OpenAI Agents SDK et LangChain), trois conditions (sans intermédiaire, intermédiaire neutre, pannes calibrées), 25 tâches et trois graines : 1 350 exécutions au total. Les modèles tournent en local sur une machine Apple Silicon grand public via LM Studio, avec une fenêtre de contexte de 16 000 jetons. Un juge gpt-4o-mini note chaque exécution cinq fois (section 5, p. 5 et 6).
Une chute de qualité massive, rarement visible comme un plantage
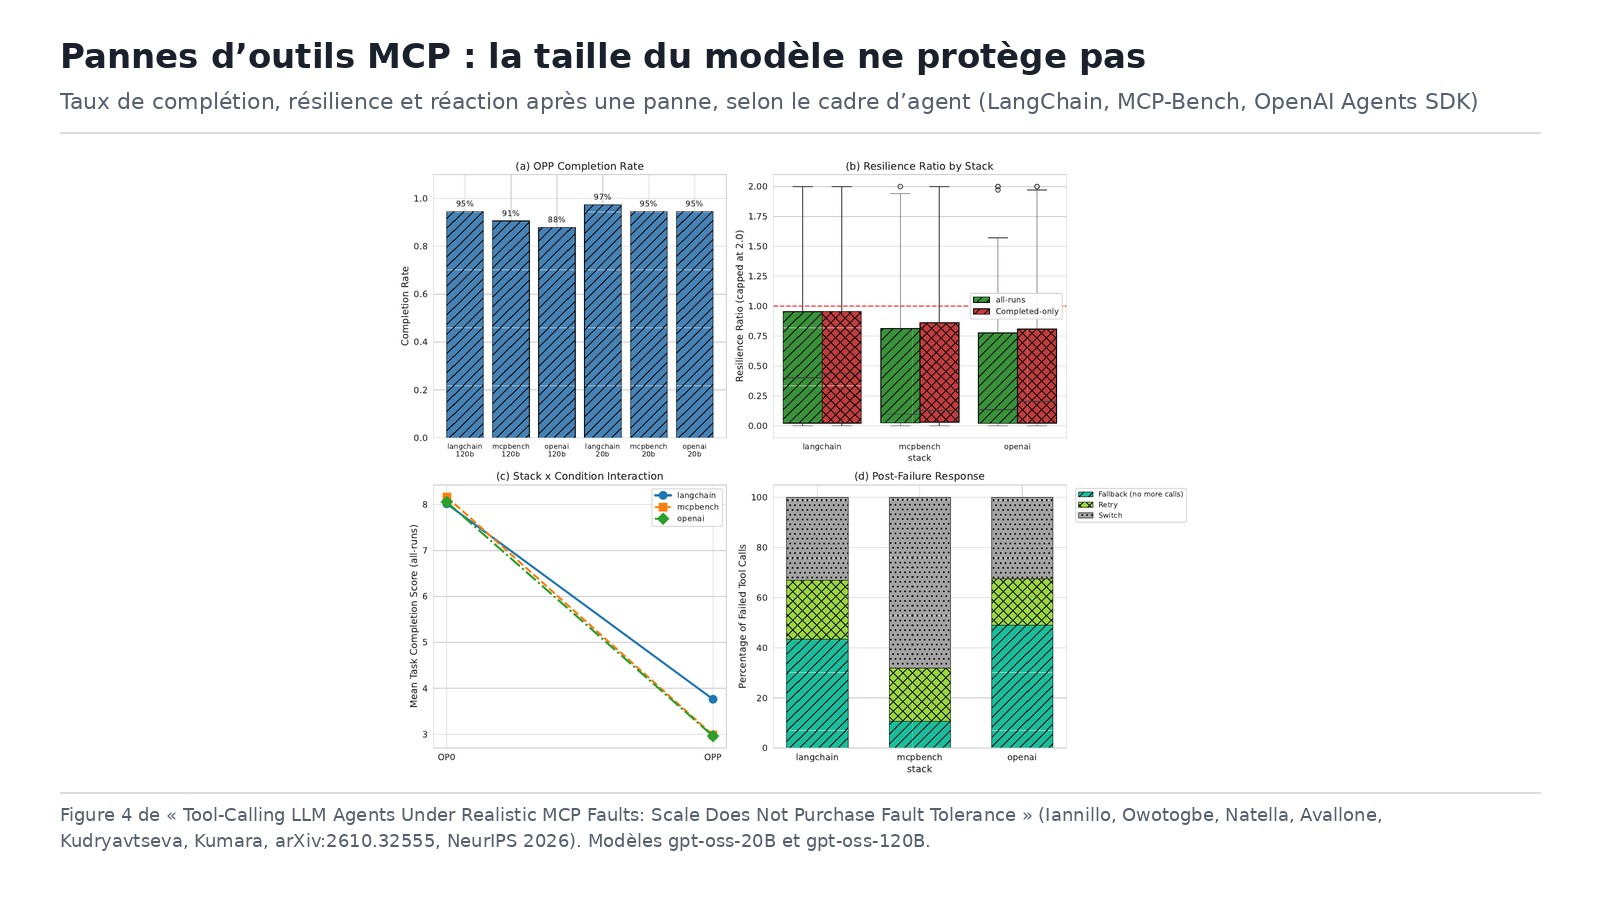
Sur les 450 exécutions avec pannes comparées à leur jumelle sans panne, le score d’accomplissement de la tâche passe de 8,08 à 3,23 sur 10, soit 60 % de baisse. Le choix des outils perd 59 %, l’efficacité de la planification 67 %. Pourtant les agents terminent encore 88 % à 97 % des tâches : le cas le plus fréquent (56 % des exécutions) est une dégradation partielle, une réponse livrée mais nettement moins bonne. En ne gardant que les exécutions terminées dans les deux conditions, la baisse reste de 57 % (section 6.1, p. 6).
Des réponses inventées qui flattent le score
Dans 6,0 % des exécutions avec pannes, l’agent rend une réponse plausible sans s’appuyer sur les outils. Un agent LangChain avec gpt-oss-120B a ainsi fait toutes les conversions d’unités de tête et obtenu 9,8 sur 10 pour l’accomplissement, mais 1,2 pour le bon usage des outils. Ce comportement existe aussi sans panne. En ne comptant que les réponses appuyées sur les outils, la baisse atteint 63 % (section 6.1, p. 7).
La taille ne protège pas
Sans panne, les deux modèles ont un niveau proche (8,37 contre 8,13). Avec pannes, la part de son propre niveau que garde le 120B n’est pas meilleure que celle du 20B : le coefficient lié à la taille vaut −0,009, avec un intervalle de −0,39 à 0,37 (p = 0,96). Le 120B termine même un peu moins de tâches (91,1 % contre 95,6 %), mais l’écart n’est pas significatif (intervalle de −0,2 à 9,3 points) et la moitié existe déjà sans panne. Quand il termine, ses réponses sont un peu mieux notées (3,68 contre 3,26). Il reçoit aussi plus de pannes par exécution (4,6 contre 3,9) et ses échecs sous pannes (20 contre 10) sont presque tous des dépassements du délai de 3 000 secondes (section 6.3, p. 8 et 9).
Le cadre d’agent pèse davantage, sans certitude
LangChain termine le plus de tâches sous pannes (95 % à 97 %), OpenAI Agents SDK le moins (88 % à 95 %). Par rapport à LangChain, MCP-Bench perd 0,93 point de plus (p = 0,048) et OpenAI 0,84 (p = 0,074). Les réactions diffèrent : MCP-Bench change d’outil après une panne, LangChain et OpenAI abandonnent plus souvent la boucle d’outils qu’ils ne réessaient. La fragilité dépend aussi beaucoup de la tâche : −97 % pour une tâche qui dépend d’une API en direct, −19 % pour un convertisseur d’unités (sections 6.2 et 6.3, p. 7 à 9).
Les limites
Les auteurs reconnaissent que (section 7, p. 9) :
- le juge automatique reste aléatoire malgré cinq notations, et sa grille récompense certaines réponses non fondées ;
- les tickets GitHub surreprésentent les pannes persistantes et reproductibles, d’où un profil à lire comme un test de stress, pas comme un taux de panne réel ;
- les pannes passagères et intermittentes n’ont presque pas été déclenchées (9 événements sur 1 905) ;
- la fenêtre de 16 000 jetons partagée et le volume d’appels d’outils, différent selon les cadres, sont des explications aussi plausibles que l’exposition aux pannes ;
- les deux modèles viennent d’une seule famille et d’une seule configuration de service, MCP-Bench est facile sans panne, et les 25 tâches n’utilisent qu’un serveur à la fois.
Réserves de notre lecture, tirées du papier :
- « La taille ne protège pas » vaut pour gpt-oss-20B et gpt-oss-120B servis localement avec un contexte réduit. Les auteurs écrivent eux-mêmes que l’intervalle est large et n’exclut pas un effet modeste dans un sens ou dans l’autre.
- L’avantage de LangChain repose sur une interaction significative à p = 0,048 et une autre marginale, sans correction pour comparaisons multiples ; MCP-Bench reçoit en plus 8,6 pannes par exécution contre 2,3 pour LangChain. Les auteurs parlent d’un indice, pas d’un résultat établi.
- Le papier ne teste aucune parade (relance avec délai, outil de secours, message d’erreur reformulé) : il mesure la fragilité, pas les remèdes.
Lecture Neurone21
Pour une entreprise qui branche un agent sur ses outils internes via MCP, le message est direct : vos tests où tout répond bien disent peu de chose de la production. Le plus inquiétant n’est pas le plantage, facile à voir, mais la réponse livrée à temps et dégradée, voire inventée sans consulter l’outil. Un agent qui calcule un devis de tête parce que l’API tarifaire ne répond pas rend un chiffre crédible et faux.
La conséquence pratique est double. D’abord, ajouter de l’injection de pannes aux tests avant mise en service : erreurs, lenteurs, silences et valeurs fausses, avec l’outil des auteurs, publié en open source, ou un simple intermédiaire maison. Ensuite, investir dans la gestion d’erreurs du cadre d’agent (délais, relances, réponse explicite « outil indisponible ») plutôt que dans un modèle plus gros. Pour les projets d’IA locale, qui tournent souvent avec des modèles moyens, c’est plutôt une bonne nouvelle : l’effort se place dans l’encadrement de l’agent, pas dans la course à la taille. Ce papier complète notre fiche sur les agents multimodaux qui refusent moins avec des outils et celle sur HarnessMM, publiée le même jour, qui montre aussi que le harnais compte autant que le modèle.
Le post vient du compte DAIR.AI, relayé par Elvis Saravia. Il reprend fidèlement les chiffres clés (57 240 fils, 1 774 dépôts, 8,08 à 3,23, 91,1 % contre 95,6 %), mais force deux conclusions. Il écrit que le grand modèle « garde une plus petite part » de son niveau (p = 0,96) : le papier dit seulement qu’il n’en garde pas une plus grande, l’écart étant nul en pratique. Il affirme aussi que les écarts entre cadres d’agent sont plus grands que l’écart de taille, quand le papier présente cet effet comme suggestif et non établi. Enfin, les « 1 350 exécutions » incluent les conditions sans panne : la baisse de 60 % est calculée sur 450 exécutions avec pannes.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.32555
- Le PDF : https://arxiv.org/pdf/2610.32555v1
- Le code et les données : https://gitlab.com/uniluxembourg/snt/sedan/papers/mcp-injector
- Le post de DAIR.AI relayé par Elvis Saravia : https://x.com/dair_ai/status/2114735562716545201
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/tool-calling-llm-agents-under-realistic-mcp-faults-scale-does-not-purchase-fault-2610.32555